01学完你能做到
把全部 7 个模块串成一张图;把「越狱、最小权限、人在回路」和前面讲过的安全手段放进同一个分层框架。
这是最后一节,分两半:前半节把 Agent 安全的几块拼起来,后半节把 40 节课串成一张知识地图。
02越狱:冲着模型自身的安全规则
第 11、12 讲讲过,模型经过 RLHF、DPO、Constitutional AI 等对齐训练,学会拒绝有害请求。Constitutional AI 的做法是:用一份原则清单代替大量人工标注,先让模型按原则自我批评、修改回答,再用 AI 的偏好做强化学习(RLAIF)。论文说,这样训练出的助手无害但不回避:面对有害请求,它会解释自己为什么反对,而不是简单地不理。
读全文还能看到几个细节:
- 人类输入压到极少:普通 RLHF 通常要几万条人类偏好标注;这篇论文在「无害」这一项上不用任何人类标注,只靠约十条量级的自然语言原则(实际写了 16 条,每次比较随机抽一条,作者发现这样比只用一条更稳)。「有用」这一项仍然用人类标注。
- 两个阶段:监督阶段,让模型针对红队提出的有害问题先回答、再按原则自我批评、再修改,用改后的回答微调;强化学习阶段,让模型按原则在两个回答中选更好的一个,用这些 AI 偏好训练偏好模型,再做强化学习。
- 可以用思维链:两个阶段都可以让模型先一步步写出推理,再做判断,判断过程对人更透明。
- 为什么要「不回避」:作者此前用人类反馈训练的模型,遇到敏感问题容易一味回避,回避本身被众包标注员当成了「无害」来奖励。
越狱(jailbreak)就是想办法让模型绕过这些训练出来的安全规则。OWASP LLM01:2025 把越狱看作提示注入的一种:攻击者的输入让模型完全无视它的安全协议。
| 越狱 | 一般的提示注入(第 39 讲(提示注入)) | |
|---|---|---|
| 攻击目标 | 模型自身的安全规则 | 开发者给应用设定的指令和权限 |
| 典型后果 | 输出本该拒绝的内容 | 泄露数据、越权调用工具 |
| 主要防线 | 模型层的对齐训练 + 应用层过滤 | harness 层的权限、隔离、审批 |
要点:对齐训练是第一道防线,但不是唯一一道。 第 39 讲(提示注入)说过,目前不清楚是否存在万无一失的防御,所以模型之外的防线不能省。
03最小权限
OWASP 的说法是:把模型的访问权限限制在完成任务最少必需的范围;API 令牌由应用代码掌握,不交给模型。
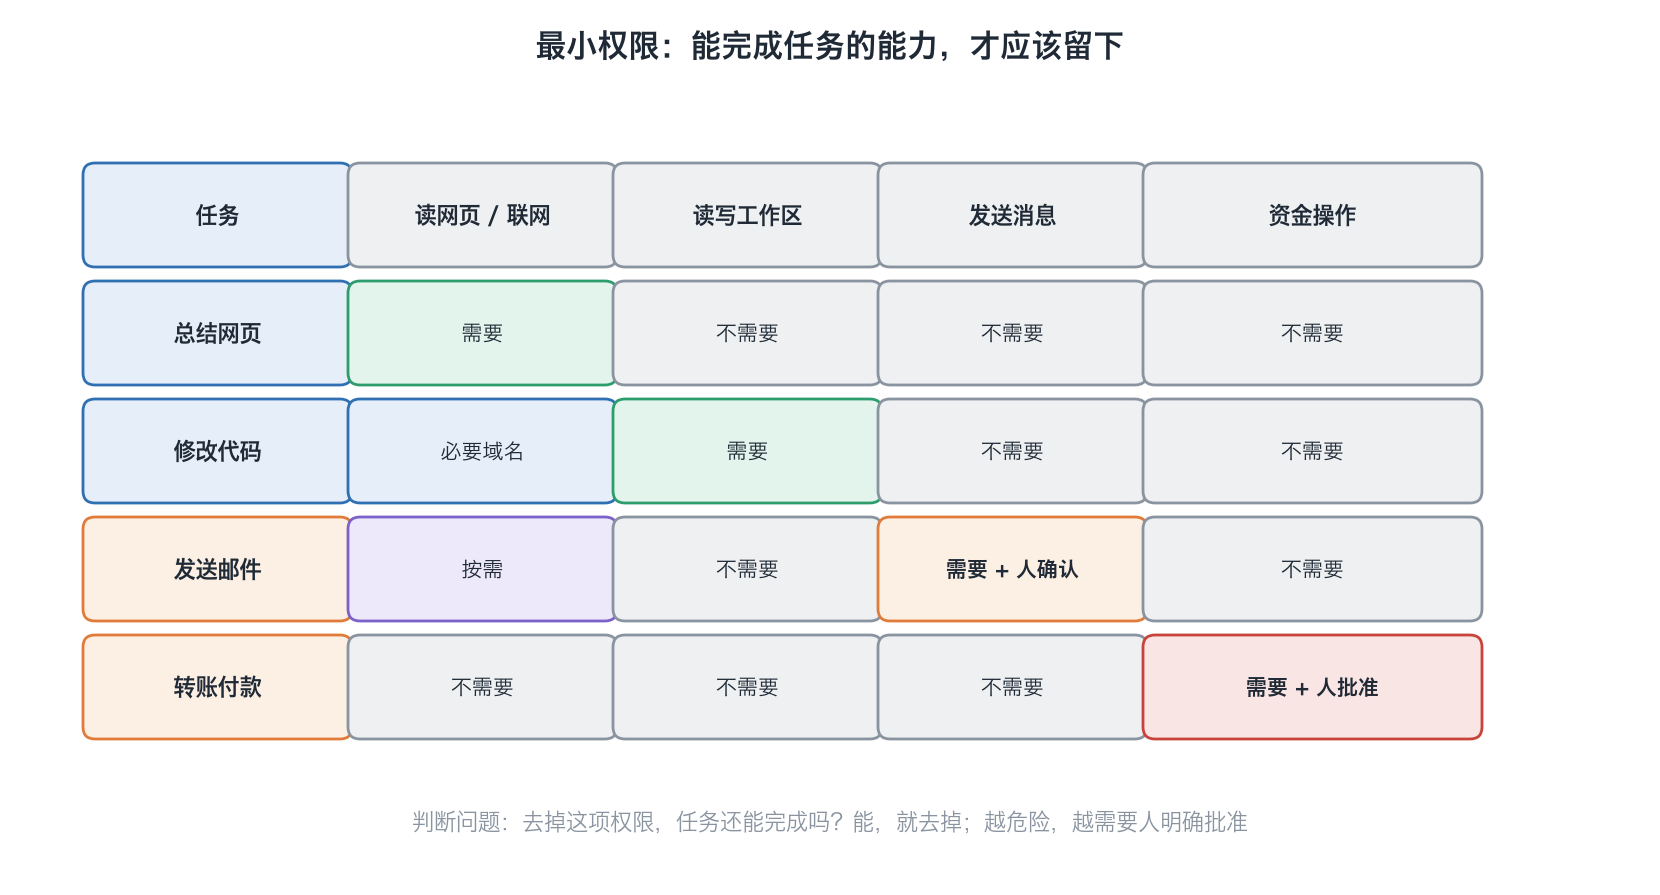
演示:给四个任务分配权限(示意)
- 总结网页:要读网页、要上网;不需要写文件,更不需要发消息;
- 改本仓库代码:要读写工作目录;联网只放行装依赖需要的域名(第 36 讲(权限、沙箱与错误恢复)的网络隔离);
- 发邮件:要能发消息,但每封都要人确认;
- 转账付款:动用资金必须人批准。
检查方法:对每一项权限问一句「去掉它,任务还能完成吗?」能完成就去掉。权限越少,被注入或出错时能造成的损失就越小。
04人在回路
人在回路(human-in-the-loop)是指在关键节点让人参与判断。前面几节分别从不同角度讲过它:
- Anthropic《Building effective agents》(第 28 讲(什么是 Agent)):Agent 可以在检查点或遇到阻碍时停下来等人反馈;自主性意味着更高的成本和错误累积,所以建议在沙箱环境里充分测试,并配上合适的护栏。文中还说,自动测试能验证功能,但人工审查对确认方案符合整体需求仍然很关键;
- 第 33 讲(MCP 与 A2A 协议):MCP 规范建议始终有人在回路里,能拒绝工具调用;
- 第 36 讲(权限、沙箱与错误恢复):每步都问人会造成审批疲劳,要按风险分级,只在越界或高风险时问;
- 第 39 讲(提示注入):OWASP 把「高风险操作要人批准」列为防注入措施之一。
合起来就是一句话:人的注意力是稀缺资源,要花在真正要紧的决定上。
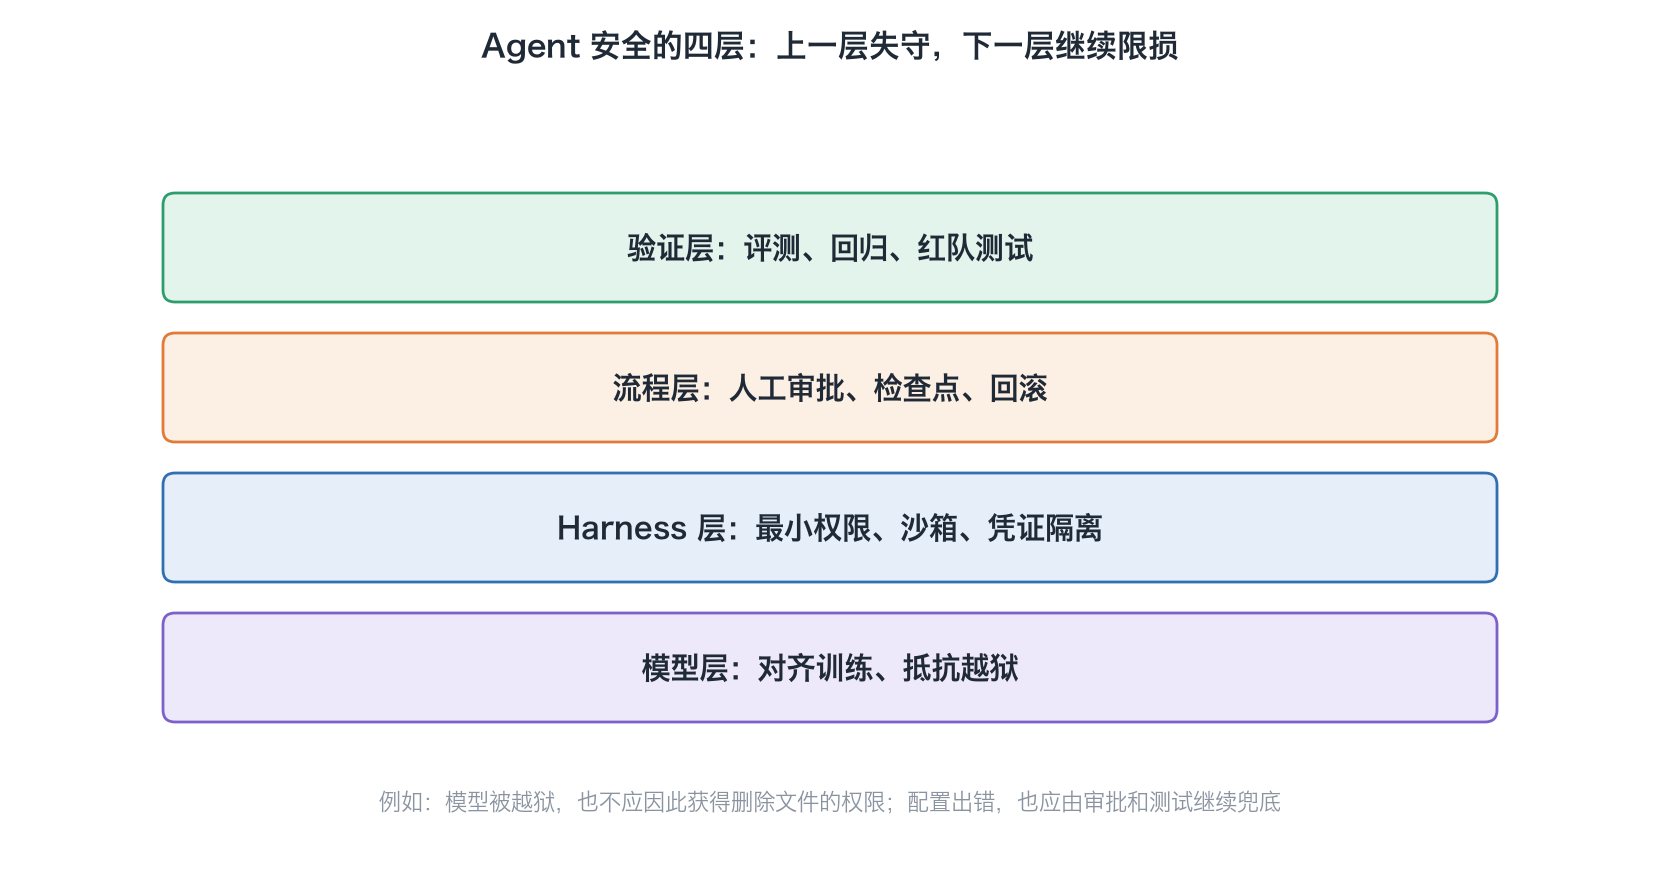
05Agent 安全的四层
| 层 | 做什么 | 对应的课 |
|---|---|---|
| 模型层 | 对齐训练,抵抗越狱和有害请求 | 第 11、12 讲 |
| harness 层 | 最小权限、沙箱、凭证不进沙箱、隔离外部内容 | 第 36、39 讲 |
| 流程层 | 高风险动作人在回路、检查点、回滚 | 第 35、36 讲 |
| 验证层 | 独立评估者、评测、回归测试、红队测试 | 第 36、37、38 讲 |
这和第 39 讲(提示注入)的「纵深防御」是同一个思路:上层失守时,下层还能兜底。 模型被越狱了,权限不够它也做不了大事;权限被滥用了,人工审批还能拦住;都漏过去了,评测和红队测试能在上线前发现。
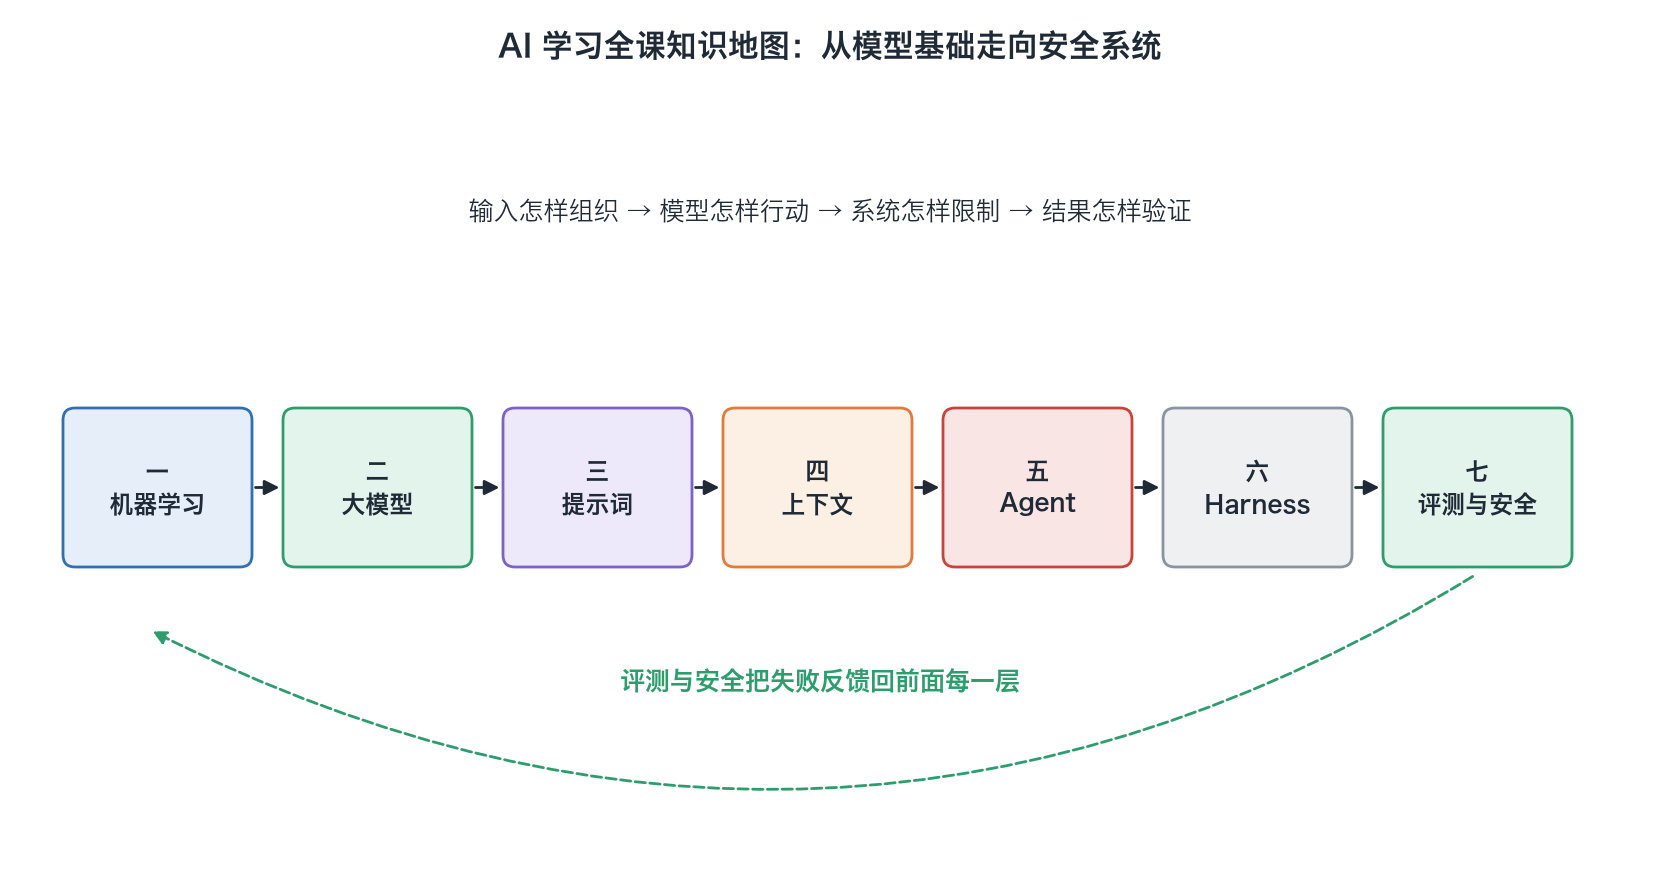
06全课知识地图
| 模块 | 节 | 一句话 | 和下一模块的关系 |
|---|---|---|---|
| 一 机器学习与神经网络基础 | 1–5 | 用损失函数衡量错误,用梯度下降和反向传播把错误变小 | 大模型的训练还是这一套 |
| 二 Transformer 与大模型原理 | 6–15 | 分词、注意力、Transformer;预训练 → SFT → RLHF/DPO 对齐;推理模型、解码、幻觉 | 模型只会根据输入预测下一个 token,所以「怎么问」很重要 |
| 三 提示词工程 | 16–21 | Zero/Few-shot、思维链、自洽性、思维树、自我改进、结构化输出 | 单条提示词装不下所有信息,于是要管理整个上下文 |
| 四 上下文工程 | 22–27 | 窗口有限、会腐化;用 RAG 取知识、用记忆跨会话、用压缩和隔离控制长度 | 有了好上下文,模型就能在循环里用工具做事 |
| 五 Agent 原理 | 28–33 | 工作流 vs 智能体;工具调用、ReAct、先规划后执行与反思、多智能体、MCP 与 A2A | 同样的模型,外面包的系统不同,效果差很多 |
| 六 Harness 工程 | 34–37 | Agent = 模型 + harness;长任务交接、权限沙箱、错误恢复、用 trace 迭代 | 改了 harness,要能量出来好不好、安不安全 |
| 七 评测与安全 | 38–40 | 基准、LLM 评委、Agent 评测;提示注入;越狱、最小权限、人在回路 | 回头指导前面每一层的改进 |
演示:用知识地图回答一个综合问题
问题:「一个能读网页、写代码的 Agent,有时会照着网页里的隐藏指令去删文件,怎么办?」按模块逐层排查:
- 模块二:模型只是在预测下一个 token,网页文字和用户指令对它来说都是输入(第 39 讲(提示注入)的根本原因);
- 模块四:网页内容进入上下文时要隔离、标记成外部内容;
- 模块五:删文件是一个工具调用,看工具的定义和权限,是不是本来就不该给;
- 模块六:沙箱只允许改工作目录,删除等高风险操作要人批准,有 git 检查点可以回滚;
- 模块七:把这类攻击写成红队测试用例,加进回归评测,以后每次改动都跑。
一个问题,用到了五个模块的知识。
07延伸阅读
- Bai et al., Constitutional AI: Harmlessness from AI Feedback, 2022:arxiv.org
- Anthropic, Building effective agents, 2024-12-19:anthropic.com
- OWASP, LLM01:2025 Prompt Injection:genai.owasp.org
08一分钟讲给别人
试着用自己的话讲一遍越狱是让模型绕过对齐训练出来的安全规则,OWASP 把它看作提示注入的一种。对齐训练(RLHF、DPO、Constitutional AI)是第一道防线,但不是唯一一道。最小权限是只给完成任务必需的权限,令牌放在代码里;人在回路是在检查点和高风险动作上让人做决定,但要分级,避免审批疲劳。Agent 安全分四层:模型层对齐,harness 层权限、沙箱和隔离,流程层人工审批和回滚,验证层评估者、评测和红队测试,上层失守时下层兜底。全课七个模块是一条链:机器学习基础 → Transformer 与大模型 → 提示词 → 上下文 → Agent → Harness → 评测与安全;最后一个模块反过来指导前面每一层的改进。
8 道自测
先在心里答一遍,再展开对照。能说清理由,比答对数字更重要。
01越狱和一般的提示注入有什么区别和联系?
02Constitutional AI 训练出的助手「无害但不回避」,是什么意思?
03怎么检查一个 Agent 有没有多给权限?
04人在回路为什么要分级,不能每步都问?
05Agent 安全分哪四层?各举一个手段。
06为什么说对齐训练做得再好,harness 层的防线也不能省?
07用一句话说出相邻两个模块之间的关系,任选三对。
08一个客服 Agent 偶尔被用户诱导,承诺了不存在的退款政策。用知识地图分析可以从哪些层改进。
已看 0/8 题
练动手练习
选一个“读网页并生成回复”的 Agent,画出模型、上下文、工具、harness、流程和验证六个位置。给每一层写一个可能的失败点和一个防线,再标出哪些动作必须由人批准;练习只使用虚构内容,不发送真实消息或执行资金操作。
完成这一课
读完讲义、看完自测答案,这一课就算学完了。
- 读完讲义
- 看完全部自测
本课为投资者教育内容,案例数字均为示意,不构成任何投资建议,也不承诺收益。规则和费率会变,实际操作前请以交易所、监管机构和产品的最新公告为准。