01学完你能做到
知道怎么判断一个模型或 Agent 好不好:用基准测试、用 LLM 当评委(并防住它的偏差)、给 Agent 设计任务和评分器,并看懂 pass@k 这类指标。
第 37 讲(用 trace 迭代 harness)里,LangChain 每改一次 harness 就重跑一遍 Terminal Bench,看分数涨没涨。没有评测,就分不清改动是真的变好了,还是只是这次运气好。这节系统地讲评测。
02基准测试:大家用同一套题
基准测试(benchmark)是一套固定的题目加评分方法,所有模型都做同一套题,分数可以直接比较。
以 SWE-bench(ICLR 2024)为例:
- 题目来自真实 GitHub issue:从 12 个流行的 Python 仓库里,把约 9 万个 PR 筛选成 2,294 道题;
- 给模型代码库和 issue 描述,让它修改代码解决问题;
- 评分靠跑测试:每道题至少有一个「修复前失败、修复后通过」的测试(fail-to-pass)。
论文发表时,表现最好的 Claude 2 只解决了 1.96%。第 36 讲(权限、沙箱与错误恢复)讲的 SWE-agent 靠接口设计做到了 12.47%。Anthropic 在《Demystifying evals for AI agents》(2026-01-09)里说,在人工筛选过的子集 SWE-bench Verified 上,LLM 一年内从 40% 进步到了 80% 以上。
这引出基准测试的一个问题:饱和。分数接近满分时,基准就区分不出好坏了,只能换更难的题。
03LLM 当评委
很多任务没有标准答案,比如「这个回答写得好不好」,没法用测试判断。请人来评又贵又慢。于是有了 LLM-as-a-Judge:让一个强模型来打分或二选一。
论文《Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena》(2023)发现,GPT-4 当评委和人类偏好的一致率超过 80%,和人与人之间的一致率差不多。但它有几种系统性偏差:
| 偏差 | 表现 |
|---|---|
| 位置偏差 | 偏爱排在某个位置的回答,多数评委偏爱排在前面的 |
| 长度偏差 | 偏爱更长、更啰嗦的回答,哪怕它不比短的更清楚、更准确 |
| 自我偏好 | 可能偏爱自己生成的回答 |
演示:用「交换位置」消除位置偏差
论文给出的保守做法:
- 把回答 A 放前、B 放后,让评委选一次;
- 把顺序换过来(B 前 A 后),再选一次;
- 两次都选 A,才算 A 赢;两次结果不一致,就算平局。
这样评委单纯因为位置产生的偏好就被抵消了。长度偏差和自我偏好没有这么简单的办法,常见做法是在评分标准里明确写清楚,并用人工抽检来校准(见下一节)。
04Agent 评测的组成
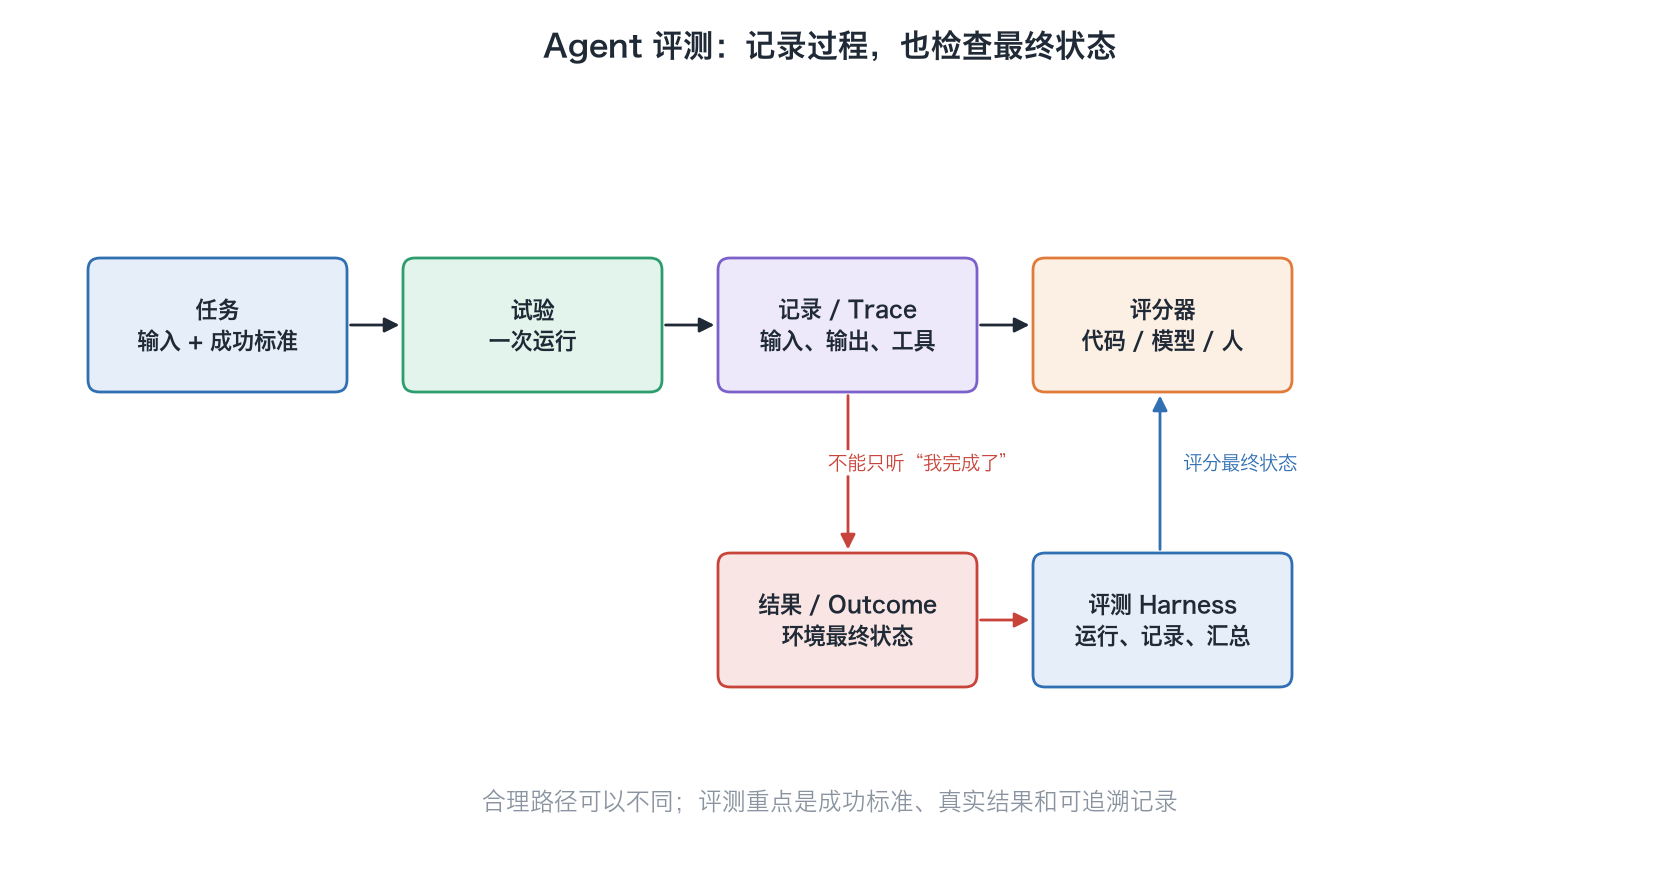
评一个 Agent 比评一个回答复杂得多:它要调很多次工具、改变环境状态,一步错还会影响后面。Anthropic 的文章给了一套术语:
| 术语 | 含义 |
|---|---|
| 任务 | 一道题:输入 + 成功标准 |
| 试验(trial) | 对一道题的一次尝试。模型输出有随机性,所以要跑多次 |
| 评分器(grader) | 给 Agent 表现的某一方面打分的逻辑,一道题可以有多个 |
| 记录(transcript,也叫 trace 或轨迹) | 一次试验的完整记录 |
| 结果(outcome) | 试验结束时环境的最终状态 |
| 评测框架(evaluation harness) | 负责跑任务、记录、评分、汇总的基础设施 |
注意「记录」和「结果」的区别:一个订机票的 Agent 最后说「已经帮你订好了」,这只是记录里的一句话;结果是数据库里到底有没有这张订单。
文章还强调:评测一个 Agent,评的是 harness 和模型一起工作的效果。 第 34 讲(Harness 是什么)说「模型 × harness 要一起评」,就是这个意思。
三种评分器
| 类型 | 方法举例 | 优点 | 缺点 |
|---|---|---|---|
| 代码 | 字符串匹配、跑测试、静态分析、检查最终状态 | 快、便宜、客观、可复现 | 合理但格式不同的答案会被误判 |
| 模型 | 按评分标准打分、两两比较、多个评委共识 | 灵活、能处理开放式任务 | 结果不确定,需要人工校准 |
| 人 | 专家评审、抽检、A/B 测试 | 质量最高 | 贵、慢 |
评结果,不评路径
文章提醒:别要求 Agent 必须按某个固定顺序调用工具。这样的测试太死板,Agent 经常能找到设计者没想到的有效做法。通常应该评它做出了什么,而不是它走了哪条路。任务有多个部分时,可以给部分分。
能力评测与回归评测
- 能力评测:问「它能做好什么」,一开始通过率应该低,给团队留出往上爬的空间;
- 回归评测:问「以前会的现在还会吗」,通过率应该接近 100%,分数一掉就说明改坏了。
能力评测的通过率升高后,可以「毕业」进回归评测,持续运行。
05随机性:pass@k 与 pass\^k
同一道题跑几次,结果可能不一样。所以要跑多次试验,再选合适的指标:
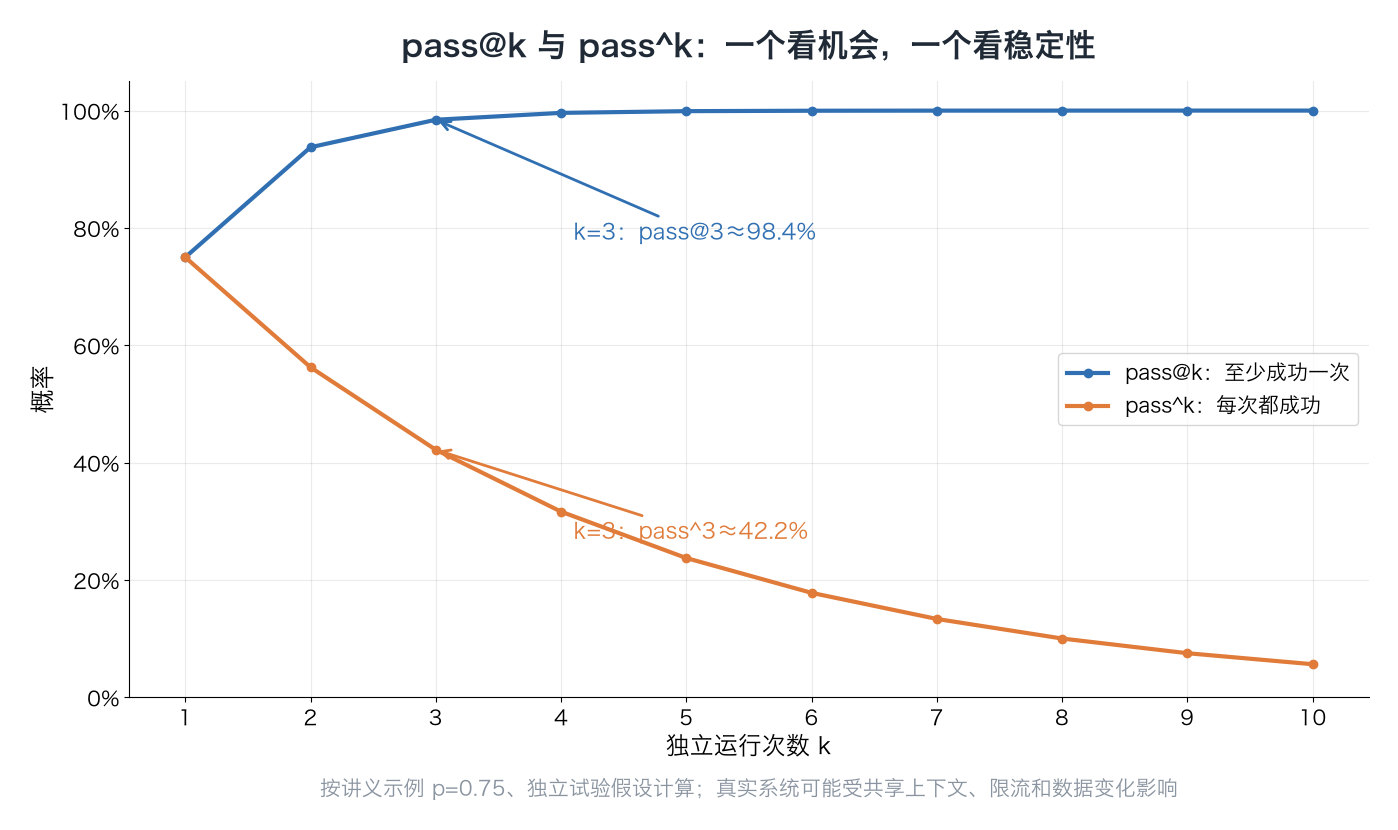
- pass@k:k 次里至少成功一次的概率。k 越大越高;
- pass\^k:k 次全部成功的概率。k 越大越低。
演示:单次成功率 75% 时
设每次试验成功率 p = 0.75,各次独立:
- pass@1 = pass\^1 = 75%;
- pass\^3 = 0.75³ ≈ 42%(文章给的例子);
- pass@3 = 1 −(1 − 0.75)³ = 1 − 0.25³ ≈ 98.4%;
- k = 10 时,pass@10 接近 100%,pass\^10 ≈ 5.6%。
同一个 Agent,两个指标给出相反的结论。选哪个看场景:写代码时可以让 Agent 多试几次、挑能用的,看 pass@k;面向用户的 Agent,用户期望每次都靠谱,要看 pass\^k。
06一定要读记录
文章说:不看很多次试验的记录和评分,就不知道评分器是否靠谱。任务失败时,记录能告诉你是 Agent 真的错了,还是评分器误判了一个合理的答案。
例如,审查 Terminal-Bench 时发现:有任务要求 Agent 写一个脚本,但没说文件路径,测试却假定了某个路径,Agent 写对了也会失败。这种题要修题,不是修 Agent。第 37 讲(用 trace 迭代 harness)说「读 trace」,在评测这一侧同样重要。
07延伸阅读
- Anthropic, Demystifying evals for AI agents, 2026-01-09:anthropic.com
- Zheng et al., Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena, 2023:arxiv.org
- Jimenez et al., SWE-bench: Can Language Models Resolve Real-World GitHub Issues?, ICLR 2024:arxiv.org
08一分钟讲给别人
试着用自己的话讲一遍评测要回答「好不好」。基准测试让所有模型做同一套题,SWE-bench 用 12 个仓库的 2,294 个真实 issue、靠跑测试评分,最初最好的 Claude 2 只解了 1.96%;基准会饱和,需要换更难的题。没有标准答案时用 LLM 当评委,GPT-4 和人的一致率超过 80%,但有位置、长度、自我偏好三种偏差;位置偏差可以交换顺序评两次来消除。Agent 评测由任务、试验、评分器、记录、结果和评测框架组成,评的是模型加 harness;记录不等于结果,要检查环境的最终状态。评分器分代码、模型、人三种,各有取舍;最好评结果而不是路径。能力评测找提升空间,回归评测防退步。输出有随机性,要多次试验:pass@k 看至少成功一次,pass\^k 看每次都成功,k 越大两者差得越远。最后,一定要读记录,确认评分器没有误判。
9 道自测
先在心里答一遍,再展开对照。能说清理由,比答对数字更重要。
01SWE-bench 的题从哪来?怎么判断模型做对了?
02什么是基准饱和?举一个本节的例子。
03LLM 当评委有哪三种偏差?位置偏差怎么消除?
04「记录」和「结果」有什么区别?用订机票的例子说明。
05代码评分器和模型评分器各有什么优缺点?
06为什么不建议检查 Agent 的工具调用顺序?
07能力评测和回归评测的通过率应该分别是什么样?
08单次成功率 80%,算 pass@2 和 pass\^2。客服 Agent 该看哪个?
09为什么说评测时一定要读记录?
已看 0/9 题
练动手练习
准备三份对同一段公开材料的摘要,先自己写出 3 条可检查的评分标准,再让 AI 以“代码检查、模型评审或人工评审”中的一种方式逐条打分。重复生成几次,比较“至少有一次合格”和“每次都合格”分别对应什么指标,不要把分数当成投资结论。
完成这一课
读完讲义、看完自测答案,这一课就算学完了。
- 读完讲义
- 看完全部自测
本课为投资者教育内容,案例数字均为示意,不构成任何投资建议,也不承诺收益。规则和费率会变,实际操作前请以交易所、监管机构和产品的最新公告为准。