01学完你能做到
不换模型、只改 harness 也能明显提升效果;方法是读 trace、给失败分类、针对性地改,再重新跑分。
第 34 讲(Harness 是什么)提到,LangChain 的编码 Agent 只改 harness,就从排行榜第 30 名左右升到了前 5 名。这节讲具体怎么做到的。材料来自 LangChain 的《Improving Deep Agents with harness engineering》(Vivek Trivedy,2026-02-17)。
02实验设置:模型不动,只拧三个旋钮
- 基准:Terminal Bench 2.0,包含 89 个任务,涉及机器学习、调试、生物等领域,是评测编码 Agent 的常用基准;
- 模型:固定用 gpt-5.2-codex,全程不换;
- 记录:每个 Agent 动作都存进 LangSmith,同时记录延迟、token 数和成本。
harness 能调的东西很多:系统提示词、工具、钩子、技能、子智能体、记忆……文章有意缩小范围,只调三个:系统提示词、工具、中间件(middleware,LangChain 对「包在模型调用和工具调用外面的钩子」的叫法)。
起点:默认提示词 + 标准工具和中间件,得分 52.8%,刚好排在前 30 名之外。
03trace 是什么,为什么要读它
trace(轨迹)是一次运行的完整记录:每一步的输入、模型输出、工具调用和结果。文章说,模型内部像黑盒,很难解释,但它在文本层面的输入和输出是看得见的,可以拿来做改进。
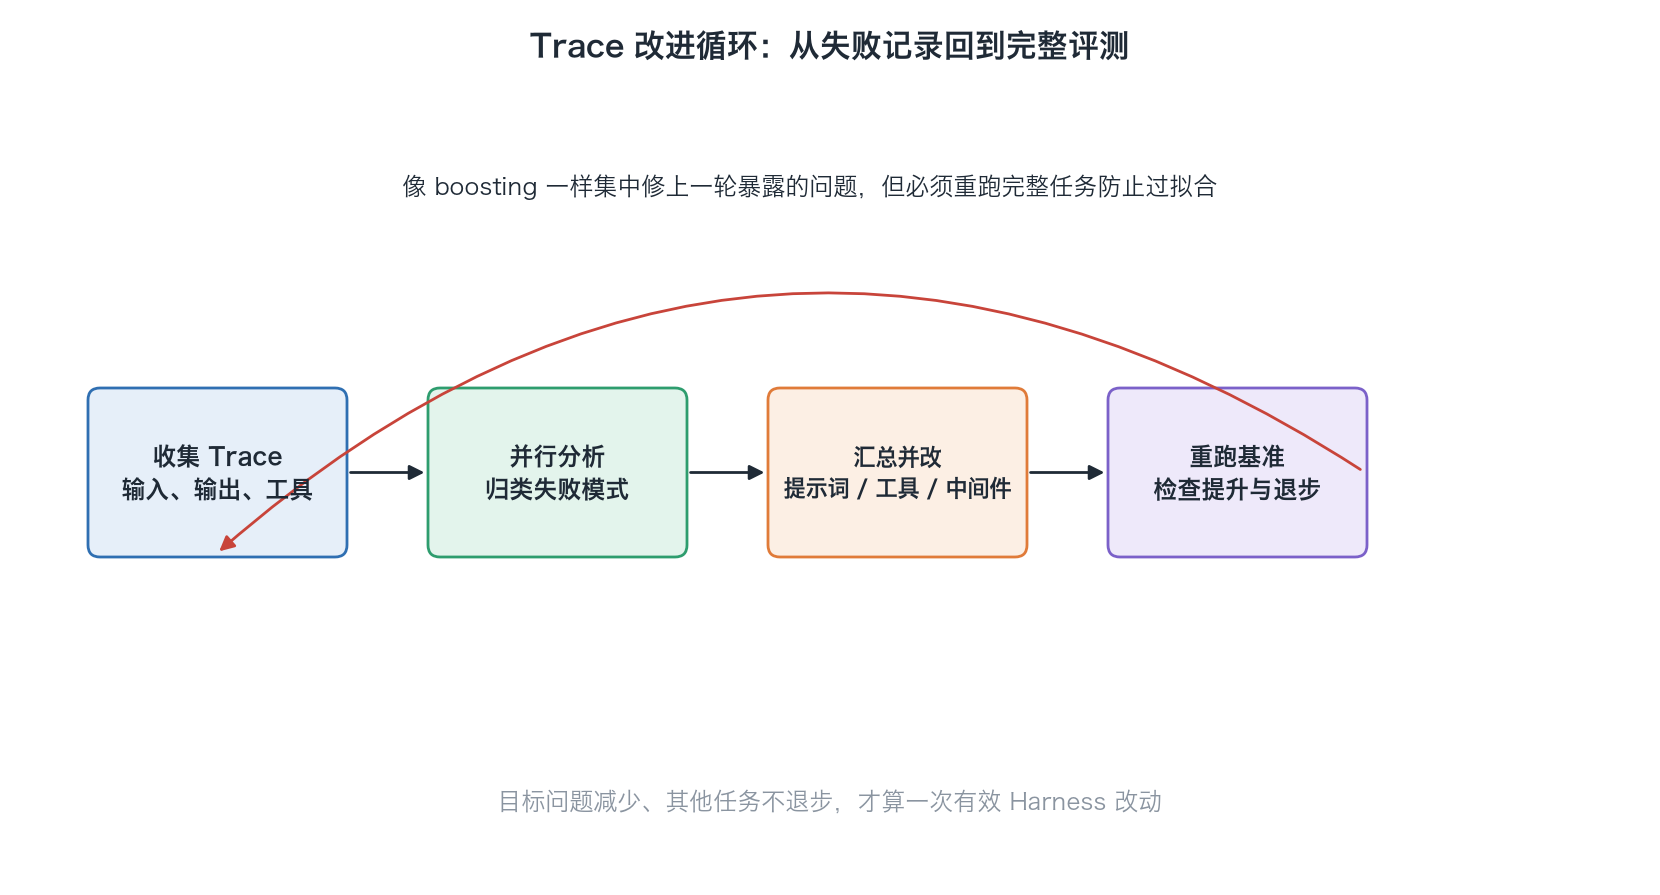
人工读几百条 trace 太慢,所以他们把分析做成了一个 Agent 技能(Trace Analyzer Skill):
- 从 LangSmith 取出实验的 trace;
- 启动多个并行的错误分析智能体,主智能体汇总它们的发现和建议;
- 汇总反馈,有针对性地修改 harness。
文章说这类似机器学习里的 boosting:每一轮专门盯着上一轮的错误。人可以在第 3 步帮忙复核,但不是必须的。要警惕的是:只对某个任务有效的改动属于过拟合,会让其他任务退步。
04trace 里发现了哪些失败模式
文章列出的问题有:推理错误、没按任务说明做、缺少测试和验证、时间用完等。最常见的一种是:
Agent 写完方案,重读一遍自己的代码,觉得没问题,就停了。
也就是只检查了「代码看起来对不对」,没有检查「是否满足任务要求」。下面按失败模式讲对应的改法。
改法一:构建-验证循环(针对「不验证」)
在系统提示词里加入解题步骤:
- 规划与探索:读任务、扫描代码库,根据任务说明和验证方式定初步计划;
- 构建:实现时就想着怎么验证;没有测试就写测试,正常路径和边界情况都要测;
- 验证:运行测试,读完整输出,拿来和任务要求比,而不是和自己的代码比;
- 修复:分析错误,回头看原始需求,再修。
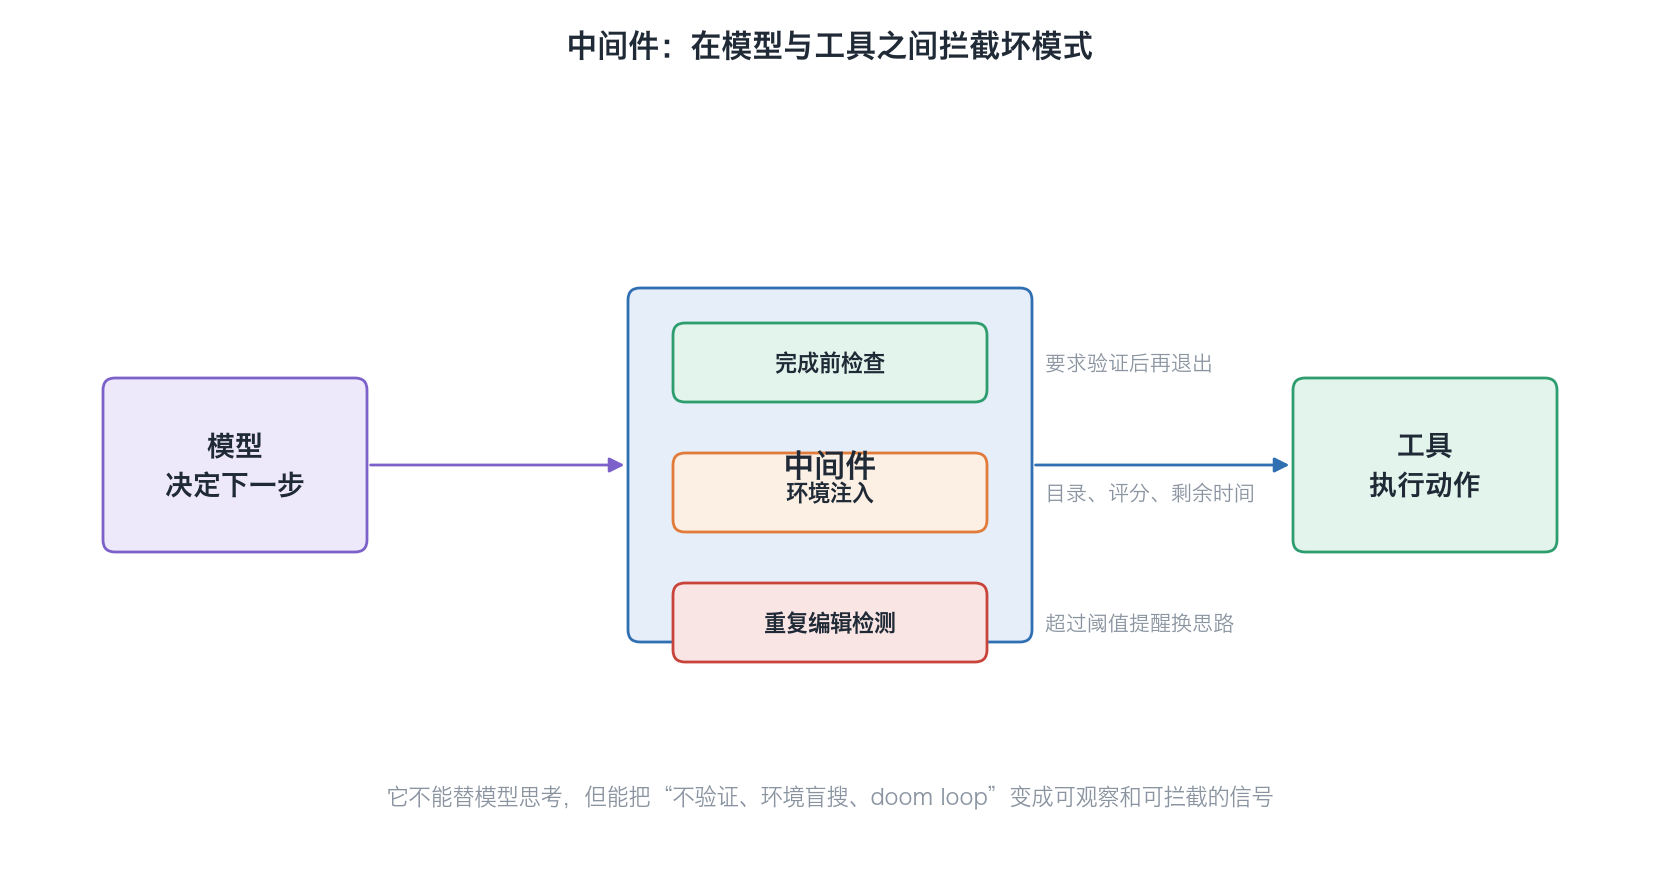
光靠提示词还不够。他们加了一个完成前检查清单中间件(PreCompletionChecklistMiddleware):Agent 准备退出时把它拦住,提醒它对照任务说明再做一遍验证。
改法二:把环境信息直接送给 Agent(针对「找不到东西」)
- 本地上下文中间件(LocalContextMiddleware):Agent 启动时自动画出当前目录及上下级目录的结构,并用 bash 命令找到 Python 等工具的位置。自己摸索容易出错,直接注入能减少出错的机会;
- 告诉它会被怎样评分:提示 Agent 它的结果会被程序化测试检查,任务里写的文件路径要严格照做;
- 时间预算提醒:注入剩余时间的警告,催它收尾、转去验证。文章说 Agent「出了名地不会估计时间」。
文章的总结:Agent 越了解环境、约束和评分标准,越能自主完成工作。
改法三:检测死循环(针对「一条路走到黑」)
Agent 一旦定了方案就容易「近视」,对同一个错误方案反复做小改动,文章称为 doom loop(死循环),有的 trace 里超过 10 次。
循环检测中间件(LoopDetectionMiddleware)通过工具调用的钩子记录每个文件被编辑了几次。同一文件改了 N 次之后,就往上下文里加一句类似「……考虑换一种思路」的提醒。这能帮 Agent 跳出死循环,但如果模型认定自己是对的,它仍可能继续原路。
文章特别说明:这是针对当前模型弱点的设计,模型变强后很可能就不需要了。这和第 35 讲(工具循环、状态与长任务)「harness 的每个组件都是对模型弱点的假设」是一回事。
05推理预算:「推理三明治」
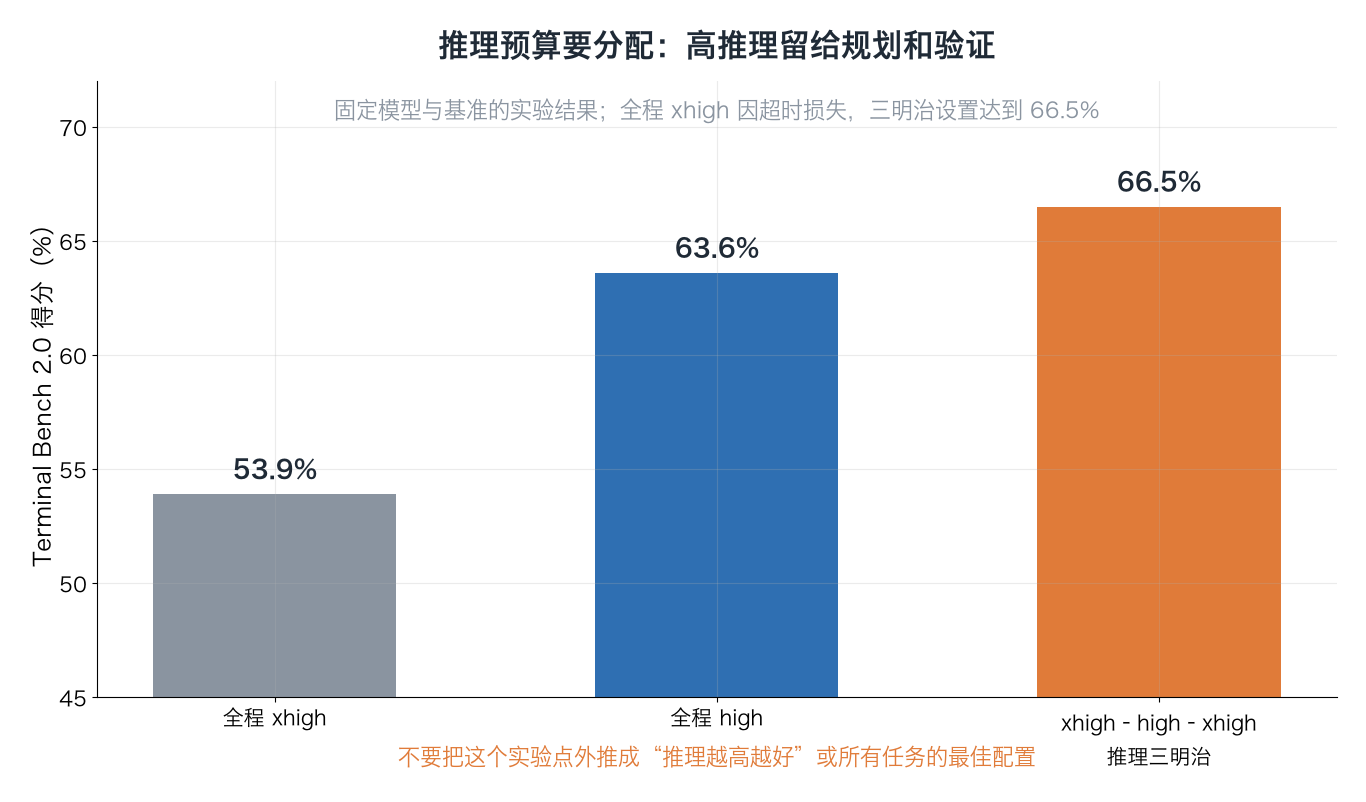
gpt-5.2-codex 有四档推理强度:low、medium、high、xhigh。推理多,每一步想得更清楚,但 token 和时间可能多出一倍以上,而 Terminal Bench 有超时限制。
- 全程 xhigh:只有 53.9%,因为很多任务超时;
- 全程 high:63.6%;
- 「推理三明治」xhigh - high - xhigh:规划阶段和最后验证阶段用最高档,中间实现用 high。最终得分 66.5%。
从 52.8% 到 66.5%,提高了 13.7 个百分点,模型一直没换。
演示:从一条 trace 到一次改动(示意)
- 读到一条失败的 trace:Agent 实现了脚本,自己
cat了一遍,回复「已完成」,但测试要求的输出路径和它写的不一样; - 归类:属于「没验证」+「没按任务说明做」;
- 再看其他失败 trace,发现同类问题很多 → 这是普遍问题,不是个例,改了不算过拟合;
- 改法:提示词里加「严格按任务里的文件路径」,并用完成前检查清单中间件强制再验证一遍;
- 重新跑整套基准,看这类失败是否减少、其他任务有没有退步。
06文章总结的几条原则
- 替 Agent 做上下文工程:目录结构、可用工具、解题策略,能直接给的就别让它自己找;
- 帮 Agent 自我验证:模型倾向于停在第一个看起来可行的方案上,要积极提示它跑测试、改进方案;
- 把 trace 当反馈信号:工具和推理要一起排查,模型走错路,常常是因为缺工具或缺说明;
- 短期内检测并修正坏模式:盲目重试、不验证是典型例子,这些护栏以后很可能会消失;
- harness 要针对模型调:用早期 harness 测 Claude Opus 4.6 得了 59.6%,不如 Codex,因为没对 Claude 跑同样的改进循环。
第 5 条也说明:比较两个模型时,如果 harness 只为其中一个调过,结论就不公平。第 38 讲(评测)会讲怎么评测。
07延伸阅读
- Vivek Trivedy(LangChain), Improving Deep Agents with harness engineering, 2026-02-17:langchain.com
08一分钟讲给别人
试着用自己的话讲一遍LangChain 固定用 gpt-5.2-codex,只调系统提示词、工具和中间件,在 Terminal Bench 2.0 上从 52.8% 提到 66.5%。方法是把 trace 分析做成技能:取 trace、并行分析错误、汇总后针对性地改 harness,像 boosting 一样每轮盯着上一轮的错,同时提防过拟合。主要失败模式和改法:写完不验证 → 提示词里加规划-构建-验证-修复,再用完成前检查清单中间件强制验证;不了解环境 → 启动时注入目录和工具信息,告诉它评分方式,提醒时间;死循环 → 记录每个文件的编辑次数,超过 N 次就提醒换思路。推理预算用 xhigh-high-xhigh 的「三明治」,全程 xhigh 反而因超时只有 53.9%。这些护栏针对的是当前模型的弱点,harness 也要针对具体模型来调。
8 道自测
先在心里答一遍,再展开对照。能说清理由,比答对数字更重要。
01这个实验里固定了什么、改了什么?分数从多少到多少?
02什么是 trace?为什么说它是改进 harness 的原材料?
03为什么说 trace 分析流程「类似 boosting」?要提防什么?
04最常见的失败模式是什么?用了哪两种手段解决?
05本地上下文中间件做什么?为什么不让 Agent 自己找?
06什么是 doom loop?循环检测中间件怎么工作,有什么局限?
07为什么全程 xhigh 反而比全程 high 分低?「推理三明治」是怎么分配的?
08Claude Opus 4.6 得了 59.6%,能说明它比 Codex 差吗?
已看 0/8 题
练动手练习
让任意 AI 聊天工具完成一个有明确验收条件的小任务,例如把一段公告整理成固定字段表。记录它的输入、输出、是否调用工具以及最终检查结果,找出一个“看起来完成但没有验证”的地方,再补一条完成前检查;不要要求它做投资判断。
完成这一课
读完讲义、看完自测答案,这一课就算学完了。
- 读完讲义
- 看完全部自测
本课为投资者教育内容,案例数字均为示意,不构成任何投资建议,也不承诺收益。规则和费率会变,实际操作前请以交易所、监管机构和产品的最新公告为准。