01学完你能做到
理解 Agent 怎么跨多个上下文窗口持续推进一个大任务:靠初始化、进度文件、git 检查点、增量推进和交接产物。
第 29 讲(工具调用 / Function Calling)讲了工具循环:调工具 → 看结果 → 再调。一个循环能跑多久,受上下文窗口限制。如果任务要几个小时、几百个功能,一个窗口肯定装不下。这节讲 Anthropic 两篇文章里的做法:让 Agent 像轮班工程师一样交接。
02问题:每个新会话都没有记忆
Anthropic 在《Effective harnesses for long-running agents》(2025-11-26)里打了个比方:长任务就像工程师轮班,每个新来的人对上一班发生了什么毫无记忆。
只靠压缩(第 27 讲(压缩与隔离))够吗?不够。他们让 Opus 4.5 在 Claude Agent SDK 里循环跑多个窗口,任务是「做一个 claude.ai 的克隆」,结果还是做不成。他们观察到两种失败:
- 想一口气做完:一次做太多,做到一半上下文用完,留下一个半成品,而且没有记录。下一班只能猜上一班干了什么。
- 过早宣布完成:后来的 Agent 看到已经有不少功能,就宣布「做完了」。
另一篇《Harness design for long-running application development》(2026-03-24)补充了两种现象:
- 窗口越满,模型越容易失去连贯;
- 有的模型会出现「上下文焦虑」:感觉快到上限时,提前草草收尾。
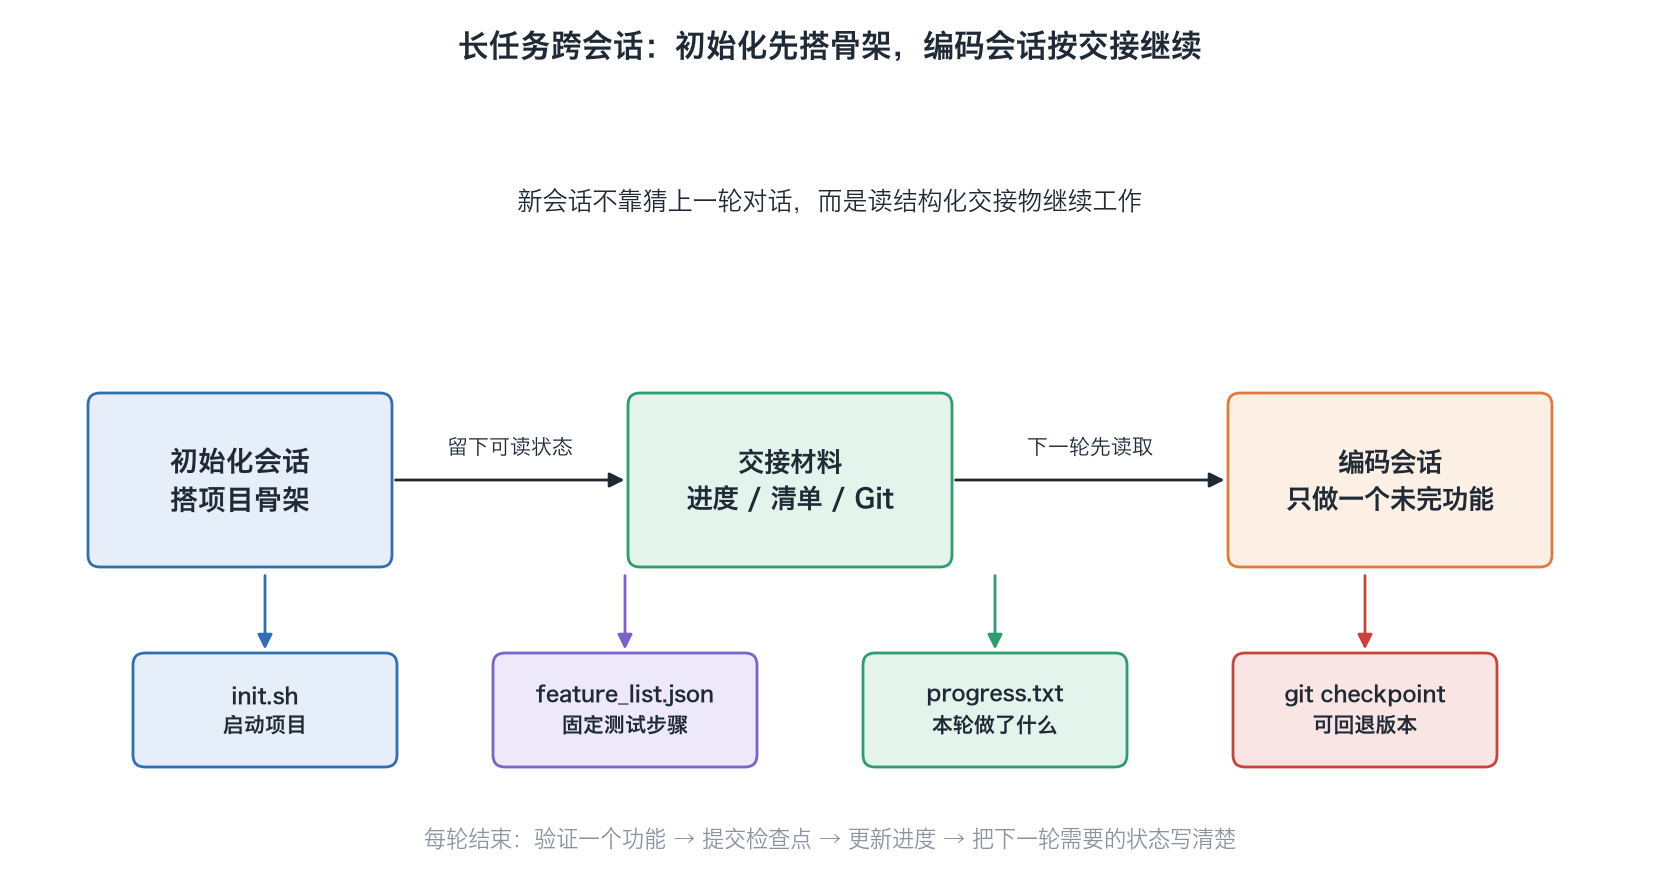
03解法:初始化智能体 + 编码智能体
第 1 个会话:初始化智能体(initializer agent)
用一段专门的提示词,让第一个会话只搭架子、不写功能:
- 写一个
init.sh脚本,用来启动开发服务器; - 写一份功能清单
feature_list.json:200 多个功能,全部标为未通过; - 建进度文件
claude-progress.txt; - 做第一次 git 提交。
之后的每个会话:编码智能体(coding agent)
每次只做一个功能,结束时留下结构化的更新。
文章脚注说:这两个「智能体」其实只是第一条用户提示词不同,系统提示词、工具和 harness 完全一样。
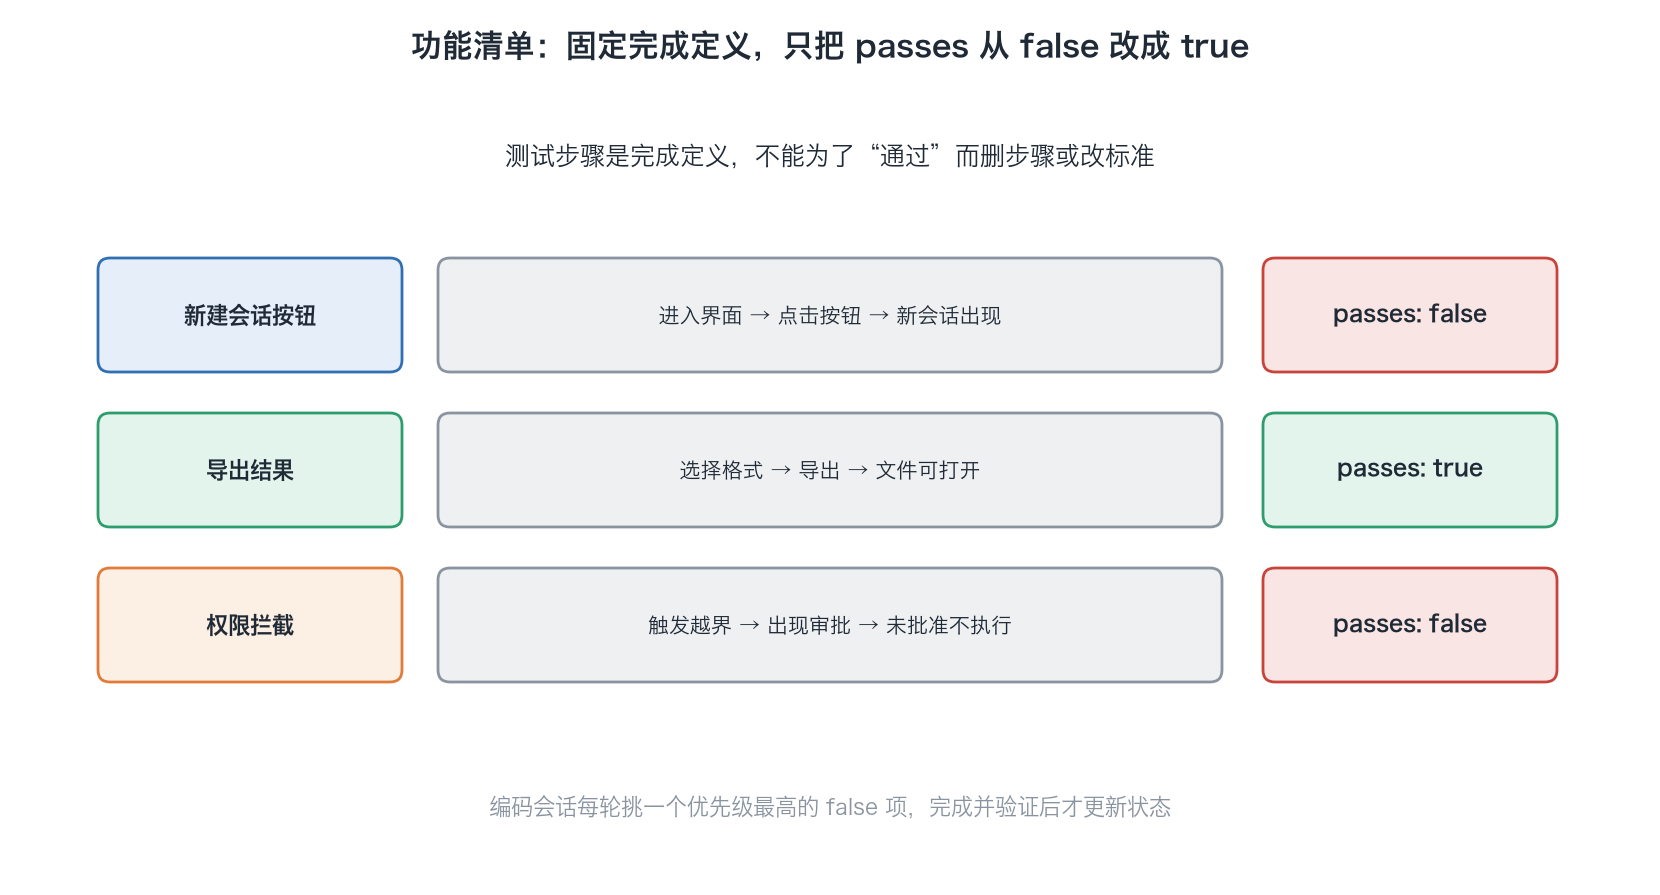
演示:功能清单长什么样
下面是一个示例(保留 JSON 格式,并附中文说明):
{
  "category": "functional",
  "description": "New chat button creates a fresh conversation",
  "steps": [
    "Navigate to main interface",
    "Click the 'New Chat' button",
    "Verify a new conversation is created",
    "Check that chat area shows welcome state",
    "Verify conversation appears in sidebar"
  ],
  "passes": false
}
(大意:「新建对话」按钮会创建一个新会话;验证步骤是进入主界面 → 点按钮 → 确认新会话出现 → 欢迎状态显示 → 侧边栏出现这个新会话。)
三个设计细节:
- 只允许改
passes字段。提示词里写得很重:删除或修改测试是不可接受的,因为那会导致功能缺失或出 bug。 - 用 JSON 而不用 Markdown:他们发现模型不太会乱改 JSON 文件。
- 清单就是「完成的定义」,防止过早宣布完成。还有
passes: false的项,就没做完。
演示:一个编码会话的开场流程
文章给出了每个编码会话固定的开场步骤:
pwd:看看自己在哪个目录;- 读 git 日志和进度文件,了解最近做了什么;
- 读功能清单,挑优先级最高的未完成功能;
- 运行
init.sh启动开发服务器; - 先跑一遍基本的端到端测试,确认应用没被上一班弄坏,再开始新功能。
文章里的示例记录大致是这样(节选改写):
[助手] 我先了解一下项目的当前状态。
[工具] pwd
[工具] 读 claude-progress.txt
[工具] 读 feature_list.json
[工具] git log --oneline -20
[助手] 检查有没有重启服务器的 init.sh……
<启动开发服务器>
[助手] 先确认基本功能还正常……
<测试基本功能>
[助手] 基本功能正常。接下来看清单,决定下一步做什么……
第 5 步很关键:如果上一班留下了 bug,先修 bug,再做新功能,避免在坏地基上继续盖楼。
会话结束时:用描述清楚的提交说明做 git 提交,并更新进度文件。下一班就能从 git 日志接上;改坏了,也能用 git 回退到上一个好的版本。git 提交就是检查点。
测试:要像真人一样测
文章发现,Claude 经常改完代码、跑个单元测试或 curl 一下,就把功能标成通过,实际在浏览器里根本不能用。给它浏览器自动化工具(Puppeteer MCP),要求「像人类用户一样」端到端测试后,效果大幅改善。局限:它看不到浏览器原生的弹窗(alert)。
四种失败与对策(对照表)
| 问题 | 初始化智能体怎么做 | 编码智能体怎么做 |
|---|---|---|
| 过早宣布整个项目完成 | 建功能清单 | 开场读清单,每次只挑一个功能 |
| 留下 bug 或没记录的进度 | 建 git 仓库和进度文件 | 开场读进度和 git 日志、跑基本测试;收尾提交并更新进度 |
| 过早把功能标为完成 | 建功能清单 | 认真测试之后才标「通过」 |
| 花时间琢磨怎么启动应用 | 写 init.sh | 开场先运行 init.sh |
04上下文重置还是压缩
《Harness design》比较了两种跨窗口的方式:
| 上下文重置(context reset) | 压缩(compaction,第 27 讲(压缩与隔离)) | |
|---|---|---|
| 做法 | 清空窗口,开一个新 Agent,靠结构化交接物接上 | 在原地把早期对话总结,同一个 Agent 继续 |
| 好处 | 干净的新起点,彻底摆脱上下文焦虑 | 保持连续性 |
| 代价 | 编排更复杂,多花 token 和时间 | 上下文焦虑可能仍在 |
他们的经历说明选择取决于模型:
- Sonnet 4.5 的上下文焦虑很严重,光靠压缩不够,必须重置;
- Opus 4.5 基本没有这个问题,于是他们去掉了重置,改用 SDK 的自动压缩。
交接物(handoff artifacts)就是重置时传给下一个 Agent 的东西:进度文件、功能清单、git 历史、规格文档。交接物写得好不好,决定了新 Agent 能不能顺利接上。
05长任务的成本
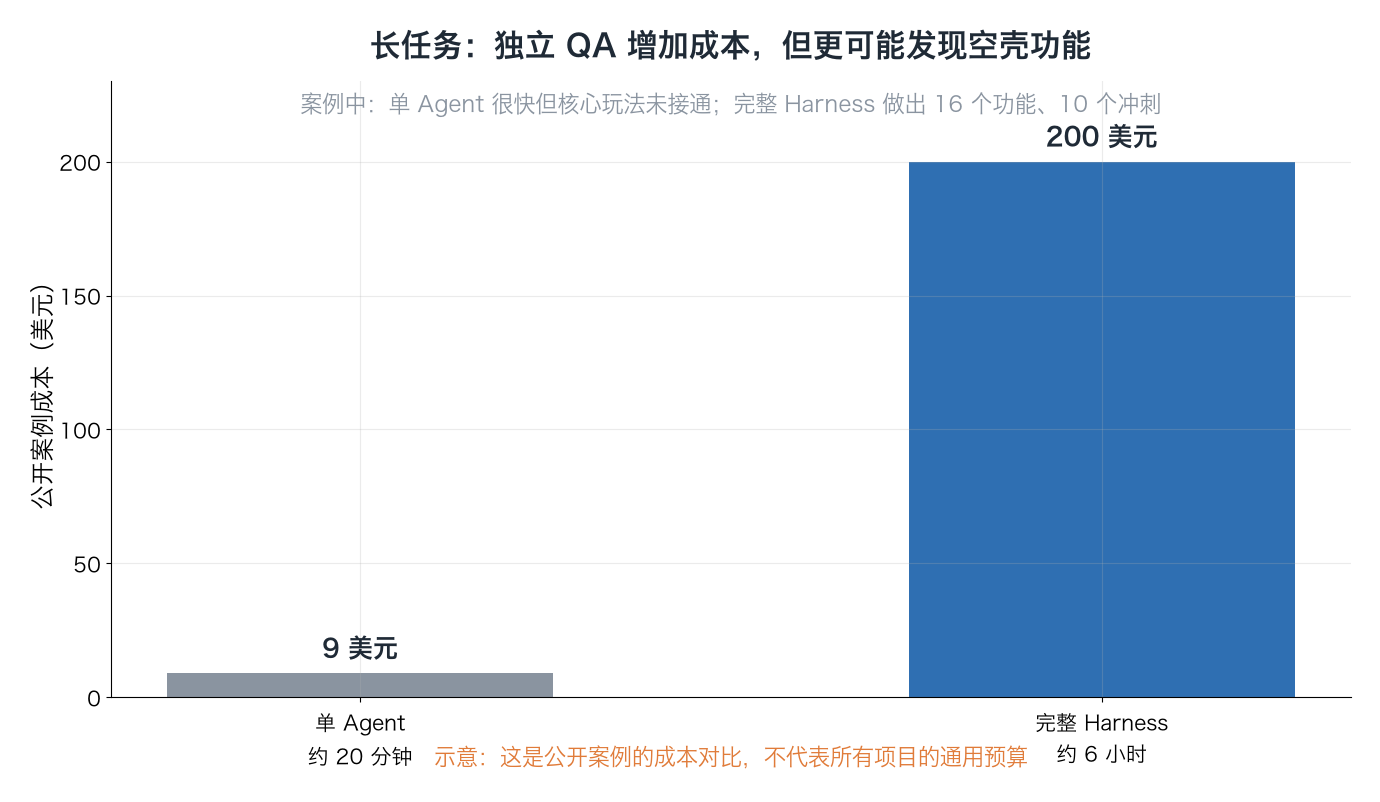
《Harness design》里有一组对比:同样做一个「复古游戏制作器」,单个 Agent 直接做,和用完整 harness 做。完整 harness 包括规划者、生成者、评估者三个角色,第 36 讲(权限、沙箱与错误恢复)细讲。
| 时长 | 成本 | 结果 | |
|---|---|---|---|
| 单个 Agent | 20 分钟 | 9 美元 | 界面能看,但核心玩法坏了 |
| 完整 harness | 6 小时 | 200 美元 | 16 个功能、10 个冲刺(sprint),游戏能玩 |
贵了 20 多倍,但只有后者真正可用。
演示:读懂一张长任务账单
后来用 Opus 4.6 做「浏览器里的音乐制作软件(DAW)」时,他们公布了每个阶段的耗时和花费:
| 阶段 | 耗时 | 成本 |
|---|---|---|
| 规划 | 4.7 分钟 | \$0.46 |
| 构建(第 1 轮) | 2 小时 7 分 | \$71.08 |
| QA(第 1 轮) | 8.8 分钟 | \$3.24 |
| 构建(第 2 轮) | 1 小时 2 分 | \$36.89 |
| QA(第 2 轮) | 6.8 分钟 | \$3.09 |
| 构建(第 3 轮) | 10.9 分钟 | \$5.88 |
| QA(第 3 轮) | 9.6 分钟 | \$4.06 |
| 合计 | 3 小时 50 分 | \$124.70 |
怎么读这张表:
- 构建花费合计 71.08 + 36.89 + 5.88 = 113.85 美元,约占 91%。钱主要花在干活上。
- QA 合计 3.24 + 3.09 + 4.06 = 10.39 美元,约占 8%,但它抓出了只有界面、没有真实功能的「样子货」,比如录音功能只是个空壳。用 8% 的钱换来「真能用」,很划算。
- 每轮构建越来越短,说明 QA 反馈让后面的修复更有针对性。
06模型变强,harness 要减负
《Harness design》里有一句很重要的话:
Every component in a harness encodes an assumption about what the model can't do on its own.
(harness 里的每个组件,都暗含一个「模型自己做不到某事」的假设。)
模型升级后,这些假设可能不再成立。他们的做法是一次去掉一个组件,看效果有没有变差:
- 换到 Opus 4.6 后,去掉了冲刺(sprint)结构,模型自己就能保持连贯;
- 保留了规划者,没有它,生成者会把范围做小;
- 评估者从每个冲刺都检查,改成最后检查一次。
结论:新模型发布时,要重新审视 harness。不再需要的部分就拆掉,它们只会增加成本。这和第 34 讲(Harness 是什么)说的「harness 有一部分会被模型吸收」一致。
07延伸阅读
- Justin Young(Anthropic), Effective harnesses for long-running agents, 2025-11-26:anthropic.com
- Prithvi Rajasekaran(Anthropic), Harness design for long-running application development, 2026-03-24:anthropic.com
08一分钟讲给别人
试着用自己的话讲一遍长任务要跨很多上下文窗口,每个新会话都没有记忆,像工程师轮班。只靠压缩不够,常见失败是想一口气做完、做到一半没了上下文,以及过早宣布完成。Anthropic 的解法:第一个会话由初始化智能体建 `init.sh`、200 多项全部未通过的 JSON 功能清单、进度文件和首次 git 提交;之后每个编码会话按固定流程开场(pwd、读进度和 git 日志、挑一个功能、跑 `init.sh`、先测基本功能),只做一个功能,像真人一样端到端测试后才标通过,最后提交 git、更新进度。两种智能体只是第一条提示词不同。跨窗口可以用上下文重置(干净但贵)或压缩(连续但可能有焦虑),选哪个看模型。完整 harness 贵 20 多倍,但做出的东西能用;QA 只占约 8% 的成本,却能抓出空壳功能。harness 的每个组件都是对模型弱点的假设,新模型来了要逐个检验、拆掉多余的。
8 道自测
先在心里答一遍,再展开对照。能说清理由,比答对数字更重要。
01为什么说长任务像「工程师轮班」?只靠压缩会出现哪两种失败?
02初始化智能体要建哪几样东西?它和编码智能体有什么区别?
03功能清单为什么用 JSON?为什么只允许改 `passes` 字段?
04编码会话开场为什么要先跑一遍基本测试?
05git 提交在长任务里起什么作用?
06上下文重置和压缩各有什么利弊?Anthropic 为什么后来不用重置了?
07从 DAW 账单里看,QA 值不值?
08「harness 的每个组件都暗含一个假设」,这对维护 Agent 产品意味着什么?
已看 0/8 题
练动手练习
为一个你想持续几天完成的小项目写一份“交接包”:列出启动命令、3 个待办功能、当前进度、验证步骤和回退点。然后把其中一项标为未通过,模拟下一次会话先读进度、跑基本测试,再决定是否开始新功能;不要涉及真实交易或发送消息。
完成这一课
读完讲义、看完自测答案,这一课就算学完了。
- 读完讲义
- 看完全部自测
本课为投资者教育内容,案例数字均为示意,不构成任何投资建议,也不承诺收益。规则和费率会变,实际操作前请以交易所、监管机构和产品的最新公告为准。