01学完你能做到
知道怎么让 Agent 安全地动手:用沙箱划边界、按风险分级审批、出错能重试和回滚,并用独立的评估者检查结果。
第 29 讲(工具调用 / Function Calling)讲了 Agent 能调用工具,第 35 讲(工具循环、状态与长任务)讲了它能连续干几个小时。能力越大,出错的代价越大:删错文件、把密钥发出去、在坏代码上越改越乱。这节讲 harness 里管「安全动手」的四件事:隔离、审批、恢复、验证。
02为什么光靠「每步都问人」不行
Anthropic 在《Making Claude Code safer with sandboxing》(2025-10-20)里介绍了 Claude Code 原来的做法:默认只读,修改文件或运行命令前都要问用户,只有 echo、cat 这类安全命令自动放行。
问题是,一直点「同意」会拖慢开发,还会造成审批疲劳(approval fatigue):人开始不看内容就点同意,结果反而更不安全。
解法是换个思路:事先划好边界,边界里随便干,越界才问人。 这就是沙箱。文章说,在他们内部使用中,沙箱把权限弹窗减少了 84%。
03沙箱的两道边界
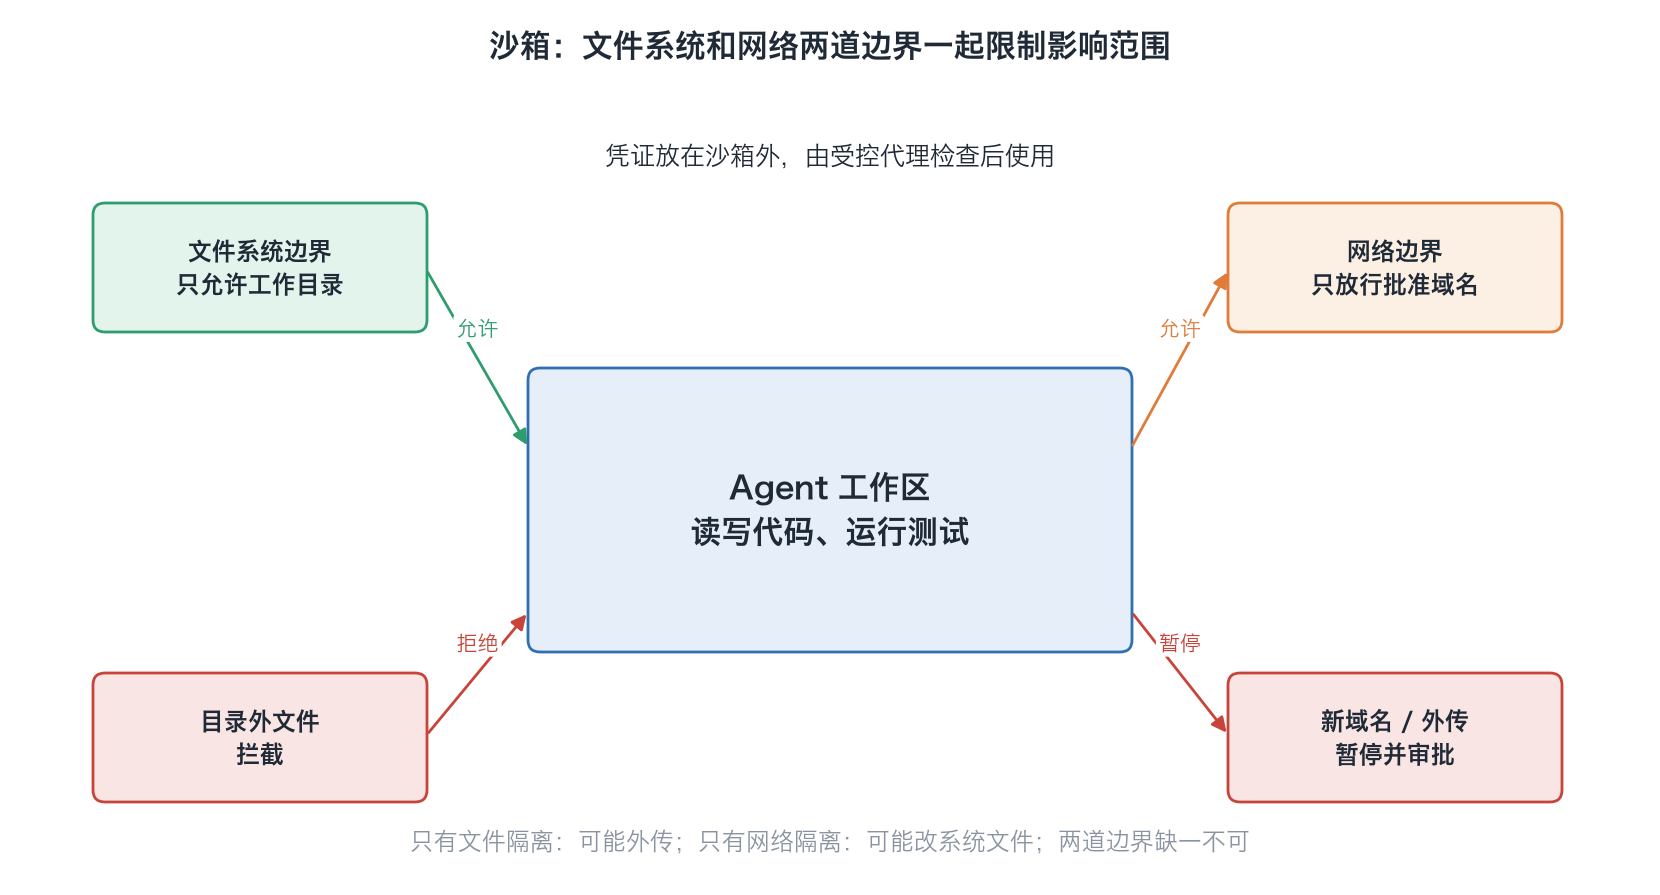
沙箱建立在操作系统级的功能上(Linux 用 bubblewrap,macOS 用 seatbelt),限制不仅作用于 Agent 直接运行的命令,也作用于这些命令启动的所有子进程和脚本。它有两道边界:
| 边界 | 做法 | 防的是什么 |
|---|---|---|
| 文件系统隔离 | 当前工作目录可读写,目录外的文件不能修改 | 被注入的 Agent 改系统敏感文件 |
| 网络隔离 | 所有出网请求都经过沙箱外的代理,只放行批准的域名;新域名要用户确认 | 被注入的 Agent 外泄数据、下载恶意软件 |
文章特别强调:两道边界缺一不可。
- 只有文件隔离、没有网络隔离:Agent 可以把 SSH 密钥这类敏感文件发出去;
- 只有网络隔离、没有文件隔离:Agent 可以改系统文件逃出沙箱,再拿到网络权限。
这样即使提示注入(第 39 讲(提示注入))成功了,影响也被关在沙箱里。
演示:凭证不进沙箱
文章还介绍了云端版的做法:每个会话跑在隔离的沙箱里,git 凭证、签名密钥等敏感凭证从来不放进沙箱。沙箱里的 git 只拿到一个权限很小的专用凭证,所有 git 操作都经过一个代理:
- 沙箱里的 git 客户端用专用凭证连代理;
- 代理检查凭证,再检查这次操作的内容,例如是不是只允许更新指定分支;
- 检查通过后,代理换上真正的令牌,再发给 GitHub。
要点:真正有权限的东西放在 Agent 碰不到的地方,由代码代为使用。 第 39 讲(提示注入)讲防注入时还会用到这条原则。
04权限审批:按风险分三档
把上面的做法整理一下,Agent 的每个动作可以分三档:
- 安全的只读命令:直接执行;
- 沙箱边界内的动作:直接执行,不弹窗;
- 越界或高风险的动作(改目录外的文件、连新域名):暂停,请人批准。
这样人只需要在真正要紧的时候做判断,注意力不会被大量无关弹窗耗光。第 40 讲(对齐与 Agent 安全总复习)会把这一点和「人在回路」「最小权限」放在一起总结。
05错误恢复:重试与回滚
Agent 一定会出错,关键是错了能不能回来。
接口层面防错。 SWE-agent 论文(2024)提出「Agent-计算机接口」(ACI):像给人设计软件界面一样,专门给 Agent 设计命令和反馈格式。其中一条设计是在编辑命令里接入 linter(代码检查器):如果一次编辑引入了语法错误,就把错误告诉 Agent,并拒绝这次编辑。论文说 Agent 很难从自己造成的错误里恢复,所以最好在错误发生时就拦住。凭这类接口设计,SWE-agent 在完整 SWE-bench 上解决了 12.47% 的问题,此前非交互式方法的最好成绩是 3.8%。
检查点和回滚。 第 35 讲(工具循环、状态与长任务)讲过,每完成一个功能就提交一次 git,相当于存档。改坏了就退回上一个好版本,而不是在坏的基础上继续改。
重试要有上限、有变化。 盲目重试同一个错误做法没有用。第 37 讲(用 trace 迭代 harness)会讲到 LangChain 发现的「死循环」:Agent 对同一个错误方案反复做小改动,有的 trace 里超过 10 次。
演示:一次出错后的恢复流程(示意)
假设 Agent 在修一个 bug:
- 改代码,linter 报语法错误 → 编辑被拒绝,Agent 立刻看到错误行号并重写;
- 代码能运行,但测试失败 → 读失败信息,再改一次;
- 连续三次都没通过 → 不再微调,回退到上次提交,换一个思路;
- 测试通过 → 提交 git,更新进度文件。
第 1 步靠接口,第 3 步靠检查点和重试上限,第 4 步靠存档。
06自我验证与规划者-生成者-评估者
做完了怎么知道真的做对了?最简单的是让 Agent 自己检查,但 Anthropic 在《Harness design for long-running application development》(2026-03-24)里指出:让 Agent 评价自己的作品,它往往会自信地夸奖,哪怕质量明显一般。在设计这类主观任务上尤其明显。
文章的结论是:把干活的和评判的分开。分开之后评估者仍然是 LLM,仍然偏宽容,但「把一个独立的评估者调得挑剔」比「让生成者批评自己」容易得多。这和第 28 讲(什么是 Agent)的「评估-优化」模式、第 32 讲(多智能体)「干活的和把关的分开」是同一个道理。
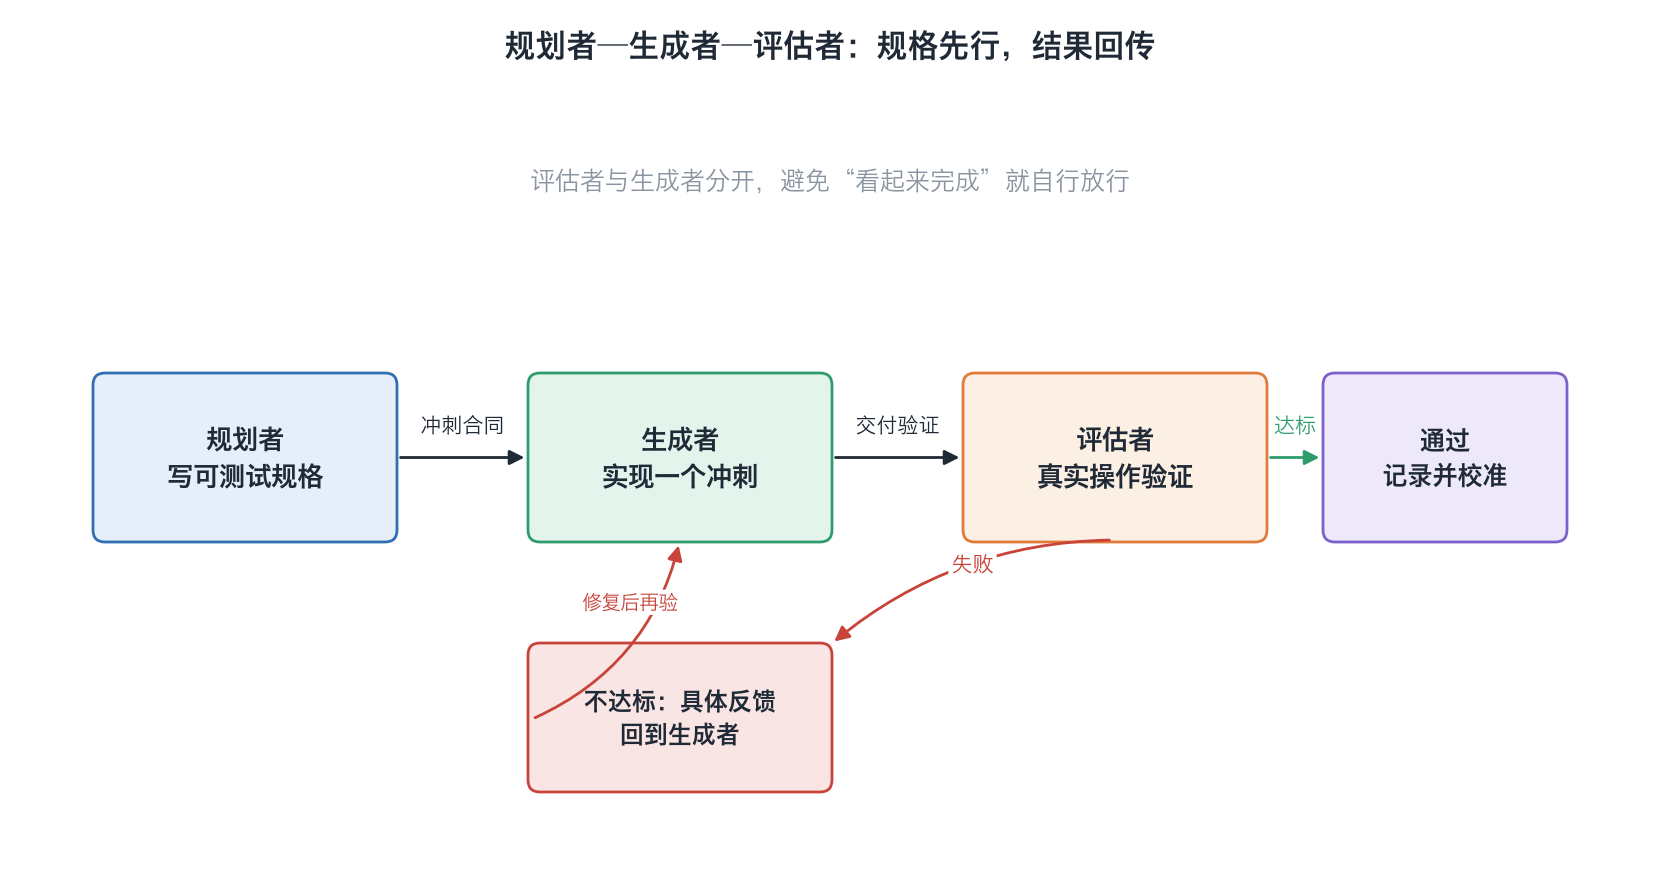
文章受生成对抗网络(GAN)启发,设计了三个角色:
| 角色 | 职责 |
|---|---|
| 规划者 | 把用户 1–4 句话的需求扩写成完整的产品规格,只写高层设计,不过早规定实现细节 |
| 生成者 | 按冲刺(sprint)一块一块地写代码 |
| 评估者 | 用 Playwright 像真人一样点击运行中的应用,测试界面、API 和数据库状态 |
几个关键设计:
- 冲刺合同:每个冲刺开始前,生成者提出要做什么、怎么验证,评估者审核,双方反复修改直到达成一致,然后才写代码。这一步把高层规格变成可以测试的标准。
- 硬门槛:每条标准都有及格线,任何一条不达标,这个冲刺就判失败,生成者会收到具体的反馈。
- 通过文件交流:一个智能体写文件,另一个读了再回复。
演示:评估者抓出的 bug
合同可以很细,文章说第 3 个冲刺仅关卡编辑器就有 27 条标准。评估者的反馈具体到可以直接动手修,例如:
- 「可以通过 API 调整动画帧顺序」→ 不通过:
PUT /frames/reorder路由写在/{frame_id}路由后面,FastAPI 把reorder当成帧 ID 去解析成整数,返回 422 错误。 - 「可以选中并删除实体出生点」→ 不通过:
LevelEditor.tsx:892的删除键处理要求两个状态同时存在,但点击实体只设置了其中一个。
评估者也不是一开始就这么好用。文章说「开箱即用的 Claude 是个糟糕的 QA」:它会发现问题,然后说服自己问题不大,照样放行;测试也停留在表面。改进方法是读评估者的日志,找出它的判断和人不一致的地方,据此修改 QA 提示词,反复几轮。第 37 讲(用 trace 迭代 harness)会把这种「读日志、改 harness」的方法系统化。
07延伸阅读
- David Dworken、Oliver Weller-Davies(Anthropic), Making Claude Code safer with sandboxing, 2025-10-20:anthropic.com
- Yang et al., SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering, 2024:arxiv.org
- Prithvi Rajasekaran(Anthropic), Harness design for long-running application development, 2026-03-24:anthropic.com
08一分钟讲给别人
试着用自己的话讲一遍让 Agent 安全动手靠四件事。隔离:沙箱同时做文件系统隔离(只能改工作目录)和网络隔离(只连批准的域名),两者缺一不可,即使被注入也出不了边界;真正的凭证放在沙箱外,由代理代为使用。审批:每步都问人会造成审批疲劳,改成安全命令和沙箱内动作直接执行、越界才问人,Anthropic 内部弹窗因此减少 84%。恢复:接口层面用 linter 拒绝有语法错误的编辑,用 git 检查点回滚,重试要有上限、要换思路。验证:Agent 评自己容易自夸,所以把评估者独立出来;规划者扩写规格,生成者按冲刺写代码,评估者用 Playwright 实测,每个冲刺先签合同,任一标准不达标就失败。
8 道自测
先在心里答一遍,再展开对照。能说清理由,比答对数字更重要。
01为什么「每个动作都请人批准」反而可能不安全?
02沙箱的两道边界分别是什么?为什么缺一不可?
03云端沙箱为什么不把 git 凭证放进去?那 Agent 怎么更新代码?
04SWE-agent 为什么要在编辑命令里加 linter?
05Agent 在同一个方案上连续失败时,该怎么做?
06为什么要把评估者独立出来,而不是让生成者自己检查?
07冲刺合同解决什么问题?
08评估者一开始「放水」,Anthropic 是怎么改进的?
已看 0/8 题
练动手练习
给一个只需读取资料并生成摘要的 Agent 列出它需要的权限,再给一个会修改工作目录的 Agent 列出权限;逐项问“去掉后任务还能完成吗”,删掉不必要的权限。最后为其中一个高风险动作设计审批点、沙箱边界和回滚点。
完成这一课
读完讲义、看完自测答案,这一课就算学完了。
- 读完讲义
- 看完全部自测
本课为投资者教育内容,案例数字均为示意,不构成任何投资建议,也不承诺收益。规则和费率会变,实际操作前请以交易所、监管机构和产品的最新公告为准。