01学完你能做到
理解「Agent = 模型 + Harness」,能把一个 Agent 产品拆成 harness 的各个组件,并知道为什么工程师的工作重心在转向设计 harness。
从这节开始进入第六模块。前面讲了很多零件:提示词、上下文工程、记忆、工具调用、ReAct、规划、多智能体、MCP。这节给它们一个统一的名字:harness。
Harness 本义是马具:缰绳、马鞍、挽具。马有力气,但要靠马具才能拉车、听指挥。模型就是那匹马。
02定义:不是模型的,都是 harness
LangChain 的 Vivek Trivedy 在《The Anatomy of an Agent Harness》(2026-03-10)里给出公式:
Agent = Model + Harness
If you're not the model, you're the harness.(不是模型的部分,就是 harness。)
Harness 是模型以外的所有代码、配置和执行逻辑。 光有模型不是 Agent,harness 给了它状态、工具执行、反馈循环和可强制执行的约束之后,它才成为 Agent。
文章列出的组成部分:
| 组件 | 例子 | 前面哪节讲过 |
|---|---|---|
| 系统提示词 | 角色、规则、输出要求 | 第 22 讲(什么是上下文工程) |
| 工具、Skills、MCP 及其描述 | 搜索、读写文件、MCP 服务器 | 第 29、33 讲 |
| 自带的基础设施 | 文件系统、沙箱、浏览器 | 本节,第 36 讲(权限、沙箱与错误恢复) |
| 编排逻辑 | 起子智能体、交接、选模型 | 第 32 讲(多智能体) |
| 钩子和中间件(确定性执行) | 压缩、续跑、lint 检查 | 第 27 讲(压缩与隔离) |
演示:你每天都在用的最简单的 harness
文章举的例子:模型本身只能「输入文字,输出文字」。要做成「聊天」产品,就得在外面套一个循环(示意代码):
历史 = []
while True:
    用户说 = input()
    历史.append(用户说)
    回复 = 模型(历史)      # 模型每次都看完整历史
    历史.append(回复)
    print(回复)
模型本身不记得上一句话,「记得」是这个 while 循环和 历史 列表提供的。这个循环就是 harness。ChatGPT、Claude 的聊天界面,本质上都是更复杂的版本。
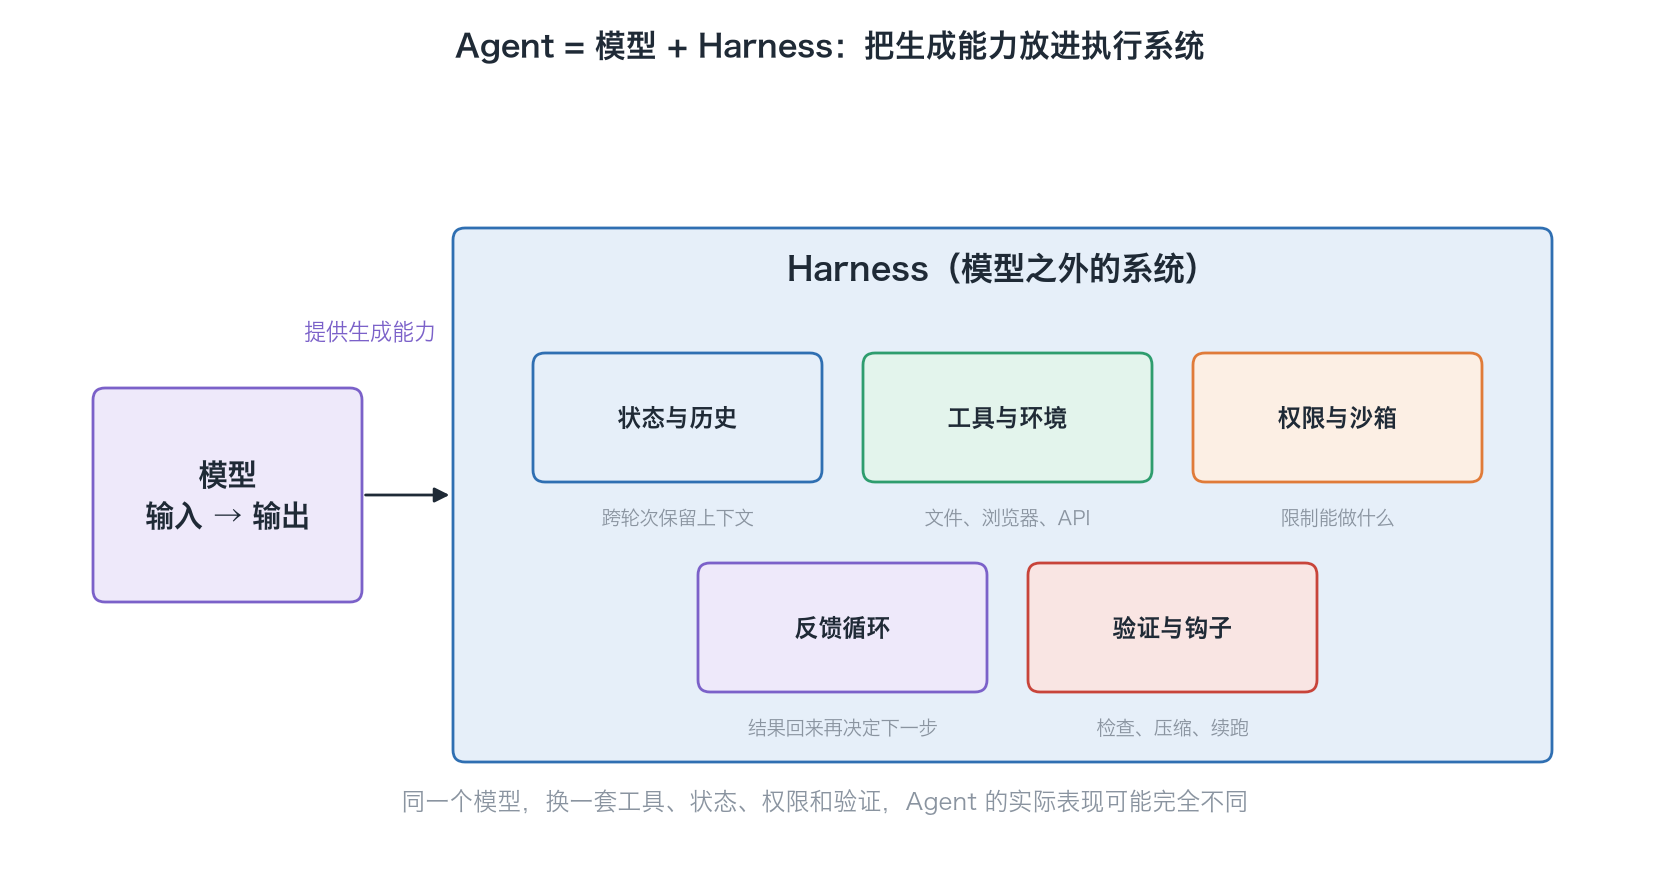
03从「想要的行为」倒推组件
LangChain 文章的核心方法是:先问「模型自己做不到什么」,再用 harness 补上。模型开箱即用时做不到:
- 跨交互保存状态;
- 执行代码;
- 获取实时知识;
- 搭环境、装依赖。
文章按「想要的行为 → harness 设计」逐个推导:
- 文件系统:文章说它可能是最基础的 harness 原语。Agent 有了工作区,放不进上下文的东西可以写到文件里,工作也能跨会话保留。多个 Agent 和人可以通过共享文件协作。再加上 git,就能追踪进度、回滚错误。
- bash + 代码执行:与其给每个动作预先做一个工具,不如给一个通用工具 bash,让模型自己写代码解决问题。
- 沙箱:在本地跑 Agent 生成的代码有风险,所以放进隔离环境,可以白名单命令、隔离网络,用完就销毁。沙箱里要预装运行时、git、测试工具、浏览器,让 Agent 能自己验证:写代码、跑测试、看日志、修错。
- 记忆和搜索:模型的知识只有权重和当前上下文。
AGENTS.md这类记忆文件在启动时注入上下文(记忆的概念见第 26 讲(记忆));网络搜索补上训练截止之后的新知识。 - 对抗上下文腐化(第 23 讲(上下文窗口与上下文腐化)):压缩、把大段工具输出卸载到文件只留头尾、用 Skills 渐进披露,不在一开始把所有工具都塞进上下文。
- 长时间自主执行:文件系统和 git 记录进度;Ralph 循环用钩子拦截模型的「我做完了」,在干净的新窗口里重新注入原始目标,让它接着做;计划文件和自我验证防止跑偏。第 35 讲(工具循环、状态与长任务)专门讲长任务。
文章的一句话总结:今天的 harness 很大程度上是交付良好上下文工程的载体。
04同一个模型,换 harness 差多少
LangChain 文章举了两个例子:
- 在 Terminal Bench 2.0 排行榜上,Opus 4.6 跑在 Claude Code 里,得分远低于跑在其他 harness 里。
- LangChain 自己的编码 Agent 只改 harness,排名就从第 30 名左右升到前 5 名(具体怎么改的,第 37 讲(用 trace 迭代 harness)细讲)。
还有一个反直觉的现象:Claude Code、Codex 这类产品的模型是带着 harness 一起后训练的,模型会对自己那套 harness「过拟合」。文章引用 Codex 提示指南的例子:换一种改文件的工具逻辑(apply_patch),模型表现就变差。所以模型训练时用的 harness,不一定是你的任务最好的 harness。
由此可见:比较 Agent 时不能只比模型,模型 × harness 要一起评(评测方法见第 38 讲(评测))。
05OpenAI 的实践:Harness engineering
OpenAI 的 Ryan Lopopolo 在《Harness engineering》(2026-02-11)里讲了一个实验。团队用 5 个月做出一个内部产品,人一行代码都没写,全部代码由 Codex 生成。
规模:
- 约 100 万行代码;
- 约 1,500 个 PR 合入;
- 起初 3 名工程师,平均每人每天 3.5 个 PR;团队扩到 7 人后,人均吞吐反而上升;
- 他们估计只用了手写代码约 1/10 的时间;
- 单次 Codex 运行常常连续做一个任务超过 6 小时,往往是在人睡觉的时候。
核心观点:工程师的主要工作不再是写代码,而是设计环境、说清意图、搭建反馈循环,让 Agent 可靠地工作。文章的口号是:「Humans steer. Agents execute.」(人掌舵,Agent 执行。)
一开始进展慢,并不是 Codex 能力不够,而是环境描述不足。遇到失败时,修法几乎从来不是「再努力一点」,而是问:
缺了什么能力?怎么让它对 Agent 既看得见又强制得了?
演示:拆解 OpenAI 的 harness
| harness 组件 | OpenAI 的做法 |
|---|---|
| 系统提示词 / 记忆 | AGENTS.md 只写约 100 行,当目录用,指向 docs/ 下的详细文档 |
| 知识库 | docs/ 里有设计文档、执行计划(含进度和决策日志)、产品规格,全部进 git |
| 让 Agent 看得见 | 每个 git worktree 都能启动一份应用;接入 Chrome DevTools 协议,Agent 能截图、看 DOM;日志和指标可以用 LogQL、PromQL 查询 |
| 强制约束 | 自定义 linter 和结构测试,强制分层依赖方向;lint 报错信息里直接写修复方法,让 Agent 读到就会改 |
| 反馈循环 | Codex 自审,再请其他 Agent 审,循环到所有审查者满意(文章说这其实就是 Ralph Wiggum 循环) |
| 垃圾回收 | 后台 Codex 任务定期扫描偏离「黄金原则」的代码,开小 PR 清理,大多一分钟内审完 |
为什么 AGENTS.md 不写成一本大手册?文章列了四个失败原因:
- 上下文是稀缺资源,大手册会挤掉任务本身;
- 什么都标「重要」,等于什么都不重要;
- 很快过时,变成过期规则的坟场;
- 一整块文本没法机械检查新鲜度和交叉链接。
文章还有一句话:从 Agent 的角度看,运行时在上下文里拿不到的东西就等于不存在。 存在 Google Docs、聊天记录或人脑子里的知识,Agent 都看不见。
由此得出一条通用原则:希望 Agent 遵守的规则,要写进 Agent 运行时读得到的地方,最好再用自动检查强制执行;只在聊天里提过、没有写进运行环境的规则,Agent 看不到。
「垃圾回收」的由来
OpenAI 团队起初每周五(一周 20% 的时间)手工清理「AI 垃圾代码」,这种做法无法扩展。Codex 会复制仓库里已有的模式,包括不好的模式,代码会逐渐偏离。所以他们把人的品味写成规则,交给后台 Agent 持续清理。用文章的比喻:技术债像高利贷,小额持续还款好过攒成一大笔。
06Harness 会过时吗
两篇文章的看法一致:
- 模型变强后,今天 harness 里的一部分能力会被模型吸收,比如规划、自我验证、长程连贯(LangChain)。
- 但好的环境、合适的工具、持久状态和验证循环,对任何模型都有用。就像提示工程到今天仍然有价值,harness 工程也会继续有用。
第 35 讲(工具循环、状态与长任务)会看到 Anthropic 的具体例子:模型升级后,原来必须的组件被拆掉了。
07延伸阅读
- Vivek Trivedy(LangChain), The Anatomy of an Agent Harness, 2026-03-10:langchain.com
- Ryan Lopopolo(OpenAI), Harness engineering: leveraging Codex in an agent-first world, 2026-02-11:openai.com
08一分钟讲给别人
试着用自己的话讲一遍Agent = 模型 + Harness。Harness 是模型以外的所有代码、配置和执行逻辑:系统提示词,工具、Skills、MCP,文件系统、沙箱、浏览器,编排逻辑,以及压缩、续跑、lint 这类钩子。最简单的 harness 就是聊天产品外面那个 while 循环。设计方法是从「模型做不到什么」倒推:要持久状态就给文件系统和 git;要通用能力就给 bash;要安全和自我验证就给沙箱和测试工具;要新知识就给记忆和搜索;怕腐化就压缩、卸载、渐进披露;要长时间工作就用 Ralph 循环和计划文件。同一个模型换 harness,排名能差很多。OpenAI 用 Codex 零手写代码做出百万行产品:工程师的工作变成设计环境、说清意图、搭反馈循环。`AGENTS.md` 只当约 100 行的目录,规则尽量用 linter 强制,后台 Agent 定期「垃圾回收」。
8 道自测
先在心里答一遍,再展开对照。能说清理由,比答对数字更重要。
01用一句话说出 harness 的定义。
02为什么说聊天产品里的 while 循环也是 harness?
03LangChain 认为哪个组件可能是最基础的 harness 原语?它解锁了什么?
04什么是 Ralph 循环?它依赖哪个 harness 组件?
05「模型和 harness 一起后训练」带来什么副作用?对选型有什么启示?
06OpenAI 团队遇到 Agent 失败时,问的关键问题是什么?
07为什么 OpenAI 不把 `AGENTS.md` 写成大手册?他们怎么做?
08「运行时在上下文里拿不到的东西就等于不存在」,这句话对设计 Agent 有什么影响?
已看 0/8 题
练动手练习
挑一个你常用的 AI 工作流,例如让 AI 整理一份公告。先写出模型本身做不到、但产品必须提供的三件事,再为每件事配一个 harness 组件(如文件、工具、权限或检查);最后删掉其中一个组件,预测会出现什么失败。
完成这一课
读完讲义、看完自测答案,这一课就算学完了。
- 读完讲义
- 看完全部自测
本课为投资者教育内容,案例数字均为示意,不构成任何投资建议,也不承诺收益。规则和费率会变,实际操作前请以交易所、监管机构和产品的最新公告为准。