01学完你能做到
理解模型是怎么一步一步「变好」的。
上一节说训练就是「拧旋钮」。这一节回答两个问题:怎么衡量拧得好不好?往哪个方向拧?
02损失函数:给「错得多离谱」打分
损失函数(loss)是一个数字,模型错得越多,它越大。训练的目标就是让它尽量小。
例:预测房价。 真实房价 y=500 万,模型预测 p=480 万。
- 均方误差(MSE):(p − y)² = (480−500)² = 400。错 20 万罚 400,错 40 万罚 1600,错得越大罚得越狠。
- 对多套房子,把每套的误差平方求平均。
分类问题常用交叉熵:模型给正确答案的概率是 q,损失 = −log(q)。
- 正确答案概率 0.9 → 损失 0.105(很小)
- 正确答案概率 0.1 → 损失 2.303(很大)
- 概率接近 0 → 损失趋向无穷
大语言模型训练用的就是交叉熵:每一步看模型给「真实的下一个词」分配了多少概率(第 4 讲(词向量与语言模型))。
03梯度:坡往哪边倾斜
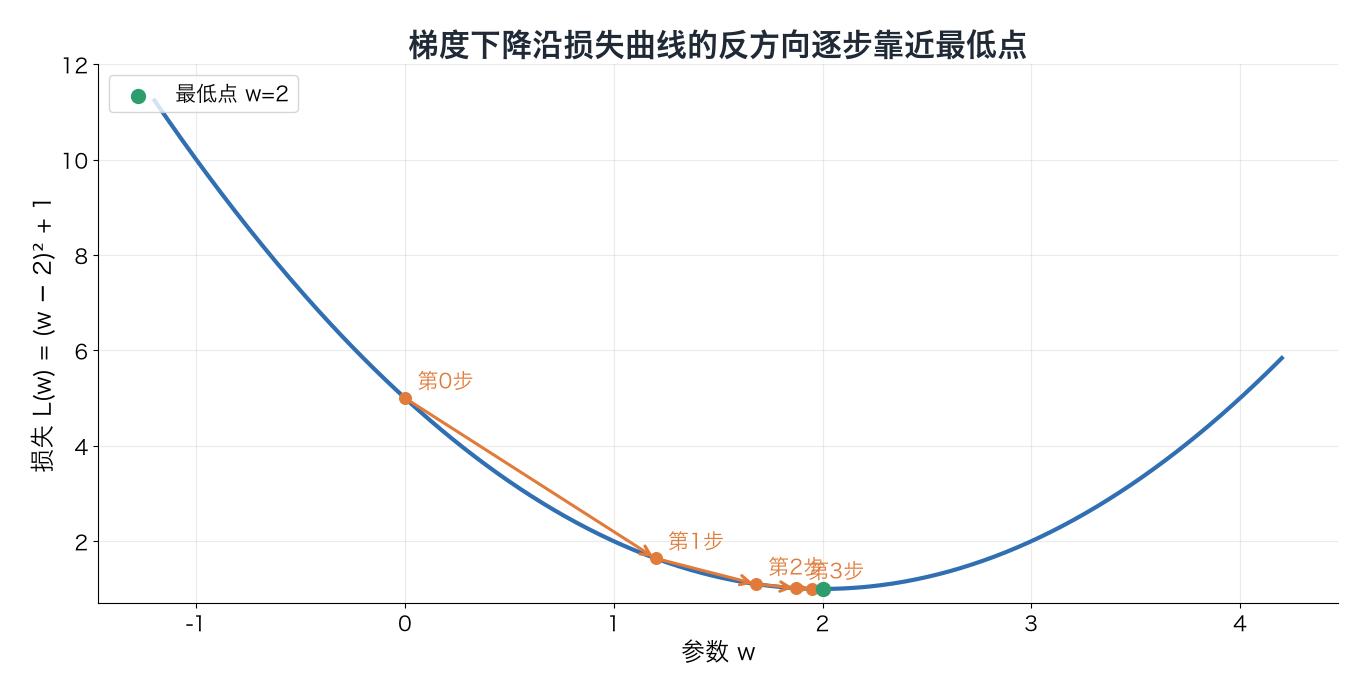
假设模型只有一个旋钮 w,损失随 w 变化是一条碗形曲线:L(w) = (w − 2)² + 1。最低点在 w=2。但模型「看不到」整条曲线,它只知道自己脚下的坡度。
梯度(一维时就是导数)告诉你:w 往右挪一点点,损失会变大还是变小、变多快。
- 梯度为正 → 往右走损失变大 → 应该往左走。
- 梯度为负 → 应该往右走。
- 所以规则是:沿梯度的反方向走。
对 L(w) = (w−2)²+1,梯度是 dL/dw = 2(w − 2)。(高中求导:x² 的导数是 2x。)
04梯度下降:手算三步
更新公式只有一行:
w_新 = w_旧 − 学习率 × 梯度
取起点 w=0,学习率 η=0.3:
| 步 | 当前 w | 损失 L | 梯度 2(w−2) | 更新 w − 0.3×梯度 |
|---|---|---|---|---|
| 0 | 0 | 5 | −4 | 0 − 0.3×(−4) = 1.2 |
| 1 | 1.2 | 1.64 | −1.6 | 1.2 + 0.48 = 1.68 |
| 2 | 1.68 | 1.1024 | −0.64 | 1.68 + 0.192 = 1.872 |
| 3 | 1.872 | 1.0164 | −0.256 | 1.9488 |
看到规律了吗?每一步离 2 的距离都缩小到原来的 40%,损失从 5 一路降到接近最低值 1。而且越靠近底部坡越缓,步子自动变小。
真实模型有几十亿个旋钮,就是几十亿维的「碗」。梯度是一个向量,每个分量告诉对应旋钮该往哪拧,但公式完全一样。
- 1取一小批数据计算模型输出
- 2计算损失比较预测和目标
- 3计算梯度找出参数影响
- 4更新参数沿反方向走一步
回到第 1 步:重复许多次直到效果稳定
05学习率:步子迈多大
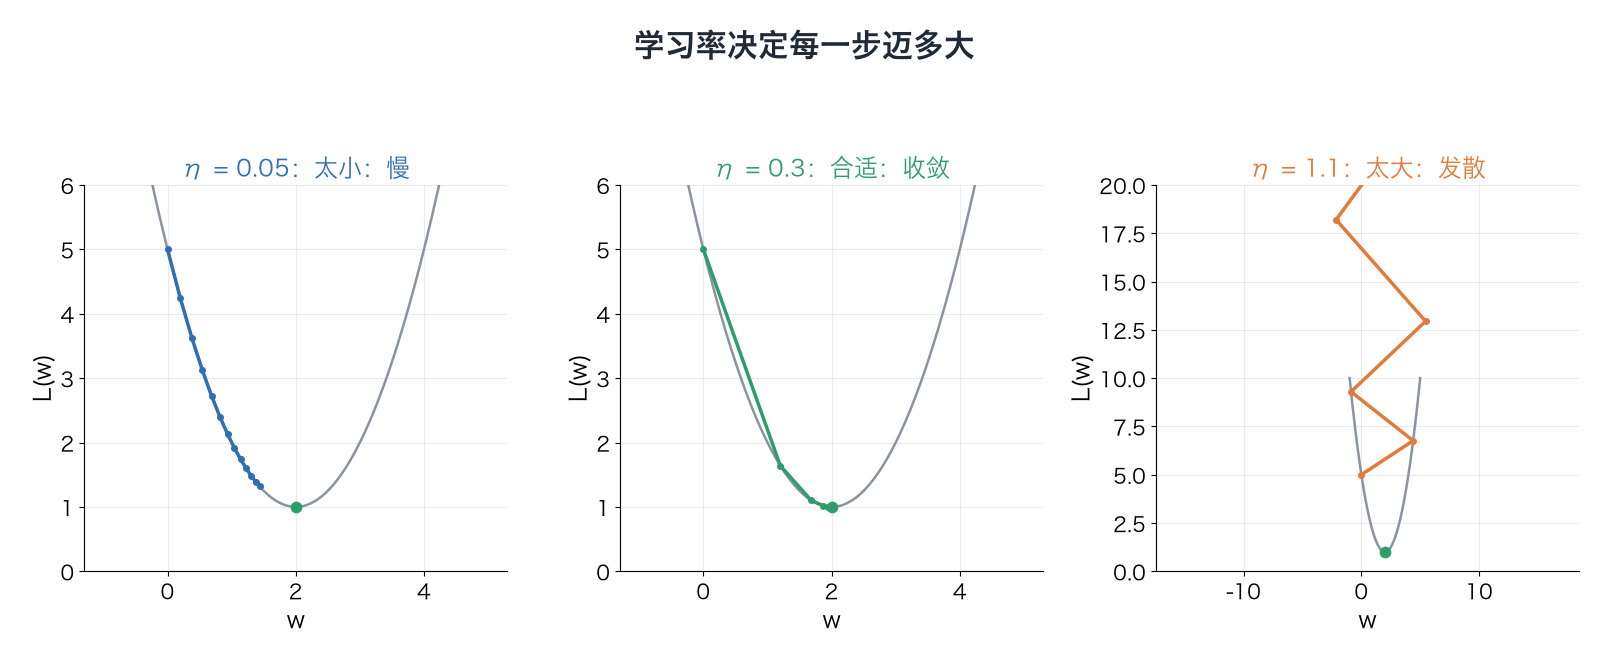
学习率 η 是人定的超参数。同一个碗,三种学习率:
- 太小(0.05):每次只挪一点点,走 8 步还远没到底,训练很慢。
- 合适(0.3):几步就到底。
- 太大(1.05):一步迈过最低点,到了对面更高的地方,越跳越高,发散。
手算:w=0,梯度 −4,w_新 = 0 + 1.05×4 = 4.2;梯度 4.4,w_新 = 4.2 − 4.62 = −0.42……离 2 越来越远。
实践中常用「先小后大再慢慢变小」的学习率调度(预热 + 衰减),以及 Adam 这类会自动调节每个参数步长的优化器。
06批量、随机与小批量
损失通常是所有训练样本损失的平均。精确的梯度需要把全部数据算一遍。
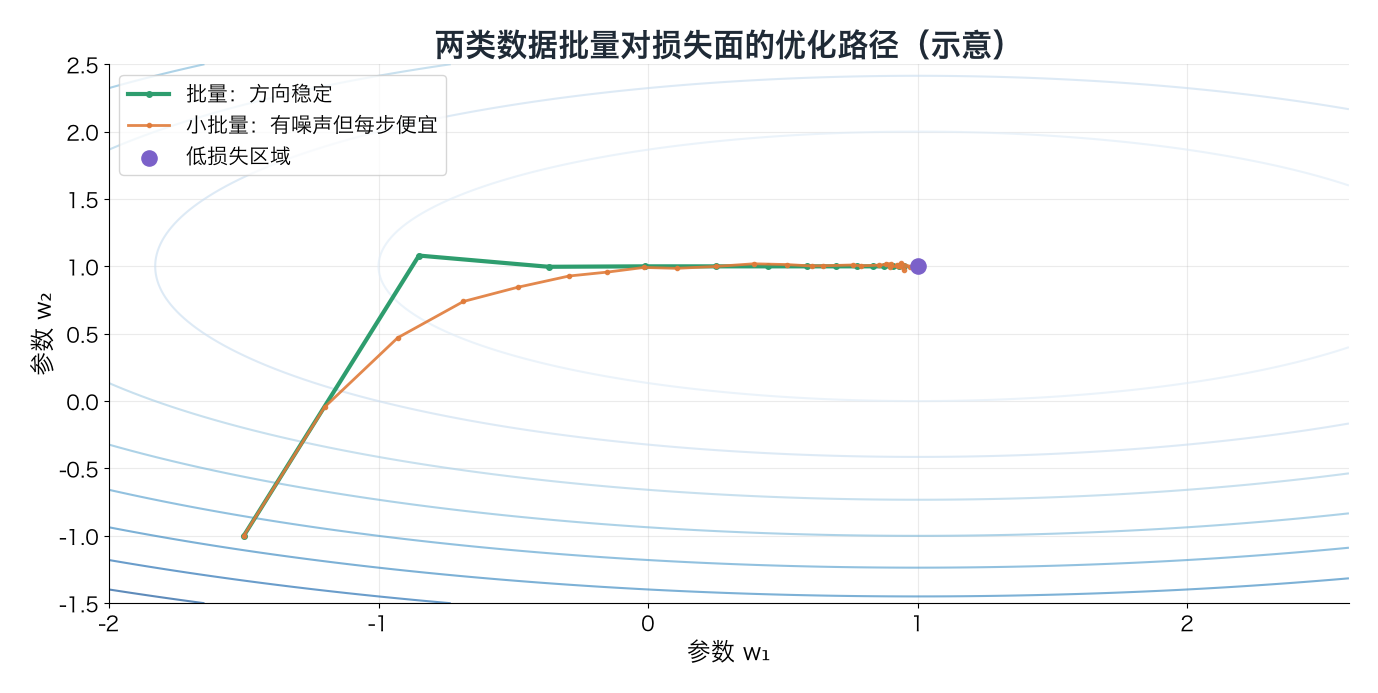
- 批量梯度下降:每一步看全部数据。方向准,但数据有几亿条时一步就要很久。
- 随机梯度下降(SGD):每一步只随机看 1 条。很便宜,但方向有噪声,路径抖动。
- 小批量(mini-batch):每步看比如 32 或 1024 条,折中。今天几乎都用它,「batch size」就是指这个。
图是一个两参数损失的「等高线俯视图」(像地图上的等高线,中心最低)。绿线平稳直奔中心;红线东倒西歪,但大方向也是朝中心走,而且每一步便宜得多。噪声有时还帮模型跳出不好的局部低谷。
几个术语:一个 step / iteration = 一次参数更新;一个 epoch = 把整个训练集完整过一遍。1 万条数据、batch 100 → 一个 epoch 是 100 步。
07现实的复杂性
真实损失面不是光滑的碗,有局部低谷、平台、鞍点。梯度下降不保证找到全局最低点,但大量实践表明,对大型神经网络,找到的「足够低」的点通常泛化很好。
08延伸阅读
- 《动手学深度学习》3.1 节「线性回归」(含损失函数、小批量随机梯度下降):zh.d2l.ai
- 《动手学深度学习》11.4 节「随机梯度下降」:zh.d2l.ai
- 3Blue1Brown 神经网络系列(第 2 集讲梯度下降):3blue1brown.com
- Kingma & Ba, Adam: A Method for Stochastic Optimization, 2014:arxiv.org
09一分钟讲给别人
试着用自己的话讲一遍损失函数把「模型错了多少」变成一个数字,训练就是让它最小。梯度告诉我们每个参数往哪边动损失会上升,所以沿反方向迈一步:w 减去学习率乘以梯度,反复迭代。学习率太小训练慢,太大会震荡发散。数据太多时每步只用一小批样本估计梯度,这就是小批量随机梯度下降。
5 道自测
先在心里答一遍,再展开对照。能说清理由,比答对数字更重要。
01真实值 10,预测 7,均方误差是多少?
02某点梯度是 +3,参数应该增大还是减小?
03L(w)=(w−2)²+1,w=3,学习率 0.5,更新一步后 w 是多少?
04训练中损失忽高忽低并越来越大,最可能是什么原因?
055 万条数据,batch size 500,一个 epoch 有多少步?
已看 0/5 题
练动手练习
在纸上画一条“碗形”曲线,标出最低点,再任选一个不在最低点的位置。假设梯度为正或为负,分别写出参数应该向左还是向右移动;然后用学习率 0.1 和 1.0 比较步子大小。
完成这一课
读完讲义、看完自测答案,这一课就算学完了。
- 读完讲义
- 看完全部自测
本课为投资者教育内容,案例数字均为示意,不构成任何投资建议,也不承诺收益。规则和费率会变,实际操作前请以交易所、监管机构和产品的最新公告为准。