01学完你能做到
知道多层网络是怎么算的,误差是怎么往回传的。
02神经元:加权求和 + 一个弯
一个人工神经元做两件事:
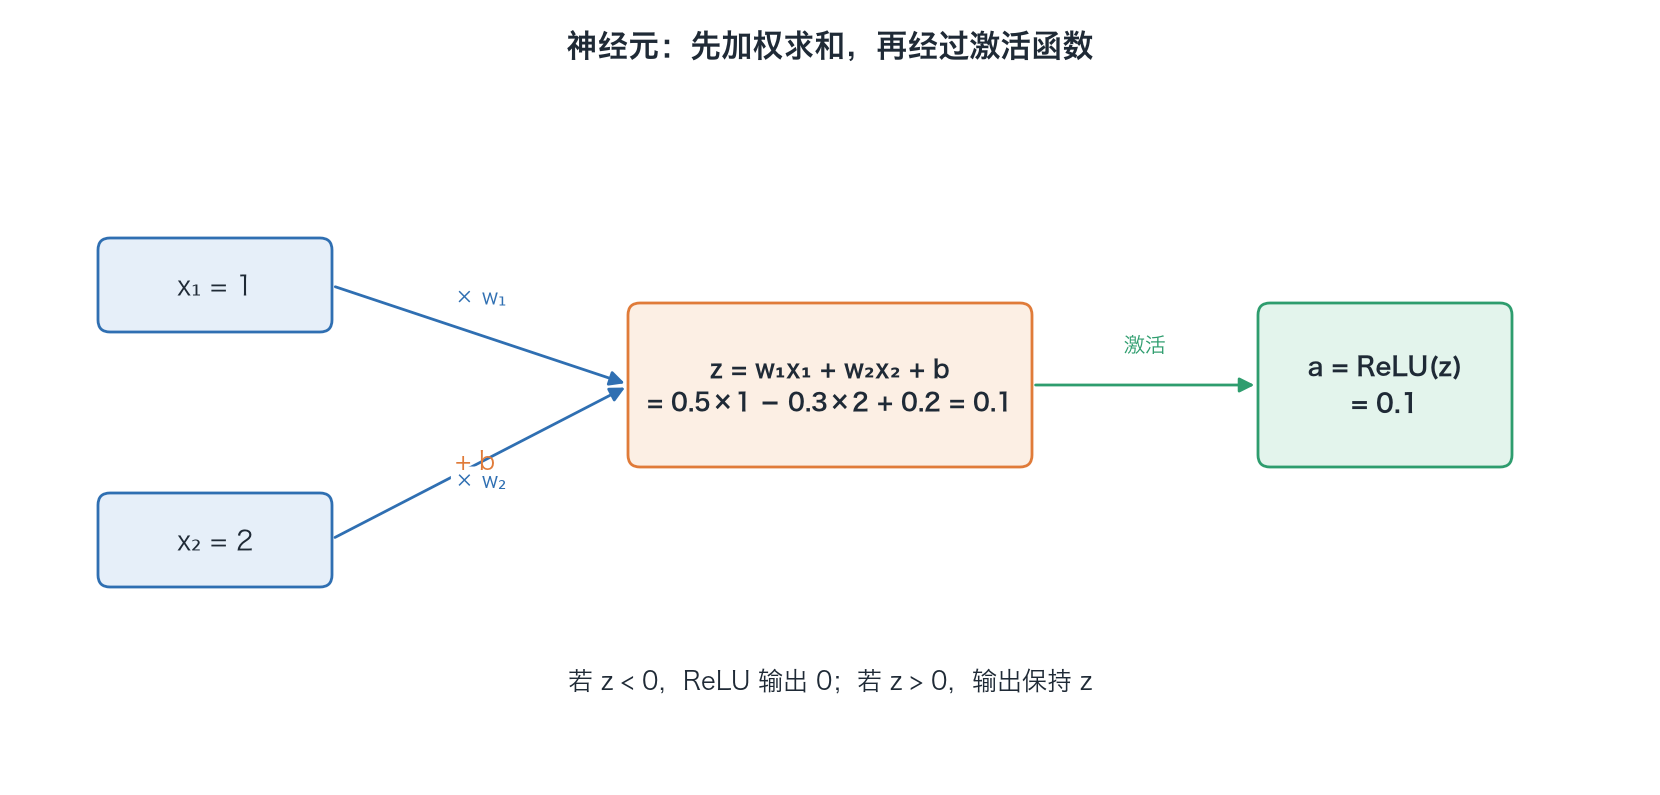
- 加权求和:z = w1·x1 + w2·x2 + b。w 是权重(这个输入有多重要),b 是偏置(基准线)。
- 激活函数:a = f(z),把结果「掰弯」一下。
数值演示:x1=1,x2=2,w1=0.5,w2=−0.3,b=0.2。z = 0.5×1 + (−0.3)×2 + 0.2 = 0.5 − 0.6 + 0.2 = 0.1;ReLU(0.1) = 0.1。如果 b=−0.2,则 z=−0.3,ReLU 输出 0:这个神经元「没被激活」。
03为什么一定要激活函数
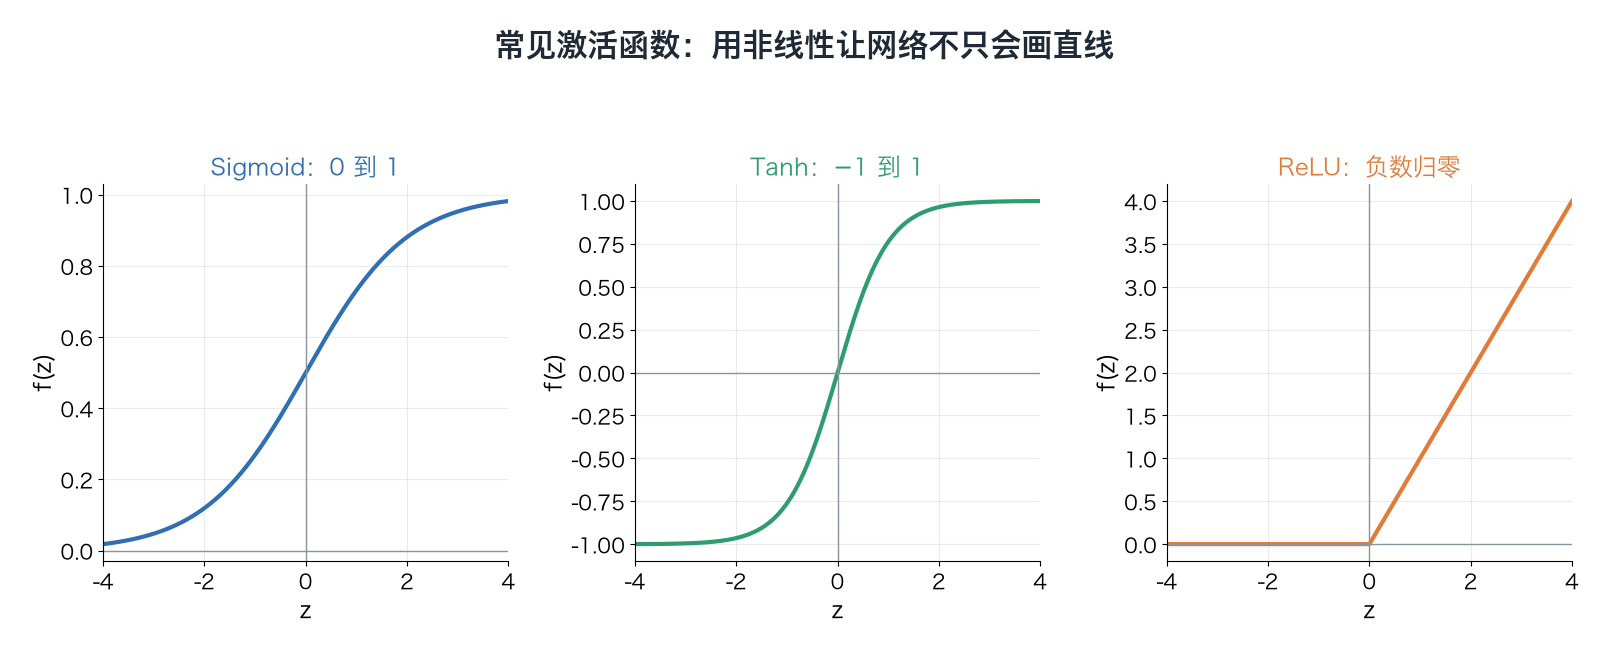
如果没有激活函数,每层都只是「乘一下加一下」。两层叠起来:y = w2·(w1·x) = (w2·w1)·x,还是一条直线。叠一百层也等价于一层,学不出复杂的规律。激活函数引入「弯」,很多弯拼起来就能逼近任意复杂的形状。
- Sigmoid:把任何数压到 0\~1,适合表示概率;缺点是两头太平,梯度几乎为 0。
- Tanh:压到 −1\~1,以 0 为中心。
- ReLU:负数变 0,正数不变。简单、算得快、正数区梯度恒为 1,是深度网络的主力。大模型里常见的 GELU、SwiGLU 是它的平滑变体。
04多层网络与前向计算
把很多神经元排成一层,再把多层串起来:输入层 → 隐藏层 → … → 输出层。这叫多层感知机(MLP)。前向计算就是从输入开始,一层一层算到输出。每层的输出是下一层的输入。直觉上:浅层学简单特征(图像里的边缘),深层把简单特征组合成复杂概念(眼睛、脸)。
05反向传播:把「责任」分配回每个参数
上节课说训练要用梯度:每个参数对损失的影响。可网络有成千上万个参数、隔着好多层,怎么算?答案是链式法则。
链式法则直觉:齿轮 A 转 1 圈带动 B 转 3 圈,B 转 1 圈带动 C 转 2 圈,那 A 转 1 圈 C 转 3×2=6 圈。影响沿链条相乘。
手算一个两层小网络
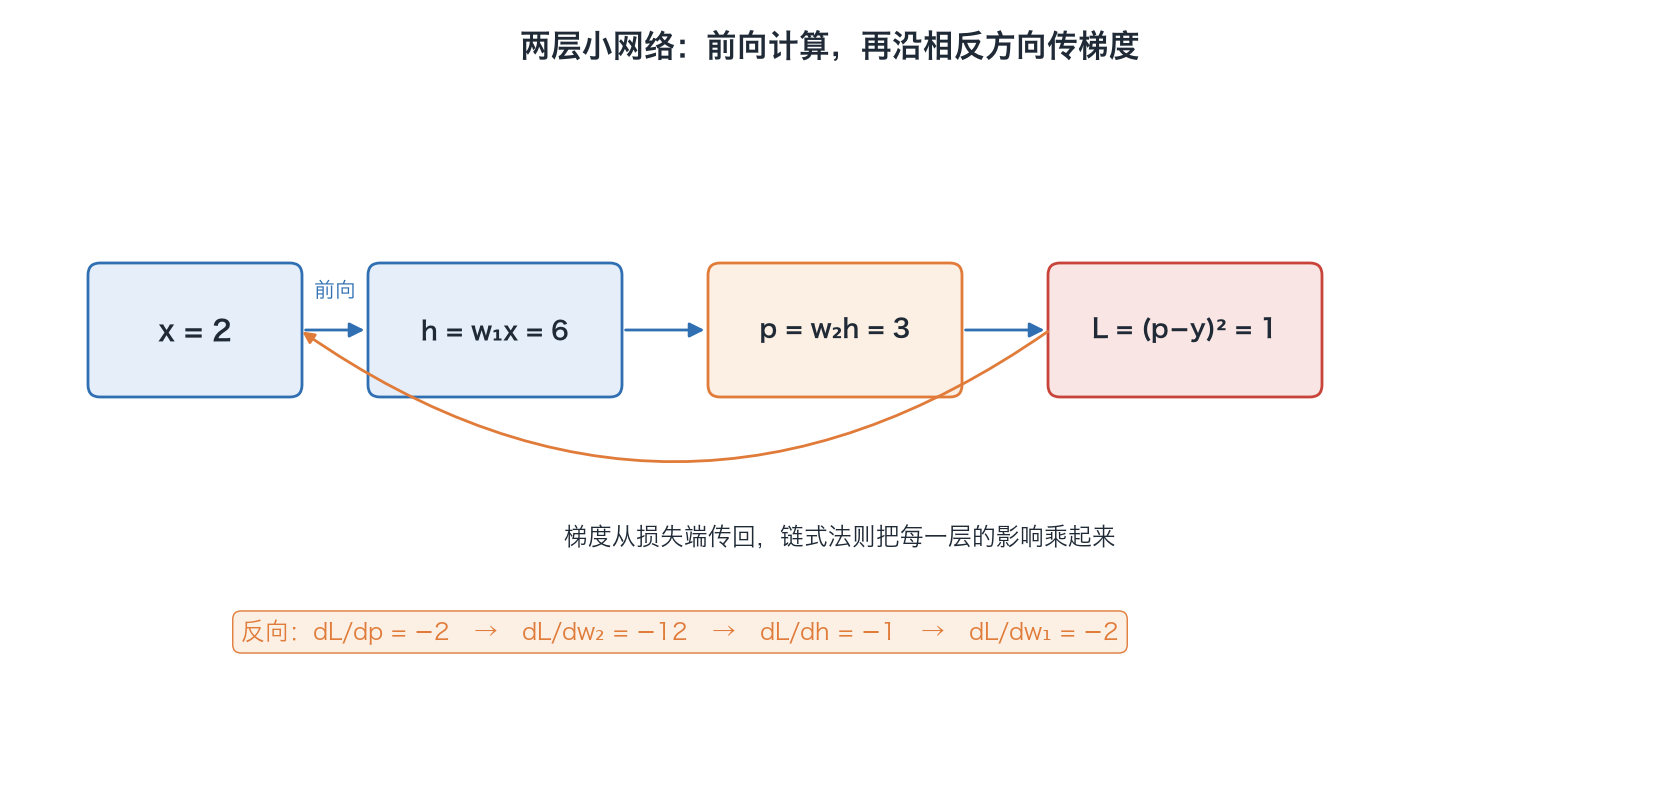
网络:h = w1·x,p = w2·h,损失 L = (p − y)²(为了好算,不加激活和偏置)。已知 x=2,y=4(正确答案),w1=3,w2=0.5。
第 1 步:前向
- h = 3×2 = 6
- p = 0.5×6 = 3
- L = (3 − 4)² = 1
第 2 步:反向(从后往前)
- 损失对输出:∂L/∂p = 2(p − y) = 2×(3−4) = −2
(意思:p 再大一点,损失就会变小)
- 对 w2:p = w2·h,所以 ∂p/∂w2 = h = 6 → ∂L/∂w2 = −2 × 6 = −12
- 继续往回传给 h:∂p/∂h = w2 = 0.5 → ∂L/∂h = −2 × 0.5 = −1
- 对 w1:h = w1·x,∂h/∂w1 = x = 2 → ∂L/∂w1 = −1 × 2 = −2
注意 ∂L/∂h 被算了一次就复用来求 w1 的梯度。这就是反向传播高效的原因:每个中间结果的梯度只算一次,从输出往输入一路传。
第 3 步:梯度下降更新(学习率 0.01)
- w2 = 0.5 − 0.01×(−12) = 0.62
- w1 = 3 − 0.01×(−2) = 3.02
第 4 步:验证:再前向一次,h = 3.02×2 = 6.04,p = 0.62×6.04 ≈ 3.745,L = (3.745−4)² ≈ 0.065。损失从 1 降到了 0.065,一步就好了很多。
训练循环就是:前向算损失 → 反向算梯度 → 更新参数 → 重复几百万次。
- 1前向计算从输入算到输出
- 2计算损失比较预测和目标
- 3反向传播按链式法则求梯度
- 4更新参数沿梯度反方向调整
回到第 1 步:反复迭代直到效果稳定
06几个要点
- 现代框架(PyTorch 等)会自动求导,工程师不用手推,但原理就是上面这几步。
- 梯度要穿过每一层的激活函数。如果像 Sigmoid 那样在两端导数接近 0,连乘很多层后梯度就消失了,这正是 ReLU 和后面「残差连接」流行的原因(第 5、8 讲会再碰到)。
- 大模型的「参数量 70B」指的就是所有 w 和 b 加起来有 700 亿个。
07延伸阅读
- 《动手学深度学习》4.1 节「多层感知机」:zh.d2l.ai
- 《动手学深度学习》4.7 节「前向传播、反向传播和计算图」:zh.d2l.ai
- Karpathy, Neural Networks: Zero to Hero(第 1 集 micrograd 从零实现反向传播):karpathy.ai
- 3Blue1Brown 神经网络系列(第 3、4 集讲反向传播):3blue1brown.com
- Rumelhart, Hinton & Williams, Learning representations by back-propagating errors, Nature 323, 1986:nature.com
08一分钟讲给别人
试着用自己的话讲一遍神经元把输入加权求和,再过一个激活函数;没有激活函数,多层叠加仍是直线。很多神经元分层串起来就是神经网络,从输入一层层算到输出叫前向计算。反向传播用链式法则,从损失出发往回逐层求每个参数的梯度,中间结果可以复用,然后用梯度下降更新参数。训练就是不断重复前向、反向、更新。
5 道自测
先在心里答一遍,再展开对照。能说清理由,比答对数字更重要。
01为什么神经网络需要激活函数?
02输入 x1=2,x2=1,w1=1,w2=−3,b=0.5,经过 ReLU 输出多少?
03在本节小网络中,若 y=3(其他不变),∂L/∂w2 是多少?
04反向传播为什么叫「反向」?
05ReLU 相比 Sigmoid 的一个主要优势?
已看 0/5 题
练动手练习
在纸上画出 x→h→p→损失 L 的两层小网络,随便给每条边写一个数。先从左到右算一次输出,再从右到左标出“哪一个中间结果的梯度可以复用”;用一句话说明为什么反向传播比逐个参数重新计算更高效。
完成这一课
读完讲义、看完自测答案,这一课就算学完了。
- 读完讲义
- 看完全部自测
本课为投资者教育内容,案例数字均为示意,不构成任何投资建议,也不承诺收益。规则和费率会变,实际操作前请以交易所、监管机构和产品的最新公告为准。