01学完你能做到
说清「从数据里学规律」和「人写规则」有什么不一样。
02两种做事方式
先看一个日常问题:判断一封邮件是不是垃圾邮件。
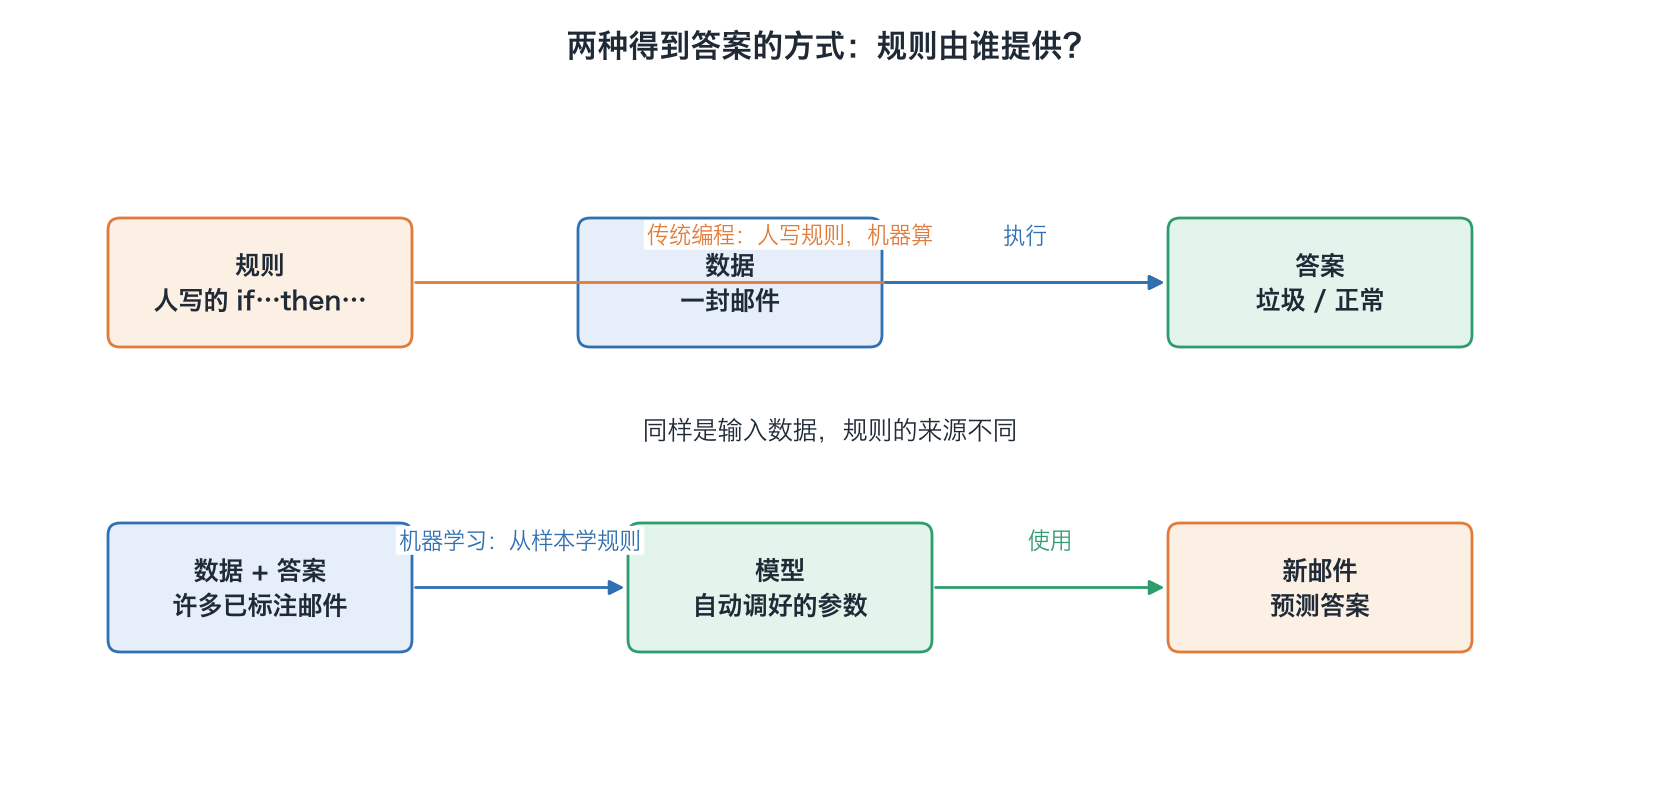
方式 A:人写规则(传统编程)程序员坐下来想:标题里有「中奖」就算垃圾;有「免费领取」也算;发件人在黑名单里也算……写成一堆 如果…就…。问题马上就来:骗子把「中奖」改成「中 奖」,规则就失效了;规则越写越多,彼此打架,没人维护得动。
方式 B:让机器从数据里学(机器学习)收集 10 万封邮件,每封都由人标好「垃圾 / 正常」。把它们交给一个算法,算法自己找出哪些特征和「垃圾」相关、各自有多重要。最后得到的东西叫模型,它其实就是一套被自动调好的「规则」。
一句话:传统编程是「规则 + 数据 → 答案」;机器学习是「数据 + 答案 → 规则」。
「模型」到底是什么
把模型想成一台带很多旋钮的机器。旋钮就是参数。输入一封邮件,机器按旋钮的位置算出一个「垃圾概率」。「训练」就是不停拧旋钮,让机器在已知答案的邮件上尽量答对。今天的大语言模型,本质上也是这样一台机器,只是旋钮有几百亿到上万亿个。
03三大类学习
| 类型 | 有没有标准答案 | 学什么 | 例子 |
|---|---|---|---|
| 监督学习 | 有(标签) | 输入 → 输出的映射 | 垃圾邮件分类、房价预测 |
| 无监督学习 | 没有 | 数据自身的结构 | 用户分群、异常检测 |
| 强化学习 | 没有现成答案,只有事后奖励 | 一连串动作的策略 | 下围棋、机器人走路 |
- 监督学习又分两种:答案是类别(垃圾/正常)叫分类;答案是数字(房价 532 万)叫回归。
- 无监督学习:给你 1 万个用户的消费记录,不告诉你谁是什么类型,算法自己发现「有一群人只在月底买东西」。
- 强化学习:没人告诉你每一步该怎么走,只在棋局结束时告诉你赢了还是输了。模型要自己琢磨哪些步子导致了胜利。
和后面课程的联系:大语言模型的预训练用的是「自监督」,即从文本自己造标签(把下一个词遮住让模型猜),可以看成监督学习的一种变体;RLHF / 推理模型训练用的是强化学习(第 11、13 讲)。
- 监督学习有标签:输入 → 标准答案
- 无监督学习无标签:发现数据结构
- 强化学习行动后:根据奖励调整策略
三类学习不是先后步骤,而是三种不同的反馈来源。
04训练集与测试集:别让模型偷看考卷
演示:一个小例子。 假设有 100 封带标签的邮件。
- 随机拿 80 封做训练集:模型只用它们拧旋钮。
- 剩下 20 封做测试集:训练时完全不给模型看。
- 训练完,在测试集上考一次:答对 18 封 → 测试准确率 90%。
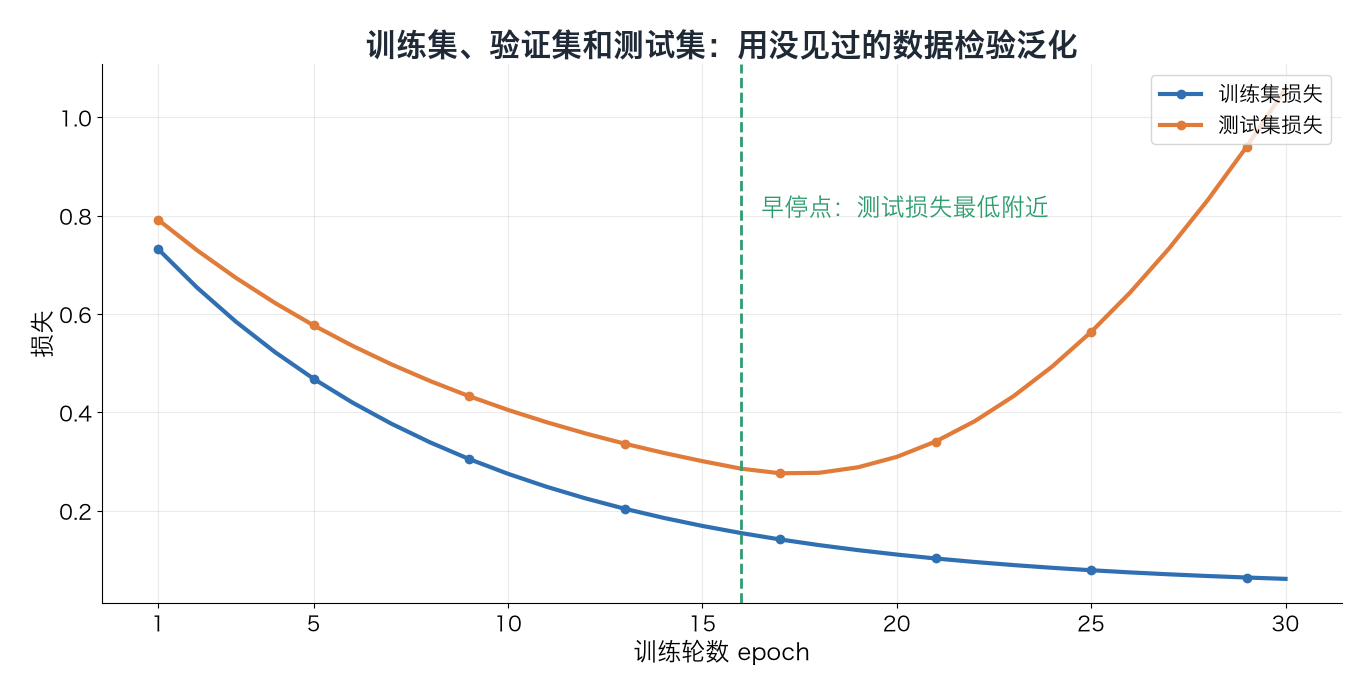
为什么要这样?如果用训练过的那 80 封来考,模型可能只是「背下了答案」,分数虚高。测试集模拟的是未来没见过的新邮件,它的分数才说明模型真实的本事。实际中还常再分出一份验证集,用来挑超参数(比如模型大小),避免反复看测试集,导致测试集也被间接「背下来」。
05过拟合与泛化
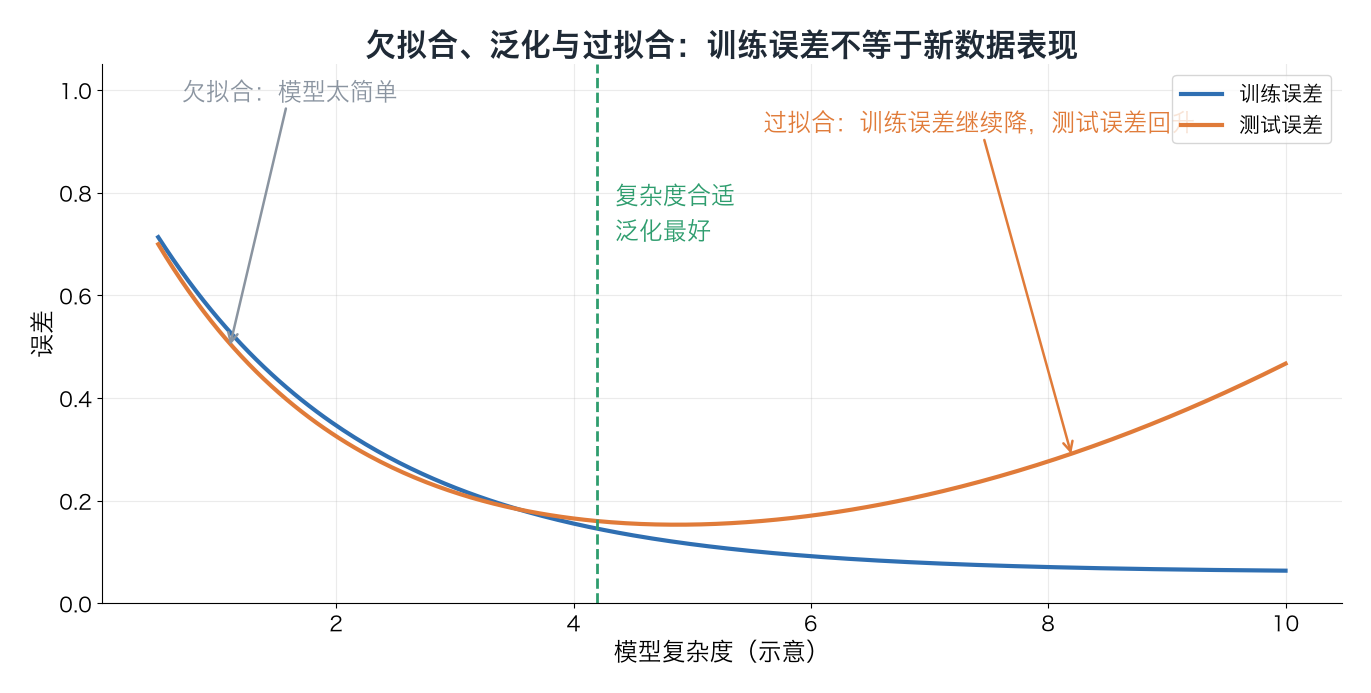
泛化:在没见过的数据上也表现好。这才是学习的目的。
下面用 12 个带噪声的点(真实规律是一条正弦曲线,绿色虚线)拟合三种复杂度的曲线:
- 欠拟合(1 次直线):模型太简单,连训练数据的大势都抓不住。训练、测试都差。
- 刚好(3 次曲线):抓住了起伏的大趋势,忽略了噪声。
- 过拟合(11 次曲线):完美穿过每一个训练点,但在点和点之间疯狂乱摆。它把噪声当成了规律,新数据一来就错。
判断方法很简单:
| 现象 | 训练误差 | 测试误差 | 诊断 |
|---|---|---|---|
| 两个都高 | 高 | 高 | 欠拟合:换更强的模型、多训练 |
| 训练低、测试高 | 低 | 高 | 过拟合:加数据、简化模型、正则化 |
| 两个都低 | 低 | 低 | 理想 |
类比:过拟合的学生把练习册答案全背了,换一道题就不会;泛化好的学生理解了解题方法。
常见缓解手段(后面会反复遇到):更多数据;更简单的模型;正则化(惩罚太大的参数,让曲线别太扭);早停(验证误差开始上升就停);Dropout(训练时随机关掉一部分神经元)。
一个有趣的现代现象:大模型参数远多于传统意义上「安全」的数量,却仍然泛化很好。原因还在研究中,一般认为和海量数据、训练方法本身的隐式正则化有关。这里先记住经典结论即可。
06一个完整的机器学习流程
- 定义问题:输入是什么,输出是什么。
- 收集并标注数据。
- 划分训练 / 验证 / 测试集。
- 选模型(有哪些旋钮)。
- 定义「好坏」的度量(损失函数,下一节)。
- 训练:自动拧旋钮(梯度下降,下一节)。
- 在测试集上评估,看是否过拟合。
- 上线,持续监控(现实数据会变)。
- 1定义问题明确输入和输出
- 2准备数据收集、清洗和标注
- 3划分数据训练、验证、测试
- 4训练模型调整参数减少损失
- 5评估上线检查泛化并持续监控
回到第 1 步:数据或效果有问题就回到前面检查
上线后数据分布可能变化,需要持续观察。
07延伸阅读
08一分钟讲给别人
试着用自己的话讲一遍机器学习不是人写规则,而是给机器大量「题目 + 答案」,让它自己调好参数、得出规则(模型)。按有没有答案分为监督、无监督和强化学习。为了检验模型是真懂还是死记,要把数据分成训练集和测试集,只看测试集上的成绩。训练好、测试差就是过拟合,目标是泛化:在新数据上也表现好。
5 道自测
先在心里答一遍,再展开对照。能说清理由,比答对数字更重要。
01用一句话区分传统编程和机器学习。
02「根据过去的天气预测明天气温是几度」属于分类还是回归?
03「把新闻自动聚成若干话题,事先不知道有哪些话题」属于哪一类学习?
04某模型训练准确率 99%,测试准确率 60%,这是什么问题?给出两个改进办法。
05为什么不能用训练集的成绩来评价模型?
已看 0/5 题
练动手练习
找一段你熟悉的文本,先把其中 8 成内容当作“训练集”,让 AI 根据这些内容总结一条规律;再用剩下的 2 成内容检查它是否真的抓住了规律。记录它在两部分上的表现差异,想一想这和“背答案”有什么不同。
完成这一课
读完讲义、看完自测答案,这一课就算学完了。
- 读完讲义
- 看完全部自测
本课为投资者教育内容,案例数字均为示意,不构成任何投资建议,也不承诺收益。规则和费率会变,实际操作前请以交易所、监管机构和产品的最新公告为准。