01学完你能做到
理解「预测下一个词」为什么就能学到语言。
02计算机怎么表示一个词
神经网络只会算数字,所以第一步要把词变成数字。
方法一:one-hot
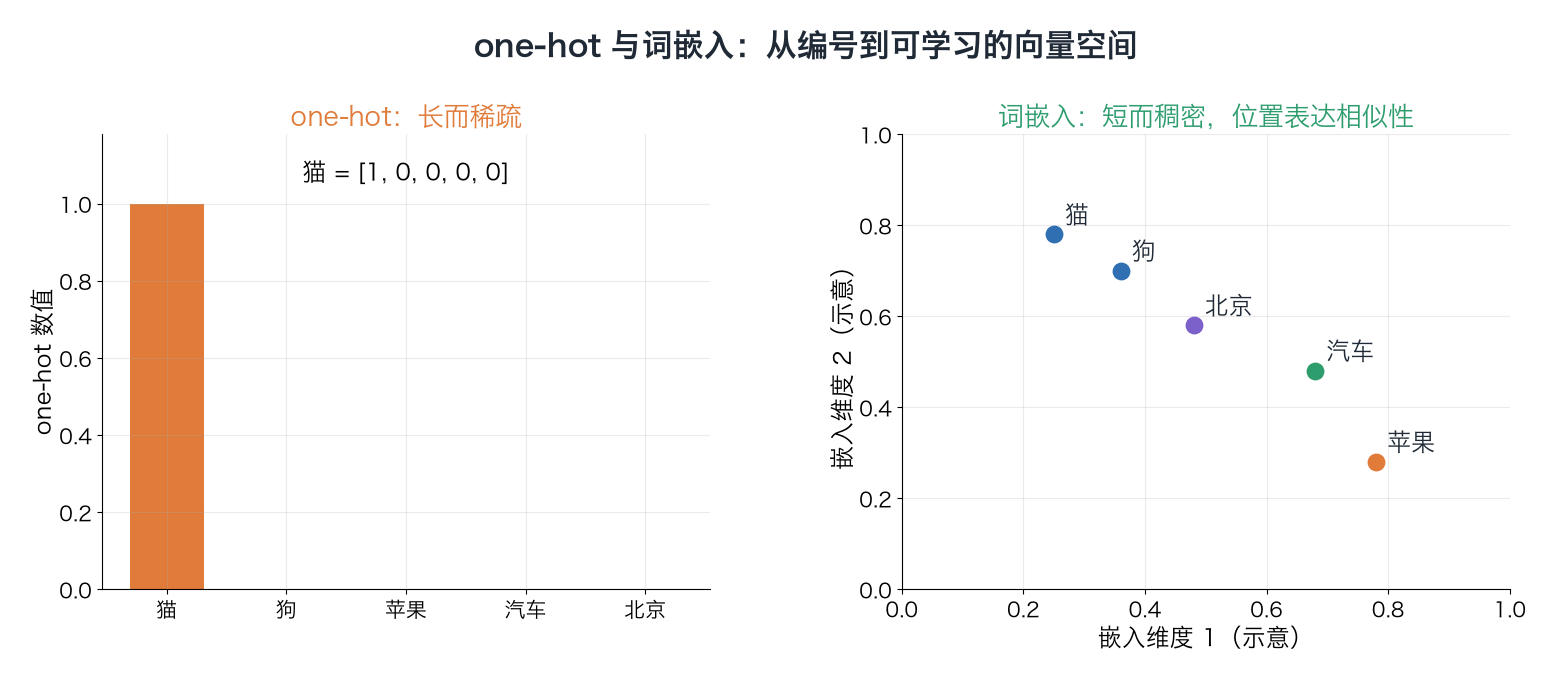
词表有 5 个词:猫、狗、苹果、香蕉、汽车。每个词用一个长度为 5 的向量,自己的位置是 1,其他是 0。
- 猫 = [1,0,0,0,0],狗 = [0,1,0,0,0]
问题:
- 太长:真实词表有几万到十几万个词,每个向量就那么长,几乎全是 0。
- 没有意思:任意两个词的「距离」都一样,「猫」和「狗」不比「猫」和「汽车」更像。
方法二:词嵌入(embedding)
给每个词一个短而稠密的向量,比如 300 维,每一维都是小数。这些数字不是人填的,而是训练学出来的。学完之后,意思相近的词向量也靠得近。
(右图是示意,真实嵌入有几百上千维,这里画成二维。)
著名的例子(word2vec,2013):向量「国王 − 男人 + 女人」最接近「女王」。说明「性别」这样的概念在空间里成了一个方向。
为什么能学出来? 语言学有个老说法:一个词的意思由它周围的词决定。「猫」和「狗」常出现在「喂了…」「…在叫」这类相同的上下文里,训练时它们会被推向相近的位置。
大模型的第一层就是一张嵌入表:每个 token(第 6 讲(分词:模型看到的是 token)讲)查出一个向量,再送进后面的网络。
03语言模型:给句子算概率
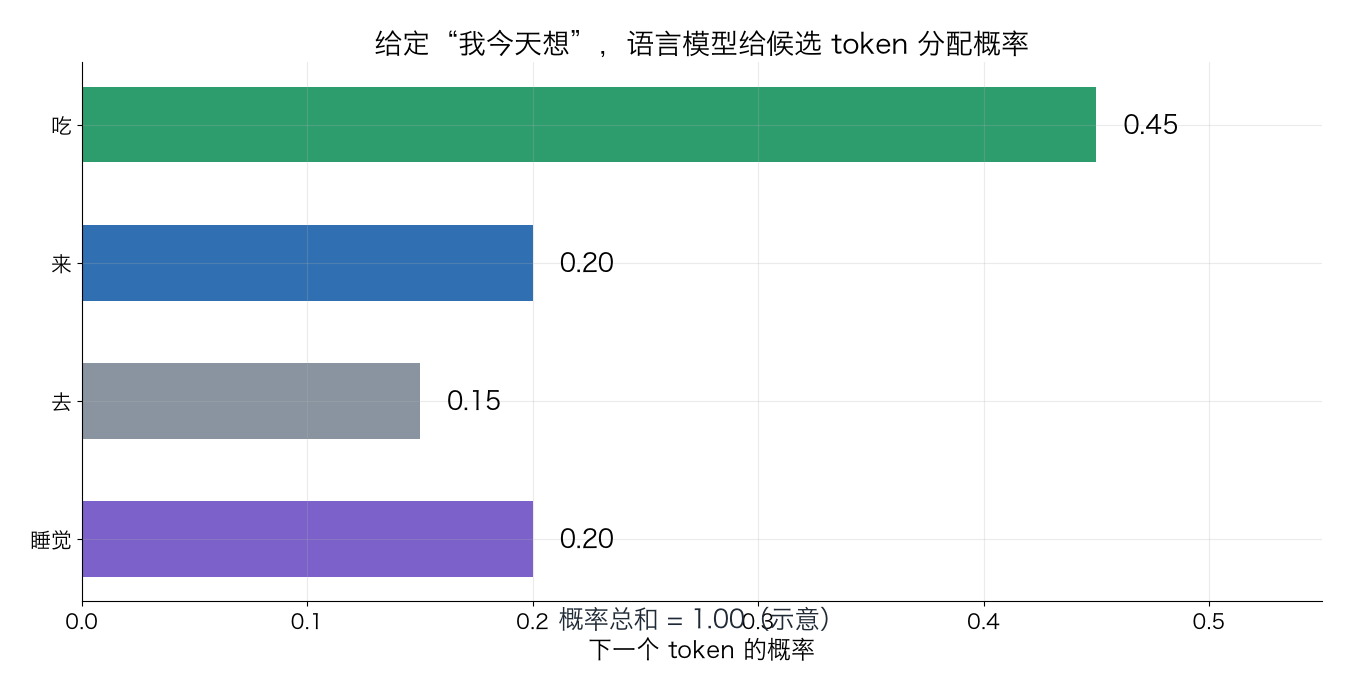
语言模型就是一个会回答「下一个词是什么,各有多大可能」的模型。
给定「我今天想」,模型输出一个覆盖整个词表的概率分布:「吃」0.45,「来」0.2……加起来等于 1。
n-gram:数数的老办法
二元模型(bigram)只看前一个词。用语料数数:
- 语料里「想」出现 1000 次,后面接「吃」450 次 → P(吃|想) = 450/1000 = 0.45。
一句话的概率 = 每一步条件概率相乘:P(我 爱 吃) = P(我) × P(爱|我) × P(吃|爱)。
n-gram 的缺陷:
- 只看前 n−1 个词,看不远。「我在法国长大……所以我说一口流利的___」,答案取决于很前面的「法国」。
- 数据稀疏:n 一大,很多组合语料里从没出现过,概率为 0。
- 不懂相似:见过「猫在吃」,但没见过「狗在吃」,它不会类推。
神经语言模型(Bengio 等,2003)用词嵌入 + 神经网络代替数数:相似的词有相似的向量,所以能举一反三。
04自回归:一次猜一个
生成文字时,模型一次只预测下一个 token,把它拼到输入后面,再预测下一个:
这就是 GPT 类模型的工作方式,叫自回归。你在聊天界面看到文字一个个「蹦」出来,就是这个原因。
训练时完全一样,只是答案已知:拿一句真实文本「我爱吃苹果」,在每个位置让模型猜下一个字,用交叉熵(第 2 讲(损失函数与梯度下降))惩罚它没给真实答案足够的概率。标签就藏在文本自己里,不需要人工标注,所以能用整个互联网的文本来训练。这叫自监督学习。
- 1读取已有 token形成当前上下文
- 2预测下一个得到概率分布
- 3选择 token按解码策略取一个
- 4接回输入进入下一轮生成
回到第 1 步:达到停止条件后结束
05为什么「猜下一个词」能学到这么多
要把下一个词猜得准,模型被迫学会很多东西:
- 「中国的首都是___」→ 需要事实知识;
- 「他们把杯子打碎了,所以___很生气」→ 需要常识和指代;
- 「3 + 5 = ___」→ 需要算术;
- 续写代码 → 需要语法和逻辑。
预测是压缩:越懂世界,越能准确猜下一个词。这就是为什么一个看起来朴素的目标,在足够大的模型和数据上,能长出各种能力(第 9 讲(预训练与规模定律)「规模定律」会展开)。
06困惑度:语言模型的考试分数
困惑度(perplexity,PPL)衡量模型对真实文本有多「意外」。直觉:模型平均在几个候选里犹豫。
数值例子:一句有 3 个词,模型给真实词的概率分别是 0.5、0.25、0.125。
- 三者相乘 = 0.015625;开 3 次方(几何平均)= 0.25;
- 困惑度 = 1 / 0.25 = 4:好像每一步都在 4 个等可能选项里瞎猜。
- 如果每步都给真实词概率 1,困惑度 = 1(完美)。
困惑度越低越好。它等于 e 的「平均交叉熵损失」次方,所以训练损失降低就是困惑度降低。
07延伸阅读
- Mikolov et al., Efficient Estimation of Word Representations in Vector Space, 2013(word2vec):arxiv.org
- Bengio et al., A Neural Probabilistic Language Model, JMLR 2003:jmlr.org
- 《动手学深度学习》8.3 节「语言模型和数据集」:zh.d2l.ai
- 《动手学深度学习》14.1 节「词嵌入(word2vec)」:zh.d2l.ai
- Karpathy, Neural Networks: Zero to Hero(makemore 系列):karpathy.ai
08一分钟讲给别人
试着用自己的话讲一遍计算机先要把词变成向量:one-hot 又长又不含意思,词嵌入是训练出来的短向量,相似的词靠得近。语言模型就是给出「下一个词」的概率分布;n-gram 靠数数,看不远也不会类推,神经语言模型解决了这些。GPT 这类模型自回归地一次猜一个词,训练标签来自文本本身。为了猜准下一个词,模型被迫学会知识、语法和推理;困惑度是衡量它猜得多准的分数。
5 道自测
先在心里答一遍,再展开对照。能说清理由,比答对数字更重要。
01one-hot 表示的两个主要缺点?
02语料中「北京」出现 200 次,其后紧跟「大学」50 次,二元模型下 P(大学|北京) 是多少?
03为什么语言模型预训练不需要人工标注?
04模型对 2 个词的真实答案都给了 0.1 的概率,困惑度是多少?
05「自回归」是什么意思?
已看 0/5 题
练动手练习
写下一个不完整句子,例如“今天下雨,所以我会带……”,让 AI 给出 5 个可能的下一个 token 或词,并要求它为每个选项给出概率排序。观察它需要利用哪些上下文信息,为什么只猜下一步也可能涉及事实或常识。
完成这一课
读完讲义、看完自测答案,这一课就算学完了。
- 读完讲义
- 看完全部自测
本课为投资者教育内容,案例数字均为示意,不构成任何投资建议,也不承诺收益。规则和费率会变,实际操作前请以交易所、监管机构和产品的最新公告为准。