01学完你能做到
明白为什么 RNN 被 Transformer 取代。
02序列需要「记忆」
一句话、一段语音、一串股价都是序列:顺序很重要。「狗咬人」和「人咬狗」用词一样,意思相反。上一节的 n-gram 只看固定窗口。我们想要一个能「边读边记」、理论上看得无限远的模型。
03RNN:带记忆的循环网络
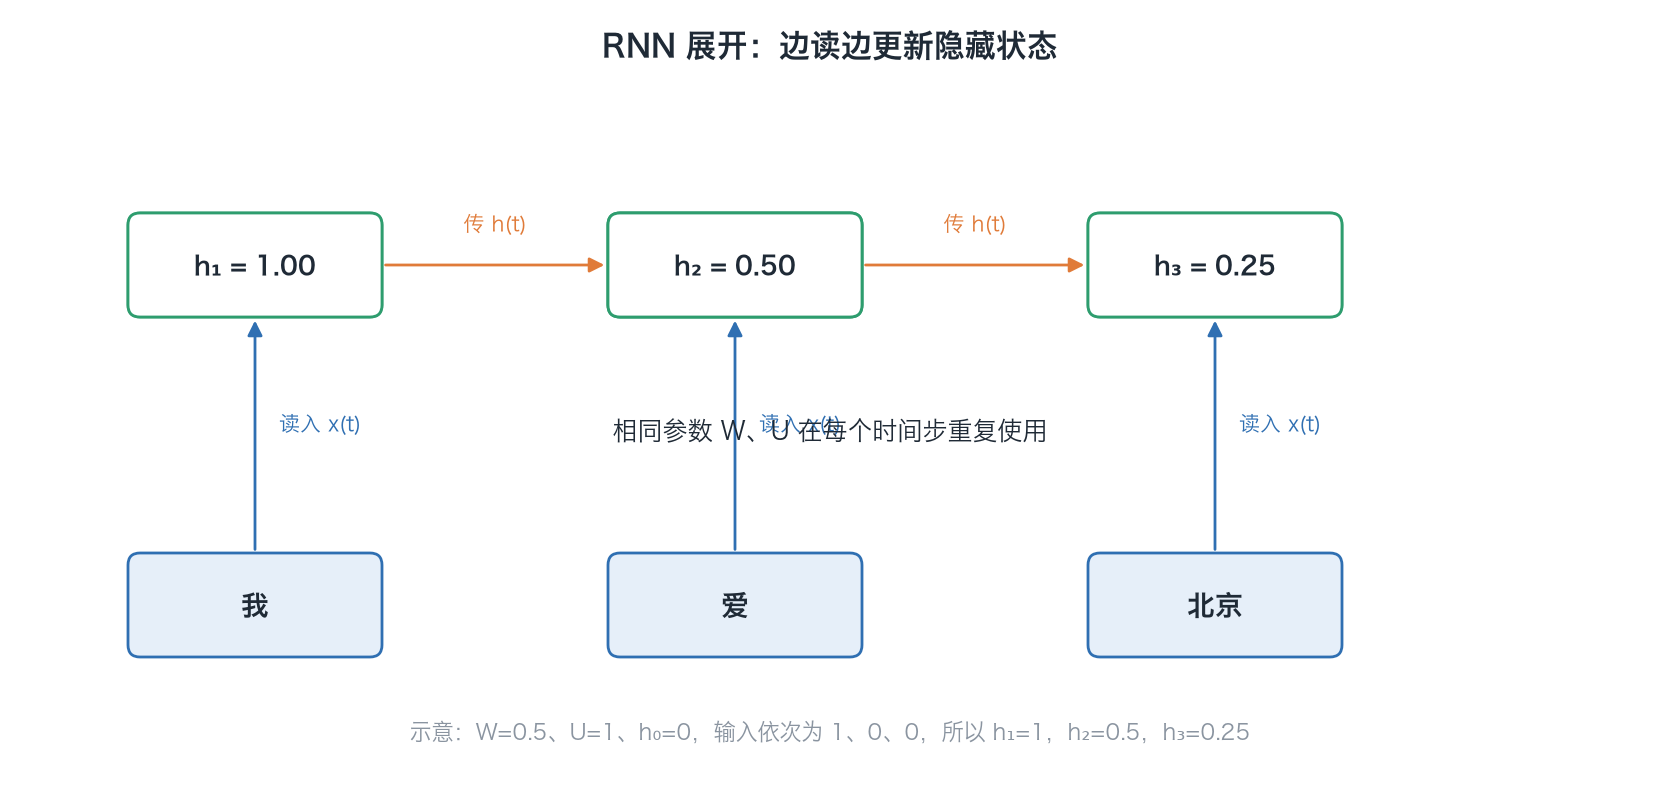
循环神经网络(RNN)每读一个词,就更新一个隐藏状态 h(可以理解为「到目前为止的笔记」):
h(t) = tanh( W·h(t−1) + U·x(t) )
新笔记 = 旧笔记和新词揉在一起。每一步用的都是同一套参数 W、U。
走读一遍
读「我爱北京」:
- 读「我」:h1 = 由「我」生成的笔记。
- 读「爱」:h2 = 揉合 h1 和「爱」,笔记里有了「我爱」。
- 读「北京」:h3 = 揉合 h2 和「北京」,笔记压缩了整句话。
- 用 h3 去做分类,或预测下一个词。
数值小例子(一维,为好算去掉 tanh):W=0.5,U=1,h0=0,输入依次是 1、0、0。
- h1 = 0.5×0 + 1 = 1
- h2 = 0.5×1 + 0 = 0.5
- h3 = 0.5×0.5 + 0 = 0.25
第一个词的信息每步打对折,读 10 步后只剩约 0.001。早期信息会被逐渐冲淡。
04瓶颈一:长距离依赖与梯度消失
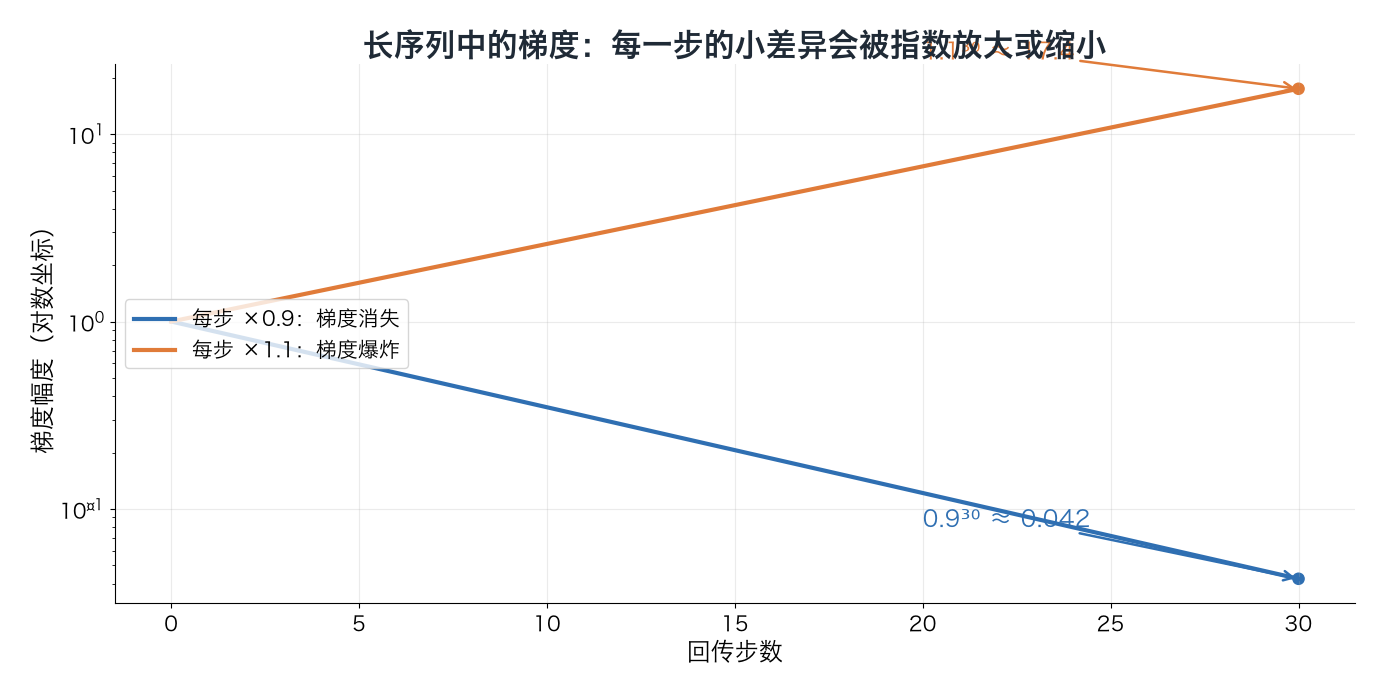
训练 RNN 时,误差要沿时间一步步往回传(「沿时间反向传播」)。每往回一步,梯度大约要乘一次类似 W 的系数。
- 每步乘 0.9,回传 30 步:0.9³⁰ ≈ 0.04,梯度几乎没了 → 梯度消失,模型学不会远处的关联。
- 每步乘 1.1:1.1³⁰ ≈ 17.4,越传越大 → 梯度爆炸,训练不稳定(常用「梯度裁剪」压住)。
所以对于「我在法国长大……(隔了 50 个词)……我说流利的___」,普通 RNN 很难把「法国」和答案联系起来。
05LSTM:加上「门」来管理记忆
LSTM(长短期记忆网络,1997)在 RNN 里加了一条细胞状态(像一条传送带)和三个「门」:
- 遗忘门:旧记忆里哪些该丢掉;
- 输入门:新信息里哪些该写进去;
- 输出门:此刻该把哪些记忆拿出来用。
门是 0\~1 之间的数(用 Sigmoid 算)。关键在于传送带上的记忆主要是加法更新,遗忘门接近 1 时信息几乎原样传下去,梯度也不容易消失。LSTM 能记住数百步,统治了 2014–2017 年的机器翻译和语音识别。GRU 是它的简化版。
06编码器-解码器(Seq2Seq)与「信息瓶颈」
机器翻译要把一个序列变成另一个序列。2014 年的方案:
- 编码器 RNN 读完整个中文句子,压成一个固定长度的向量;
- 解码器 RNN 从这个向量出发,一个词一个词生成英文。
问题:不管原句 5 个词还是 50 个词,都要塞进同一个大小的向量,长句信息必然丢失,翻译质量随句长明显下降。
2014 年 Bahdanau 等人提出注意力机制:解码器每生成一个词,都可以回头「看」编码器所有位置,按相关性加权取信息,而不是只靠最后那一个向量。这是通往 Transformer 的关键一步(第 7 讲(注意力机制))。
07瓶颈二:没法并行
RNN 必须先算 h1 才能算 h2,再算 h3……天生串行。
一句 1000 个词就要串行 1000 步,而 GPU 擅长的是同时做大量计算。这让 RNN 很难扩展到海量数据和大模型。
- RNN:串行计算先算 h1,再算 h2、h3
- Transformer:并行计算多个位置可同时处理
RNN 的隐藏状态依赖前一步;Transformer 的训练可并行处理多个位置。
08Transformer 的回答(2017)
论文《Attention Is All You Need》干脆扔掉循环,只用注意力:
- 每个词都能直接看到序列中任何其他词,距离 1 和距离 1000 一样近 → 解决长距离依赖;
- 训练时所有位置同时计算 → 充分利用 GPU 并行 → 能做大。
| RNN / LSTM | Transformer | |
|---|---|---|
| 远距离信息 | 要一步步传,会衰减 | 一步直达 |
| 训练并行 | 不行,必须串行 | 可以 |
| 代价 | 每步计算小 | 注意力计算量随长度平方增长 |
最后一行是 Transformer 的代价,也是今天「上下文窗口」长度有限、很贵的根源之一。另外,生成文本时 Transformer 仍然是一个词一个词地自回归输出,并行主要体现在训练和读入提示词时。
- 1读取序列保留前文信息
- 2遇到长依赖RNN 信息逐步衰减
- 3引入注意力直接查看相关位置
- 4并行训练充分利用 GPU
Transformer 用注意力解决了 RNN 的两类主要瓶颈,但长上下文的计算代价仍然存在。
09延伸阅读
- 《动手学深度学习》8.4 节「循环神经网络」:zh.d2l.ai
- 《动手学深度学习》9.2 节「长短期记忆网络(LSTM)」:zh.d2l.ai
- 《动手学深度学习》9.7 节「序列到序列学习」:zh.d2l.ai
- Hochreiter & Schmidhuber, Long Short-Term Memory, Neural Computation 9(8), 1997:doi.org
- Sutskever, Vinyals & Le, Sequence to Sequence Learning with Neural Networks, 2014:arxiv.org
- Cho et al., Learning Phrase Representations using RNN Encoder-Decoder for Statistical Machine Translation, 2014:arxiv.org
- Bahdanau, Cho & Bengio, Neural Machine Translation by Jointly Learning to Align and Translate, 2014:arxiv.org
- Vaswani et al., Attention Is All You Need, 2017:arxiv.org
10一分钟讲给别人
试着用自己的话讲一遍序列数据要求模型有记忆。RNN 用一个隐藏状态边读边更新,但早期信息会被冲淡,训练时梯度沿时间连乘会消失或爆炸。LSTM 用门和加法式的记忆传送带缓解了这个问题;编码器-解码器把整句压成一个向量,长句会丢信息,注意力机制由此诞生。RNN 还必须逐步串行计算,没法利用 GPU 并行。Transformer 用注意力取代循环,任意两个词一步直达,训练也能并行,所以取代了 RNN。
5 道自测
先在心里答一遍,再展开对照。能说清理由,比答对数字更重要。
01RNN 的隐藏状态起什么作用?
02回传 20 步、每步梯度乘 0.5,最终剩原来的多少?说明了什么?
03LSTM 的三个门分别是什么?
04Seq2Seq 的「信息瓶颈」指什么?哪个机制缓解了它?
05说出 Transformer 取代 RNN 的两个主要原因。
已看 0/5 题
练动手练习
在纸上从 h0=1 开始,连续 8 次乘以 0.5,再连续 8 次乘以 1.1,比较两组结果。把每次结果画成折线,观察信息如何消失或变大,这对应 RNN 训练中的哪两类问题。
完成这一课
读完讲义、看完自测答案,这一课就算学完了。
- 读完讲义
- 看完全部自测
本课为投资者教育内容,案例数字均为示意,不构成任何投资建议,也不承诺收益。规则和费率会变,实际操作前请以交易所、监管机构和产品的最新公告为准。