01学完你能做到
知道模型「看到」的不是字,而是 token。
02为什么要分词
第 4 讲(词向量与语言模型)说过,模型第一步要把文字变成数字。那么文字该按什么单位切?三种思路:
| 切法 | 例子「unbelievable」 | 优点 | 缺点 |
|---|---|---|---|
| 按字符 | u n b e l i e v a b l e(12 个) | 词表极小,不会遇到生词 | 序列太长,单个字母几乎没意义 |
| 按整词 | unbelievable(1 个) | 序列短 | 词表爆炸;没见过的词(新词、拼错)无法表示 |
| 按子词 | un / belie / vable(3 个) | 兼顾两者 | 切出来的块不一定符合人的直觉 |
今天的大模型几乎都用子词。高频词保持完整(the、你好),低频词拆成常见碎片(如上表的 un + belie + vable)。这样词表大小可控(几万到二十几万),又永远不会遇到「不认识的词」:实在不行就拆成单个字符甚至字节。
这些切出来的块就叫 token。模型的输入、输出、计费、上下文长度,统统以 token 为单位。
03BPE:从字母一步步「合并」出词表
BPE(Byte Pair Encoding,字节对编码)是最常用的子词算法,原理简单到可以手算:
- 起点:把所有词拆成单个字符,词表 = 所有字符。
- 统计语料里相邻两个符号一起出现的次数。
- 把出现最多的那一对合并成一个新符号,加入词表。
- 重复第 2–3 步,直到词表达到目标大小。
手算演示(经典玩具语料)
语料(_ 表示词尾,× 后是出现次数):low_ ×5、lower_ ×2、newest_ ×6、widest_ ×3
第 1 轮:数相邻对。「e s」出现在 newest(6 次)和 widest(3 次)中 → 共 9 次,最多。合并成 es。第 2 轮:「es t」也是 9 次 → 合并成 est。第 3 轮:「est _」9 次 → 合并成 est_(模型学会了「-est 结尾」这个后缀)。第 4 轮:「l o」出现在 low(5)和 lower(2)→ 7 次 → lo。第 5 轮:「lo w」7 次 → low。
5 轮后,语料变成:low _、low e r _、n e w est_、w i d est_。(以上结果展示了按合并顺序逐步得到的分词结果。)
分词新文本时,按学到的合并顺序依次套用。比如新词「lowest」:先拆成字符,再套规则 → low + est_,即使训练时从没见过 lowest 也能合理表示。
字节级 BPE:GPT 系列从 UTF-8 字节而非字符开始合并。一个汉字在 UTF-8 里占 3 个字节,所以任何语言、emoji、乱码都能被表示,绝不会出现「未知字符」。代价是:如果某个汉字没被合并成整体,它可能被拆成 2–3 个字节碎片。
- 1拆成字符或字节得到初始符号序列
- 2统计相邻符号对计算每一对出现次数
- 3合并最高频的一对生成更大的新符号
- 4重复直到词表达标保留常见片段
BPE 通过反复合并高频相邻片段,让常见内容更紧凑、陌生组合仍可表示。
04中文怎么切:实测
我在本机用 OpenAI 开源的 tiktoken 库实际切了几句话:
| 文本 | cl100k_base(GPT-4 时期,约 10 万词表) | o200k_base(GPT-4o 起,约 20 万词表) |
|---|---|---|
| Hello world | 2 个:Hello / world | 2 个 |
| unbelievable | 3 个:un / belie / vable | 3 个:un / bel / ievable |
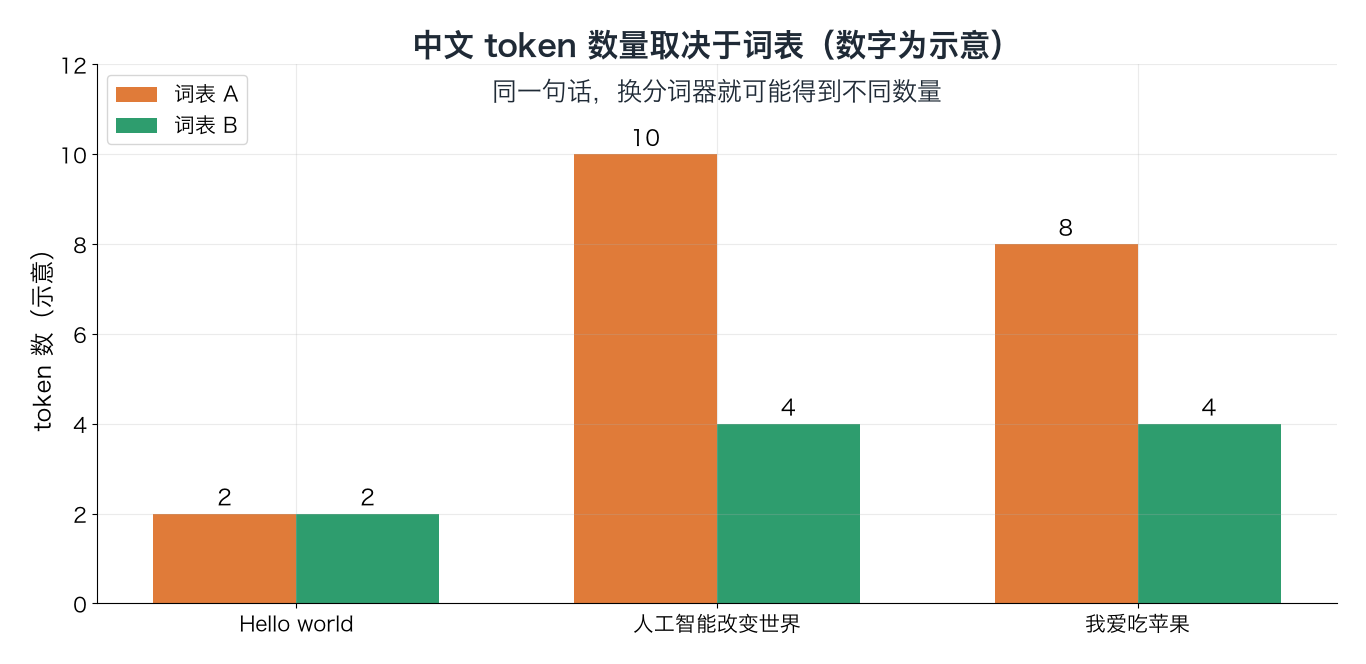
| 人工智能改变世界 | 10 个(「智」「世」被拆成字节碎片) | 4 个:人工 / 智能 / 改变 / 世界 |
| 我爱吃苹果 | 8 个 | 4 个:我 / 爱 / 吃 / 苹果 |
观察:
- 英文里一个常见单词通常是 1 个 token,注意空格常常和后面的词粘在一起(
world)。 - 中文的 token 效率高度依赖词表。老词表里中文数据少,常常一个字 1–3 个 token;新词表加入了大量中文词,变成两个字一个 token 左右。
- 国产模型(如 Qwen、DeepSeek)词表里中文占比更高,中文通常更省 token。具体比例因模型而异,要以各自的分词器实测为准。
05token 和你的钱、你的上下文
计费:API 按输入 token 数和输出 token 数分别收费(输出通常更贵)。数值例子:假设某模型输入每 100 万 token 收 2 元。一份 8 万字的中文文档:
- 若约 1 token/字 → 8 万 token → 0.16 元;
- 若约 2 token/字(老词表)→ 16 万 token → 0.32 元。
同一份文档,换个分词器费用差一倍。(价格是假设值,只演示算法。)
上下文长度:模型一次能「看」的 token 数上限,例如 128K。系统提示 + 历史对话 + 你上传的文件 + 模型的回答,全部都要算进去,超了就得截断或压缩(第 22 讲(什么是上下文工程)起的「上下文工程」专讲这个)。
分词带来的怪现象:
- 问「strawberry 里有几个 r」,模型常数错。因为它看到的是
strawberry这样的块,而不是一个个字母。 - 数字也会被切成奇怪的块,这是早期模型算术差的原因之一。
- 一个词前面有没有空格、大小写不同,可能是完全不同的 token。
- 输入 token占用上下文窗口并产生输入费用
- 输出 token占用上下文窗口并产生输出费用
- 上下文总量系统提示、历史和文件共同占用
token 数量同时影响上下文容量和 API 费用,具体价格以服务商最新文档为准。
06从 token 到向量
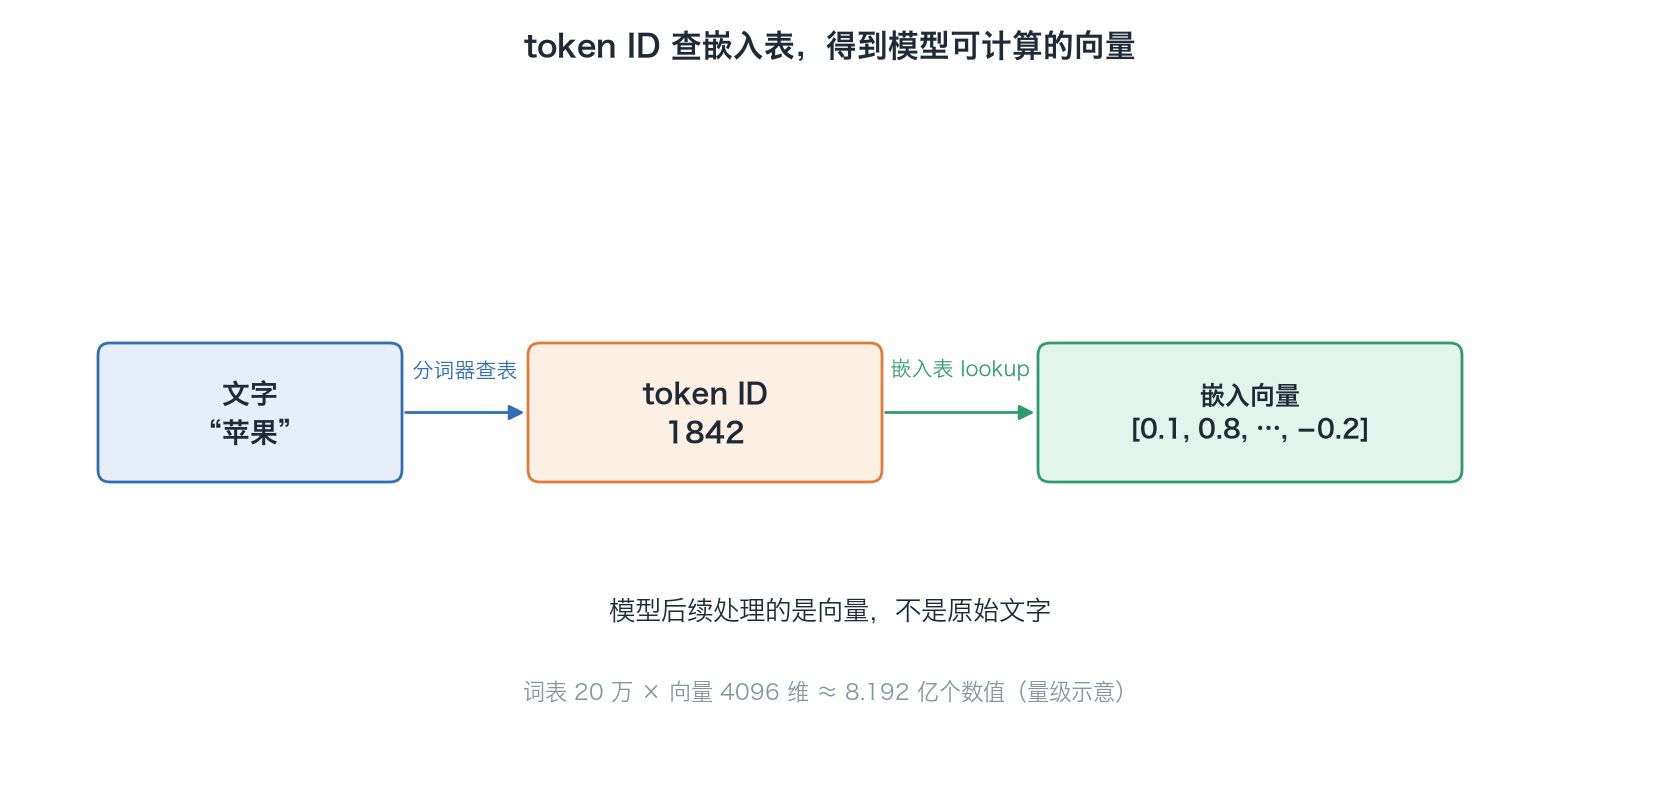
分词之后每个 token 有一个整数编号(ID),再去第 4 讲(词向量与语言模型)说的嵌入表里查出向量。词表 20 万、每个向量 4096 维,光嵌入表就有 20 万 × 4096 ≈ 8.2 亿个参数,所以词表也不能无限大。
07延伸阅读
- Sennrich, Haddow & Birch, Neural Machine Translation of Rare Words with Subword Units, 2015(BPE 用于 NLP 的原始论文,玩具语料即出自该文):arxiv.org
- Hugging Face LLM Course,BPE 分词章节:huggingface.co
- OpenAI tiktoken:github.com
08一分钟讲给别人
试着用自己的话讲一遍模型读的不是字也不是词,而是 token:介于字符和整词之间的子词块。BPE 从单个字符或字节出发,反复把最常一起出现的相邻对合并,直到词表够大,所以既能表示常见词,又永远不会遇到生词。中文切成多少 token 取决于词表,新词表大约两个字一个 token,老词表可能一个字两三个。计费和上下文长度都按 token 算,数字母、算数这类问题也会因为分词出错。
5 道自测
先在心里答一遍,再展开对照。能说清理由,比答对数字更重要。
01为什么不直接按整词分词?
02语料 `ab ×4`、`abc ×3`、`bc ×5`,BPE 第一轮会合并哪一对?
03字节级 BPE 有什么好处?
04上下文窗口 8K token,系统提示用了 1K,用户贴了 6.5K 的文档,模型最多还能输出多少 token?
05为什么模型数不清「strawberry」里有几个 r?
已看 0/5 题
练动手练习
任选一句中文和一句英文,分别复制到两个 AI 聊天工具中,请它们估算 token 数,或在纸上按“字符、整词、子词”三种方式拆分。比较不同语言和不同工具的结果,说明为什么同一份材料的上下文占用可能不同。
完成这一课
读完讲义、看完自测答案,这一课就算学完了。
- 读完讲义
- 看完全部自测
本课为投资者教育内容,案例数字均为示意,不构成任何投资建议,也不承诺收益。规则和费率会变,实际操作前请以交易所、监管机构和产品的最新公告为准。