01学完你能做到
理解「人类偏好」怎么变成训练信号。
02为什么 SFT 还不够
上节的 SFT 是「照着示范抄」。它有两个局限:
- 写示范很贵,而且人写的答案不一定是最好的。
- 很多好坏说不清标准:哪个回答更有帮助、更礼貌、更安全?写不出「标准答案」,但人一眼就能比较出哪个更好。
RLHF 的核心想法:让人做比较题,而不是写答案,再把这些比较变成模型能优化的分数。
03三步流程(InstructGPT)
第 1 步:SFT
先用示范数据微调出一个会听指令的模型(上一节)。
第 2 步:训练奖励模型(RM)
- 拿一个问题,让 SFT 模型生成几个不同回答(InstructGPT 每题 4–9 个)。
- 标注员把这些回答从好到坏排序。
- 训练一个奖励模型:输入「问题 + 回答」,输出一个分数。要求被人选中的回答得分更高。
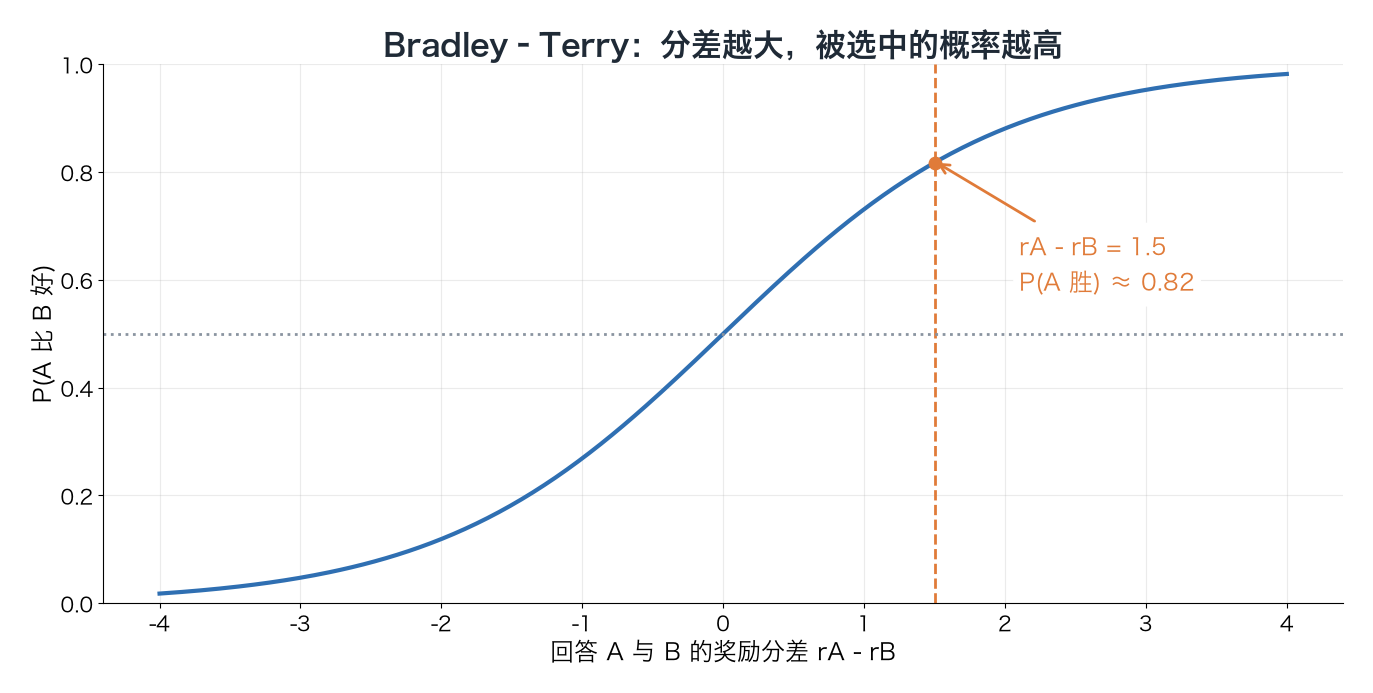
怎么从「排序」学出「分数」?Bradley-Terry 模型:P(A 比 B 好) = σ(r_A − r_B),其中 σ 是第 3 讲(神经网络与反向传播)的 Sigmoid,把分差变成 0–1 之间的概率。
数值演示:标注员认为回答 A 比 B 好。
- 若当前奖励模型给 r_A = 2,r_B = 0.5:分差 1.5,σ(1.5) ≈ 0.82,损失 = −log(0.82) ≈ 0.20。比较对了,损失小。
- 若打分是 r_A = 0.5,r_B = 2:分差 −1.5,σ(−1.5) ≈ 0.18,损失 ≈ 1.70。比较错了,损失大,梯度会推着 r_A 上升、r_B 下降。
注意:奖励模型只学「相对好坏」,分数的绝对值没有意义。
第 3 步:用强化学习优化模型
现在有了一个自动打分器,就可以让模型自己练:
- 抽一个问题,模型(这里叫「策略」)生成回答;
- 奖励模型打分;
- 用 PPO 算法更新模型:让得高分的回答更可能被生成,低分的更不可能。
- 重复。
PPO(近端策略优化)的直觉:每次更新步子不要太大,限制新旧策略的差别,避免一次更新把模型带崩。
- 1SFT 示范先学会听指令
- 2生成并排序同题回答由人比较
- 3训练奖励模型学习相对偏好
- 4PPO 优化提高高分回答概率
回到第 1 步:生成—打分—更新后继续迭代
RLHF 把人类比较转成奖励,再用强化学习优化策略。
04KL 约束:别为了分数「走火入魔」
奖励模型只是人类偏好的一个近似(代理),它有漏洞。如果模型被无限制地优化,就会学会钻打分器的空子,这叫奖励黑客(reward hacking):比如发现回答越长分越高,就开始写又长又空的废话;或发现讨好用户分高,就开始无原则附和。
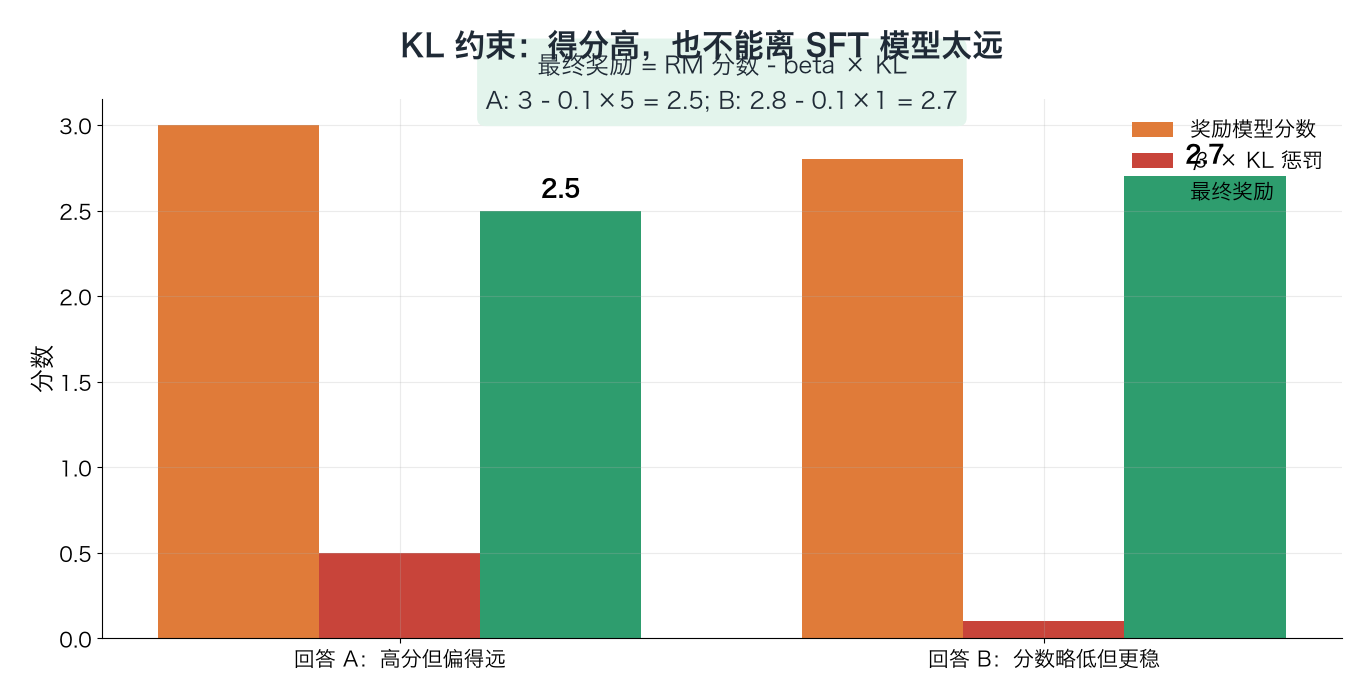
解决办法:在奖励里减去一项「偏离原模型的程度」(KL 散度):
最终奖励 = 奖励模型分数 − β × KL(新模型 ‖ SFT 模型)数值演示(β = 0.1):
- 回答 X:RM 分 3.0,KL = 5(和原模型说话方式差很多)→ 3.0 − 0.5 = 2.5
- 回答 Y:RM 分 2.8,KL = 1 → 2.8 − 0.1 = 2.7
虽然 X 原始分更高,但 Y 胜出:在不跑偏的前提下尽量变好。
05对齐税
对齐训练后,模型在某些传统学术评测上的表现可能下降,这叫对齐税(alignment tax)。InstructGPT 的缓解办法是在 PPO 训练中混入一部分预训练数据的梯度(论文叫 PPO-ptx),让模型别忘了原有能力。
InstructGPT 的效果(论文摘要):人类评估者更偏爱 13 亿参数 InstructGPT 的回答,胜过 1750 亿参数的 GPT-3;同时在真实性上有提升、有害输出减少。
06RLHF 的问题
- 贵且慢:要同时维护策略模型、参考模型、奖励模型、价值模型,PPO 调参困难。
- 标注员偏好不一致,且会有偏见(比如偏爱长回答、自信的语气)。
- 讨好(sycophancy):模型学会说用户想听的话。
- 下一节的 DPO、Constitutional AI 就是在解决这些问题。
07延伸阅读
- Ouyang et al., Training language models to follow instructions with human feedback(InstructGPT), 2022:arxiv.org
- Schulman et al., Proximal Policy Optimization Algorithms, 2017:arxiv.org
- Christiano et al., Deep reinforcement learning from human preferences, 2017(RLHF 早期工作):arxiv.org
- Stiennon et al., Learning to summarize from human feedback, 2020:arxiv.org
- Hugging Face 博客 Illustrating Reinforcement Learning from Human Feedback (RLHF):huggingface.co
08一分钟讲给别人
试着用自己的话讲一遍SFT 需要人写标准答案,而好坏往往写不出标准,但人很容易比较。RLHF 分三步:先 SFT;再让人对模型的多个回答排序,用 Bradley-Terry 方法训练一个奖励模型给回答打分;最后用 PPO 强化学习让模型生成高分回答。为了防止模型钻打分器的空子,奖励里要减去偏离原模型的 KL 惩罚。对齐可能让部分能力下降,这叫对齐税;InstructGPT 的 1.3B 模型比 175B 的 GPT-3 更受人欢迎。
5 道自测
先在心里答一遍,再展开对照。能说清理由,比答对数字更重要。
01为什么 RLHF 让人做「比较」而不是「写答案」?
02奖励模型对被选中回答 A 打 1 分、对 B 打 1 分,此时 P(A 比 B 好) 是多少?损失是多少?(ln 2 ≈ 0.693)
03什么是奖励黑客?举一个例子。
04β = 0.2,回答 RM 分 4、KL = 10,最终奖励是多少?
05什么是对齐税?
已看 0/5 题
练动手练习
在任意 AI 聊天工具里,提出一个没有唯一标准答案的问题,让它先给出两个回答。请你只按“有帮助、清楚、稳妥”三个标准给两个回答排序,再让 AI 解释它是否同意你的排序。最后比较:你的偏好怎样被改写成了可训练的反馈?
完成这一课
读完讲义、看完自测答案,这一课就算学完了。
- 读完讲义
- 看完全部自测
本课为投资者教育内容,案例数字均为示意,不构成任何投资建议,也不承诺收益。规则和费率会变,实际操作前请以交易所、监管机构和产品的最新公告为准。