01学完你能做到
理解 Q、K、V,以及「每个词去看其他词」是什么意思。
02问题:一个词的意思取决于别的词
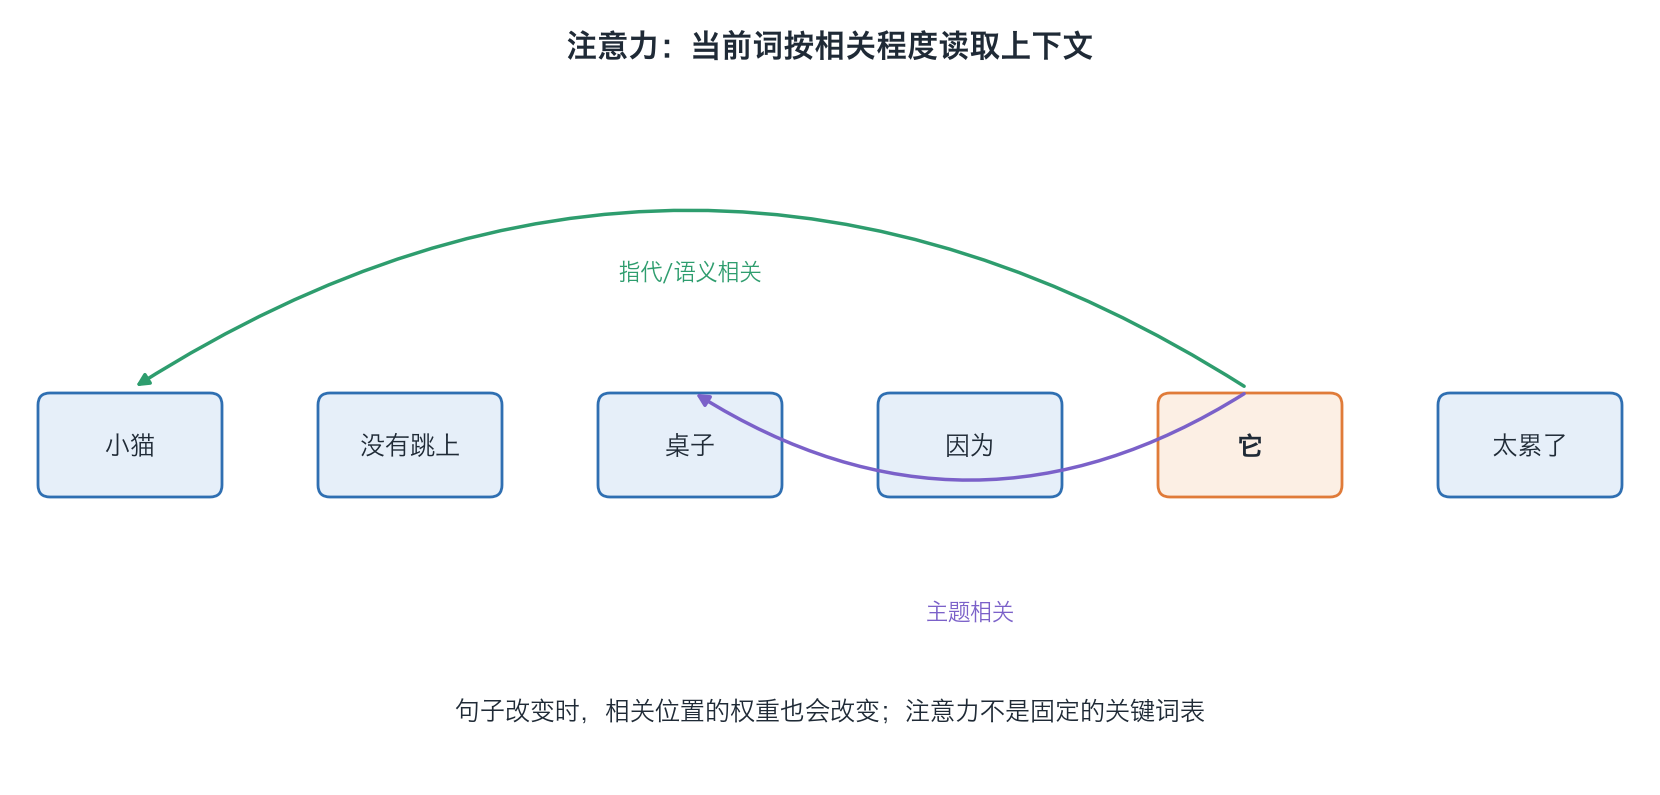
「小猫没有跳上桌子,因为它太累了。」
「小猫没有跳上桌子,因为它太高了。」
两句里的「它」分别指小猫和桌子。要理解「它」,模型必须回头看句子里的其他词,并判断哪个最相关。注意力机制就是干这个的:每个词根据相关程度,从其他词那里「收集」信息,更新自己的表示。
03Q、K、V:图书馆检索的比喻
每个词的向量会被乘上三个不同的矩阵(都是训练学出来的),变成三个新向量:
- Q(Query,查询):我在找什么?(「它」:我在找一个能累的东西)
- K(Key,键):我能提供什么标签?(「小猫」:我是动物、有生命)
- V(Value,值):如果你选中我,我真正交给你的内容。
类比图书馆:你带着问题(Q)去比对每本书的书脊标签(K),越匹配的书你读得越多,最后把各本书的内容(V)按匹配程度混合,就是你的收获。
04缩放点积注意力:四步走
公式:Attention(Q, K, V) = softmax( Q·Kᵀ / √d ) · V
- 打分:用 Q 和每个 K 做点积(对应位置相乘再相加)。方向越一致,分数越高。
- 缩放:除以 √d(d 是向量维度)。维度大时点积数值会很大,softmax 会变得极端(几乎全给一个词),梯度变小、难训练。缩放让分数保持温和。
- softmax:把分数变成加起来等于 1 的权重。softmax(x) = eˣ / 所有 eˣ 之和。
- 加权求和:用权重把所有 V 混合,得到这个词的新向量。
手算演示:3 个词,2 维
为了好算,设 Q = K(真实模型里它们不同):
- 词A:q = k = [1, 0],v = [1, 0]
- 词B:q = k = [0, 1],v = [0, 1]
- 词C:q = k = [1, 1],v = [0.5, 0.5]
第 1 步 打分(以词A为例):
- A·A = 1×1 + 0×0 = 1
- A·B = 1×0 + 0×1 = 0
- A·C = 1×1 + 0×1 = 1
第 2 步 缩放:d = 2,√2 ≈ 1.414 → [0.707, 0, 0.707]
第 3 步 softmax:e\^0.707 ≈ 2.03,e\^0 = 1
- 和 = 2.03 + 1 + 2.03 = 5.06
- 权重 ≈ [0.40, 0.20, 0.40]
第 4 步 加权求和:0.40×[1,0] + 0.20×[0,1] + 0.40×[0.5,0.5] = [0.60, 0.40]
词A的新表示从 [1,0] 变成了 [0.60, 0.40]:它「吸收」了一些来自 C 的信息。对 B、C 做同样计算,就得到下面左边的权重矩阵:
要点:所有词的计算互不依赖,可以写成一次矩阵乘法同时算完,这就是第 5 讲(序列模型和它的瓶颈)说的「可以并行」。
- 1计算点积得分Q 与每个 K 做匹配
- 2除以 sqrt(d)避免点积过大
- 3softmax 转权重权重总和为 1
- 4对 V 加权求和混合相关信息
多头注意力会并行重复这套过程,再把各头结果合并。
05因果掩码:不许偷看未来
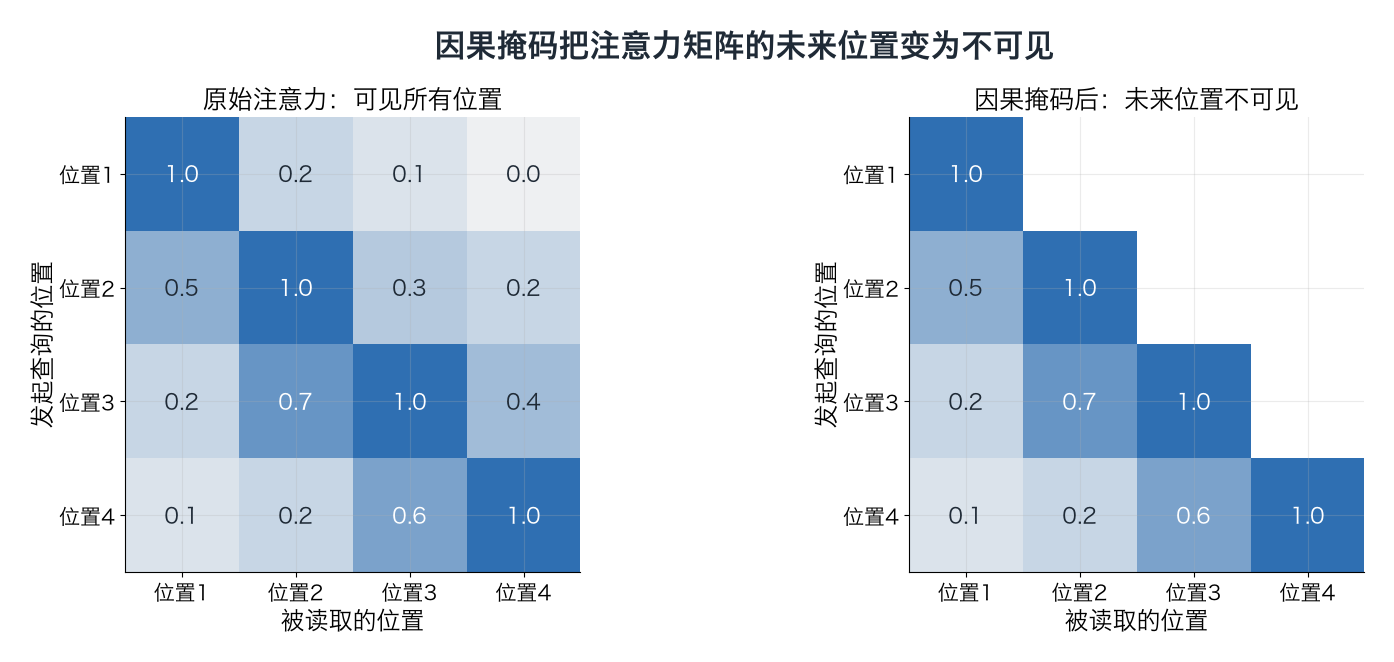
GPT 这类模型的任务是预测下一个词。训练时整句话都在输入里,如果「词B」能看到「词C」,就等于偷看了答案。解决:在 softmax 之前把「未来位置」的分数设成负无穷,e\^(−∞) = 0,权重就变成 0。
手算词B的掩码版:原始分数 [0, 0.707, 0.707] → 遮掉 C → [0, 0.707, −∞]softmax:e\^0 = 1,e\^0.707 ≈ 2.03,和 = 3.03 → 权重 [0.33, 0.67, 0]。见上图右边:权重矩阵变成下三角,每个词只看自己和左边。
06多头注意力:同时看多种关系
一个词和别人的关系有很多种:语法上谁是主语,指代上「它」是谁,语义上谁和谁同类……多头注意力把向量切成 h 份(比如 32 个头),每个头有自己的 Q、K、V 矩阵,独立做一遍注意力,最后把结果拼起来再混合一次。研究者确实观察到不同的头会专注于不同模式(有的看前一个词,有的看匹配的括号),但也有很多头的作用并不好解释。
- 1拆成多个头每个头使用独立 QKV 投影
- 2分别计算注意力捕捉不同关系模式
- 3拼接各头结果合并多个表示
- 4再次混合输出得到新的位置表示
不同头可能关注语法、指代或语义关系,但并不是每个头都容易解释。
07代价:平方复杂度
n 个词,每个词都要和所有词打分 → n × n 个分数。
- 1000 个 token → 100 万个分数;
- 10 万个 token → 100 亿个分数,增加了 1 万倍。
这就是长上下文昂贵的根本原因之一。为此有 FlashAttention(算法不变,优化显存读写)、稀疏注意力、KV 缓存(生成时把已算过的 K、V 存起来,不重复计算)等工程手段。
08延伸阅读
- Vaswani et al., Attention Is All You Need, 2017:arxiv.org
- Bahdanau, Cho & Bengio, Neural Machine Translation by Jointly Learning to Align and Translate, 2014(最早的注意力机制):arxiv.org
- Jay Alammar, The Illustrated Transformer:jalammar.github.io
09一分钟讲给别人
试着用自己的话讲一遍注意力让每个词根据相关程度,从其他所有词那里收集信息。每个词产生查询 Q、键 K、值 V:用 Q 和所有 K 点积打分,除以根号 d 缩放,softmax 变成权重,再对 V 加权求和。GPT 用因果掩码遮住未来,每个词只能看左边。多头注意力并行做很多份,各自捕捉不同关系。所有位置可以一次矩阵运算算完,所以能并行,但计算量随长度平方增长。
5 道自测
先在心里答一遍,再展开对照。能说清理由,比答对数字更重要。
01Q、K、V 各自的作用?
02为什么要除以 √d?
03两个分数 [0, 0],softmax 后权重是多少?若是 [2, 0] 呢?(e² ≈ 7.39)
04因果掩码是怎么实现「看不到未来」的?
05上下文从 2K 增加到 8K,注意力分数的数量变为原来几倍?
已看 0/5 题
练动手练习
拿一句包含指代的句子,例如“因为它太累了,所以小猫没有跳”,圈出你认为最关键的关联词。再让 AI 分别解释“它”可能指谁,并要求它列出支持判断的词;比较它是否真的利用了上下文,而不是只猜一个答案。
完成这一课
读完讲义、看完自测答案,这一课就算学完了。
- 读完讲义
- 看完全部自测
本课为投资者教育内容,案例数字均为示意,不构成任何投资建议,也不承诺收益。规则和费率会变,实际操作前请以交易所、监管机构和产品的最新公告为准。