01学完你能做到
能画出一个 Transformer 块,知道每个部件为什么在那里。
上节讲了注意力这个核心零件。这节把零件组装成整台机器。
02全局鸟瞰(以 GPT 类解码器为例)
- 文本 → token → 查嵌入表得到向量(第 6 讲(分词:模型看到的是 token));
- 加入位置信息;
- 穿过 N 个完全相同结构的 Transformer 块(参数各不相同);
- 最后一层输出 → 映射回词表大小 → softmax → 下一个 token 的概率(第 4 讲(词向量与语言模型))。
- 1切成 token得到 token ID
- 2查嵌入和位置形成初始表示
- 3通过 Transformer 块注意力与 FFN 反复加工
- 4映射到词表得到下一个 token 概率
回到第 1 步:继续生成直到停止
03一个块里有什么
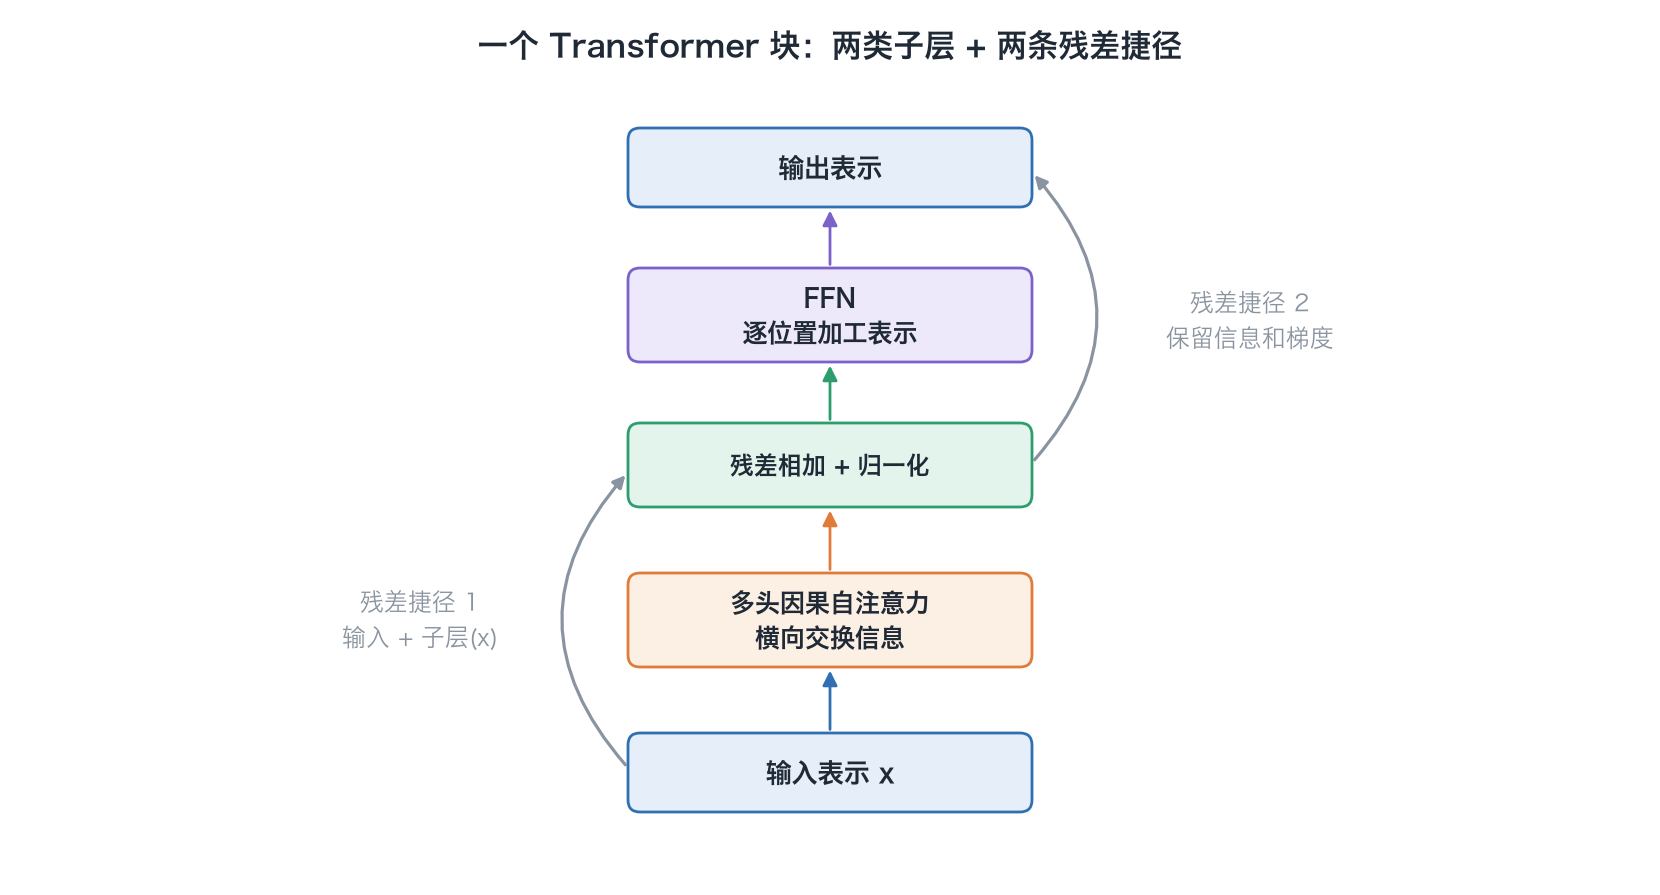
每个块由两个子层组成,每个子层都配有「层归一化 + 残差连接」:
- 子层 1:多头因果自注意力:让各位置之间交换信息(「横向」看别的词)。
- 子层 2:前馈网络(FFN):每个位置独立地过一个两层的 MLP(「纵向」加工自己)。常见说法是:注意力负责「搬运信息」,FFN 负责「存储和加工知识」,很多事实知识被认为存在 FFN 里。
残差连接:给信息修一条捷径
输出 = 输入 + 子层(输入)。子层只需要学习「在原来基础上改多少」。为什么重要:第 5 讲(序列模型和它的瓶颈)讲过梯度连乘会消失。有了「+ 输入」这条捷径,梯度可以直接沿着加号原样传回前面的层,几十上百层也训练得动。这个想法来自图像领域的 ResNet(2015)。数值演示:输入 x = [1.0, 2.0],注意力子层算出的修改量是 [0.1, −0.3],输出 = [1.1, 1.7]。即使子层还什么都没学会(输出接近 0),信息也能完整传下去。
层归一化:把数值拉回正常范围
数据一层层加工,数值可能越来越大或越来越偏,训练就不稳定。层归一化把每个位置的向量调成均值 0、方差 1,再乘以可学习的缩放、加上可学习的偏移。数值演示:x = [2, 4, 6]
- 均值 = 4;
- 方差 = ((−2)² + 0² + 2²) / 3 = 8/3,标准差 ≈ 1.633;
- 归一化 = [−2, 0, 2] / 1.633 ≈ [−1.22, 0, 1.22]。
原论文把归一化放在残差相加之后(Post-LN);现在大多数模型放在子层之前(Pre-LN,如上图),训练更稳。很多新模型还用更省计算的变体 RMSNorm。
前馈网络
对每个 token 向量:先放大到约 4 倍维度 → 激活函数 → 再缩回原维度。现代模型常把 ReLU 换成 GELU 或 SwiGLU 等门控变体。
04位置编码:告诉模型词的顺序
在不注入位置信息时,自注意力无法区分词的绝对顺序:输入排列后,输出也会按同样方式排列,却不能判断哪个词在前、哪个词在后。因此必须额外注入位置信息。
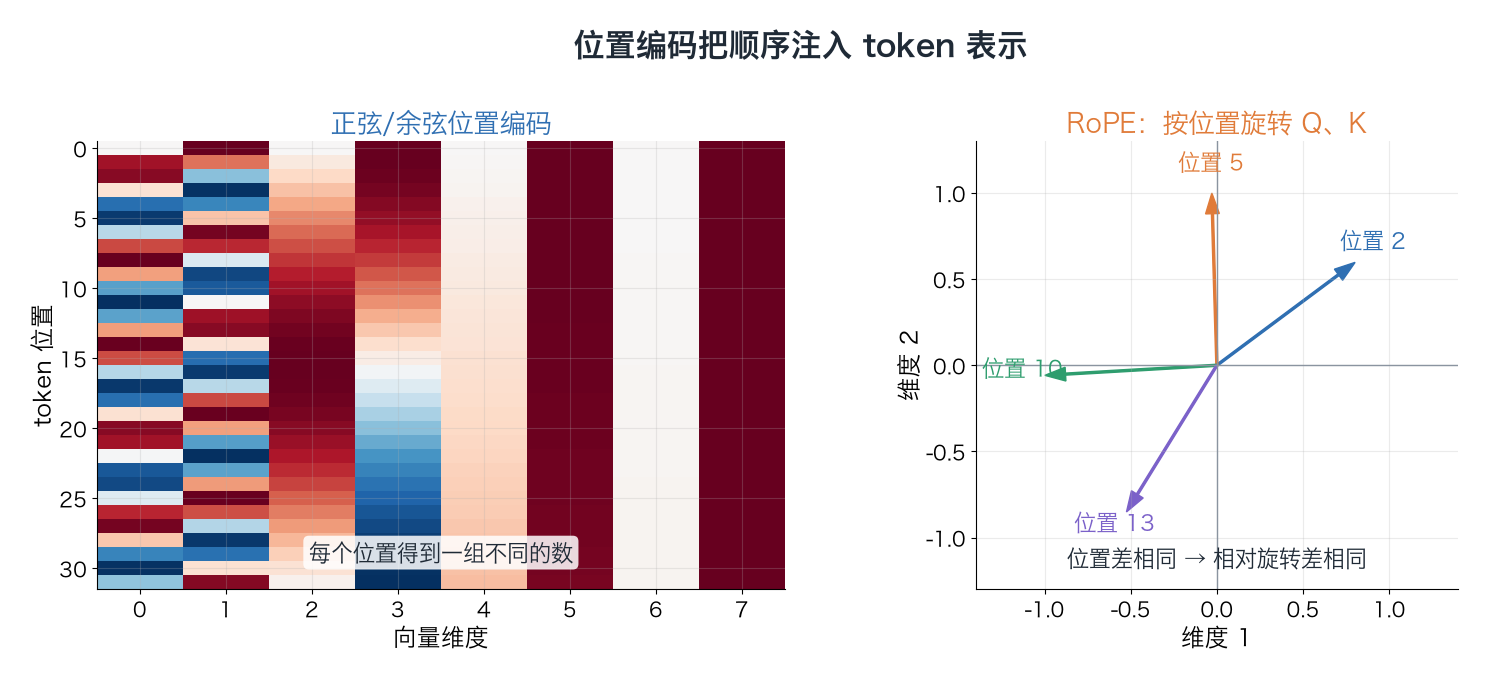
方法一:正弦位置编码(原始 Transformer)给每个位置算一个由不同频率正弦、余弦组成的向量,加到词向量上。左图每一列是一个位置的「条形码」:上面的维度变化快(像秒针),下面的变化慢(像时针),组合起来每个位置独一无二。另一种做法是直接让模型学每个位置的向量(GPT-2、BERT 用的是这种),但训练时没见过的更长位置就无法处理。
方法二:旋转位置编码 RoPE(今天的主流,LLaMA、Qwen 等都在用)不再把位置「加」上去,而是把 Q 和 K 向量按位置旋转一个角度:位置 m 旋转 m×θ。数值演示(只看一对维度,θ = 30°):
- 词在位置 2:转 60°;另一个词在位置 5:转 150°。夹角差 90°。
- 整体平移到位置 10 和 13:转 300° 和 390°,夹角差仍是 90°。
两个向量的点积只取决于夹角,所以注意力分数只和两词的相对距离有关,和绝对位置无关。这很符合语言直觉(「形容词紧挨名词」与它出现在第几个字无关),而且便于通过调整频率来扩展上下文长度。
05参数都在哪:粗算一个 7B 模型
设隐藏维度 d = 4096,32 层:
- 注意力:Q、K、V、输出 4 个 d×d 矩阵 → 4d² ≈ 6700 万
- FFN:d→4d→d 两个矩阵 → 8d² ≈ 1.34 亿
- 每块约 12d² ≈ 2 亿;32 块 ≈ 64 亿
- 再加上嵌入表等,总量约 70 亿,这就是「7B」的大致来源。
(真实模型会因 SwiGLU、分组查询注意力等设计有出入,这里只演示量级。)
06编码器型 vs 解码器型
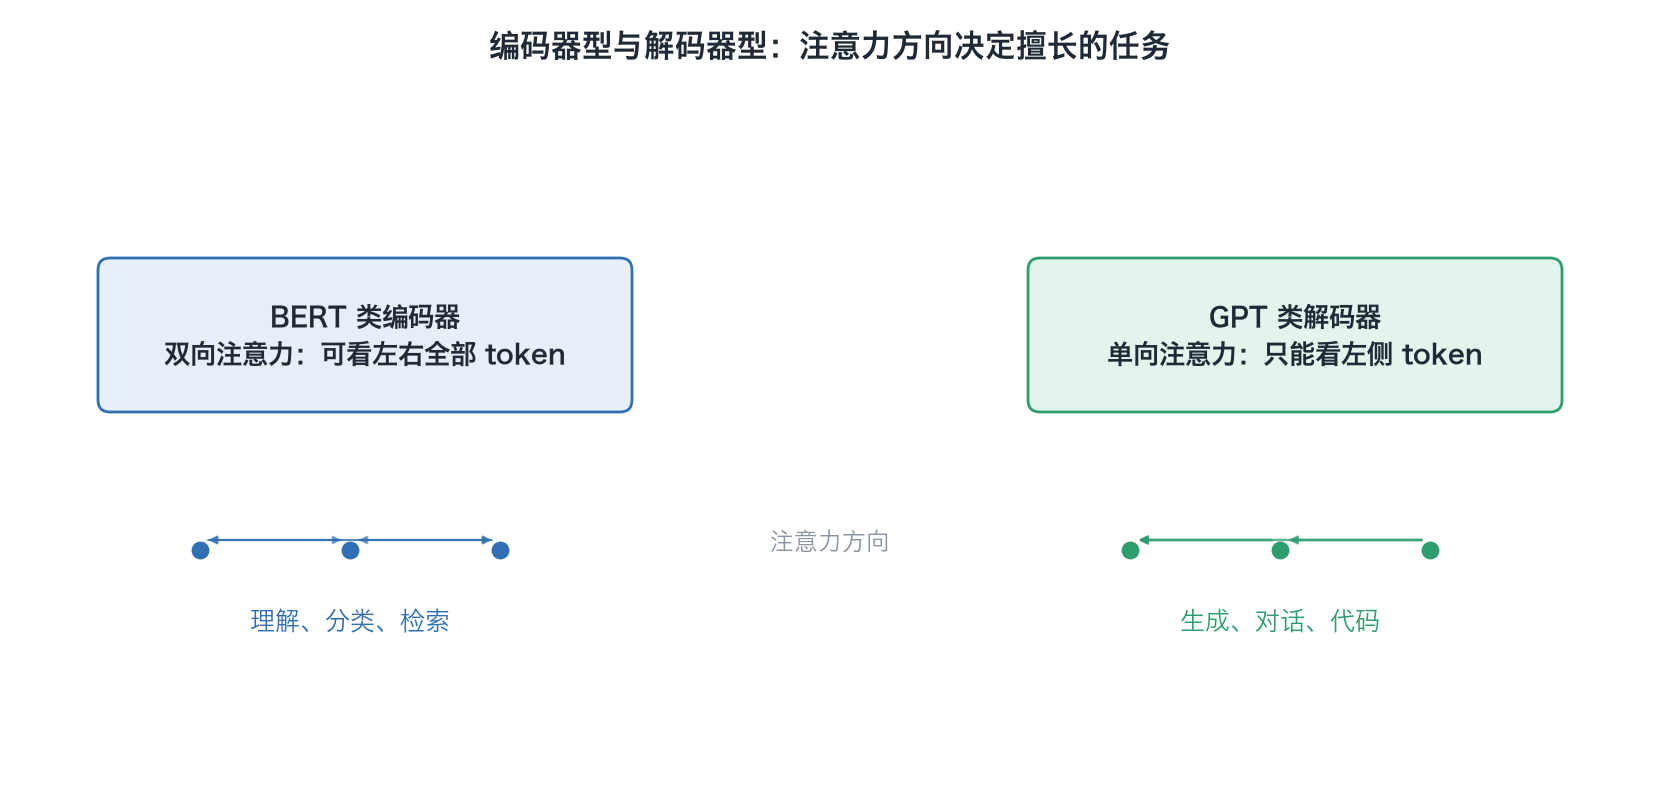
原始 Transformer(2017)用于翻译,有两部分:编码器读输入文本、解码器写译文,解码器还会通过「交叉注意力」查看编码器的输出。后来分化出两条路:
| BERT(只用编码器) | GPT(只用解码器) | |
|---|---|---|
| 注意力 | 双向:每个词看全句 | 单向:只看左边(因果掩码) |
| 预训练任务 | 完形填空(遮住 15% 的词让它猜) | 预测下一个词 |
| 擅长 | 理解:分类、检索、相似度 | 生成:写作、对话、代码 |
| 今天的地位 | 仍用于搜索、嵌入模型等 | 主流大模型(GPT、Claude、Qwen、DeepSeek、LLaMA…) |
为什么生成式最后胜出?「预测下一个词」可以直接用来生成任何东西,形式统一,随规模扩大效果持续提升(下一节)。T5 这类编码器-解码器模型仍然存在,但不再是主流。
07延伸阅读
- Vaswani et al., Attention Is All You Need, 2017:arxiv.org
- Su et al., RoFormer: Enhanced Transformer with Rotary Position Embedding, 2021:arxiv.org
- Devlin et al., BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding, 2018:arxiv.org
- He et al., Deep Residual Learning for Image Recognition, 2015(残差连接):arxiv.org
- Ba, Kiros & Hinton, Layer Normalization, 2016:arxiv.org
- Shazeer, GLU Variants Improve Transformer, 2020(SwiGLU):arxiv.org
- Datawhale《happy-llm》(中文开源教程):github.com
- Jay Alammar, The Illustrated Transformer:jalammar.github.io
08一分钟讲给别人
试着用自己的话讲一遍GPT 类模型是把同样结构的 Transformer 块叠很多层。每块有两个子层:多头因果自注意力负责在词之间搬运信息,前馈网络负责加工每个词;每个子层都配有层归一化稳定数值,用残差连接修一条捷径让深层可训练。注意力本身不懂顺序,所以要加位置编码,现在主流的 RoPE 通过旋转让分数只取决于相对距离。BERT 是双向的编码器,擅长理解;GPT 是单向的解码器,擅长生成,是今天大模型的主流。
5 道自测
先在心里答一遍,再展开对照。能说清理由,比答对数字更重要。
01残差连接解决了什么问题?
02对 [1, 3] 做层归一化(不考虑缩放和偏移),结果是多少?
03为什么 Transformer 需要位置编码?
04RoPE 下,位置 (3, 7) 和位置 (100, 104) 两对词的旋转夹角差相同吗?为什么?
05想做「判断两段文本是否同义」的检索系统和「写营销文案」的应用,各自更接近哪类结构?
已看 0/5 题
练动手练习
在纸上画一个 Transformer 块,依次标出注意力、残差连接、层归一化和 FFN。然后把同一句话的两个词交换位置,写下如果没有位置编码,模型为什么无法仅凭词向量判断它们的先后。
完成这一课
读完讲义、看完自测答案,这一课就算学完了。
- 读完讲义
- 看完全部自测
本课为投资者教育内容,案例数字均为示意,不构成任何投资建议,也不承诺收益。规则和费率会变,实际操作前请以交易所、监管机构和产品的最新公告为准。