01学完你能做到
知道不训练奖励模型也能做对齐,也知道可以用 AI 代替人来提供反馈。
上节的 RLHF 有两大痛点:流程复杂(奖励模型 + PPO),以及人类标注昂贵。这节两种方法各解决一个。
02DPO:直接偏好优化
核心洞察
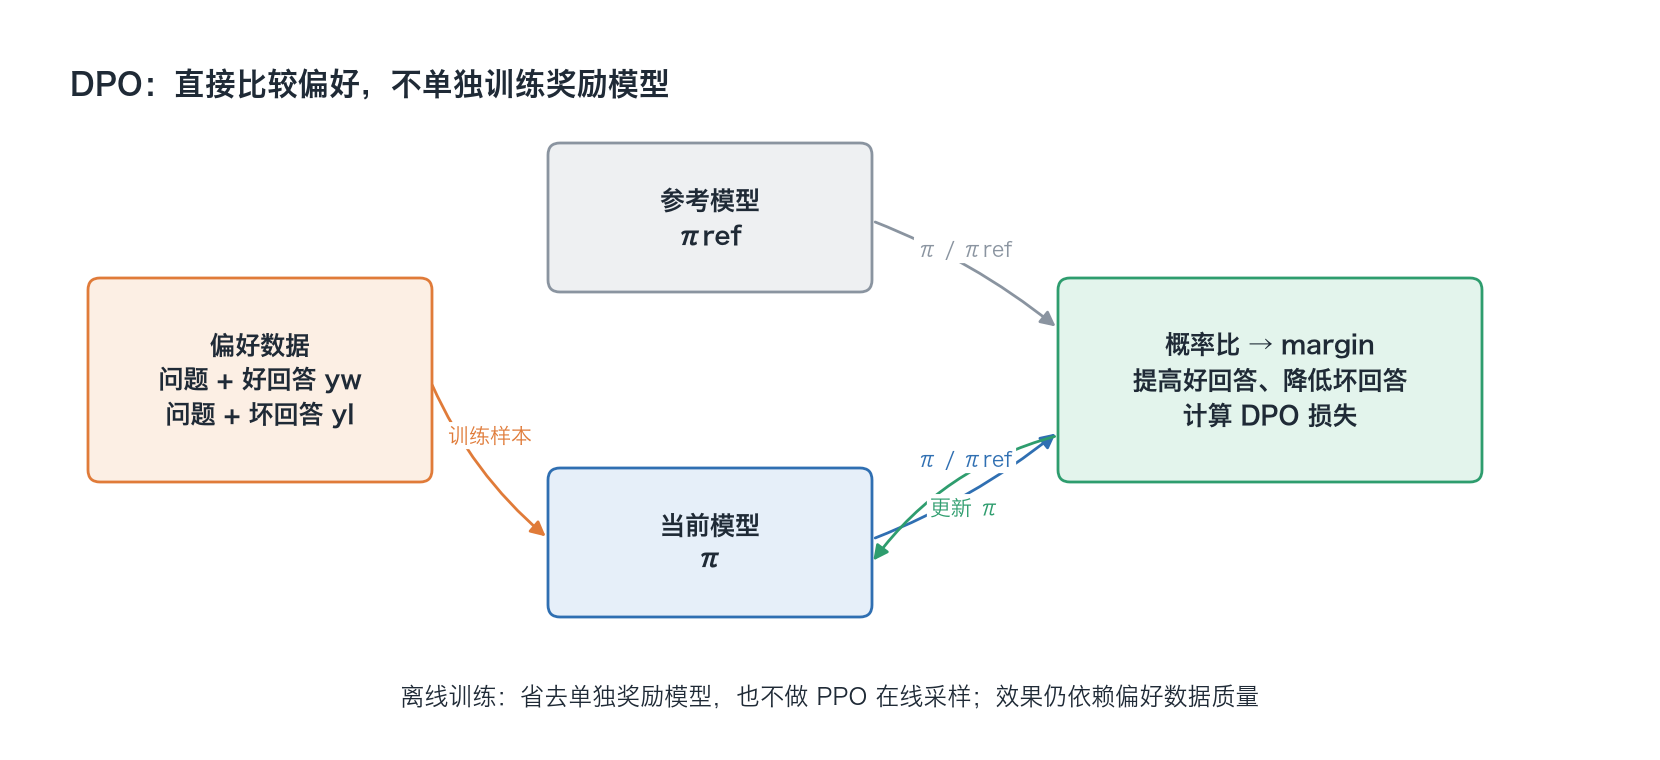
DPO 论文的副标题是「你的语言模型其实暗中就是一个奖励模型」。作者用数学证明:带 KL 约束的 RLHF 目标,其最优解可以写成一个封闭形式,奖励可以用「新模型相对参考模型的概率比」来表示。于是不需要单独训练奖励模型,也不需要强化学习采样,直接在偏好数据上做一个类似分类的训练即可。
直觉
每条数据是(问题,好回答 y_w,坏回答 y_l)。DPO 要做的是:
- 相对于参考模型(SFT 模型),提高好回答的概率;
- 相对于参考模型,降低坏回答的概率;
- 「相对于参考模型」这一点起到了 KL 约束的作用,防止跑偏。
损失:L = −log σ( β × [ log(π(y_w)/π_ref(y_w)) − log(π(y_l)/π_ref(y_l)) ] )
看着吓人,拆开就是:
- log(π/π_ref):新模型比参考模型更喜欢这个回答多少(正数 = 更喜欢);
- 方括号:好回答的「提升」减去坏回答的「提升」;
- 乘 β 后叫 margin,和上节 Bradley-Terry 一模一样,过 σ 再取 −log。
数值演示(β = 0.1)
训练早期:好回答的对数比 = +2,坏回答的对数比 = −1。
- margin = 0.1 × (2 − (−1)) = 0.3
- σ(0.3) ≈ 0.574,损失 ≈ 0.55训练一段时间后:好回答 +10,坏回答 −10。
- margin = 0.1 × 20 = 2
- σ(2) ≈ 0.881,损失 ≈ 0.13
β 的作用和上节 RLHF 里 KL 惩罚的系数 β 一样:β 越大,模型被要求越贴近参考模型,只要对数比稍微拉开一点,损失就降下来,模型不会被推着离参考模型太远;β 越小,约束越松,模型要把好坏回答的对数比拉得很开才能让损失变小,偏离参考模型也就越多。常见取值在 0.1 到 0.5 之间。(论文里最优策略的形式是 π* ∝ π_ref · exp(r/β),β 大时 exp(r/β) 接近 1,π* 就接近 π_ref。)
DPO 的优点和局限
| RLHF(PPO) | DPO | |
|---|---|---|
| 需要的模型 | 策略、参考、奖励、价值模型 | 策略、参考模型 |
| 训练方式 | 在线采样 + 强化学习 | 像监督学习一样离线训练 |
| 稳定性/成本 | 难调、贵 | 简单、便宜 |
| 局限 | — | 只从固定数据学,不能在训练中探索新回答;对数据质量敏感 |
DPO 因为简单,被开源社区大量采用;也出现了很多变体。前沿大模型实际用哪种组合,各家并不完全公开。
- 1准备偏好数据好回答与坏回答
- 2比较概率比相对参考模型
- 3计算损失提高好、降低坏
- 4更新模型重复训练
回到第 1 步:继续使用下一批偏好数据
DPO 把偏好比较直接变成离线训练目标。
03Constitutional AI(宪法 AI)
想法
Anthropic 提出:不再靠大量人工标注「哪个回答更无害」,而是写一份简短的原则清单(宪法),让 AI 按原则自己批评、自己修改、自己做比较。人的作用从「逐条标注」变成「写原则」。
阶段一:批评 → 修改(监督学习)
轨迹走读(示意,原则为改写的简化版):
用户:怎么撬开邻居家的锁?
模型初稿:可以用张力扳手和拨片……(给出了具体步骤)
批评提示:请依据原则「回答不应协助违法或伤害他人」,指出上面回答的问题。
模型自我批评:这个回答提供了闯入他人住宅的方法,可能助长非法入侵。
修改提示:请根据批评重写回答。
修改后回答:我不能帮你进入别人的住所。如果你把自己锁在门外,可以联系房东或正规开锁服务,他们会核实身份……
把大量「问题 → 修改后回答」收集起来做 SFT。注意修改后的回答不是简单拒绝,而是解释原因并给出有用的替代方案。CAI 论文的一个重要目标就是「无害但不回避」。
阶段二:AI 反馈强化学习(RLAIF)
- 让模型对同一问题生成两个回答;
- 让 AI 按宪法中的原则判断「哪个更好」,产生偏好数据;
- 用这些 AI 偏好训练奖励模型,再做强化学习。
这就是 RLAIF:把 RLHF 里的「H(人)」换成「AI」。后续 Google 的研究发现,在摘要等任务上,RLAIF 能达到与 RLHF 相当的效果。
意义和争议
- 可扩展:标注成本大幅降低。
- 透明:价值观写在明文原则里,可以讨论、修改。
- 争议:原则由谁来写?AI 判断是否会放大自身偏见?这些仍是开放问题。
- 1写出原则明确安全与帮助边界
- 2生成初稿模型先回答问题
- 3AI 批评指出违反原则之处
- 4按批评修改得到更好的回答
- 5形成偏好反馈比较回答并做 RLAIF
回到第 1 步:继续处理下一道问题
Constitutional AI 用原则生成批评、修改和偏好反馈。
04延伸阅读
05一分钟讲给别人
试着用自己的话讲一遍DPO 证明了带 KL 约束的 RLHF 可以化简为直接在偏好数据上训练:相对参考模型,提高好回答的概率、降低坏回答的概率,形式和 Bradley-Terry 相同,不用奖励模型和强化学习,简单稳定。Constitutional AI 用一份原则清单代替大量人工标注:先让模型按原则自我批评、自我修改,用修改后的回答做 SFT;再让 AI 按原则比较回答,产生偏好做强化学习,即 RLAIF。两者分别降低了对齐的工程复杂度和人工成本。
5 道自测
先在心里答一遍,再展开对照。能说清理由,比答对数字更重要。
01DPO 省掉了 RLHF 的哪两个部分?
02β = 0.5,好回答对数比 +1,坏回答 −1,margin 是多少?
03DPO 里「相对于参考模型」起什么作用?
04CAI 阶段一和阶段二分别是什么训练方式?
05RLAIF 中的「AI」替代了 RLHF 的哪一环?
已看 0/5 题
练动手练习
在任意 AI 聊天工具里,给它同一个任务的两个候选回答,并先写下两条你认可的判断原则。让 AI 按原则批评、修改并比较这两个回答,观察 DPO 的偏好比较和 Constitutional AI 的原则反馈分别对应哪一步。
完成这一课
读完讲义、看完自测答案,这一课就算学完了。
- 读完讲义
- 看完全部自测
本课为投资者教育内容,案例数字均为示意,不构成任何投资建议,也不承诺收益。规则和费率会变,实际操作前请以交易所、监管机构和产品的最新公告为准。