01学完你能做到
知道基座模型怎么变成「助手」,以及为什么微调可以很便宜。
02从续写机器到助手
上节说基座模型只会续写。对比演示,同一个输入:
用户:给我三个周末放松的建议。
基座模型可能的输出(续写网页里常见的格式):
给我三个周末学习的建议。给我三个周末运动的建议。……
(或者开始写一篇论坛帖子,或者跑题)
经过指令微调的模型:
- 去附近公园散步一小时……
- 做一顿不赶时间的饭……
- 晚上关掉手机看一部电影……
知识基本都来自预训练,微调主要教会的是格式与行为:看到问题要回答、按要求的格式回答、知道什么时候该停。
- 1基座模型主要学会续写
- 2SFT 示范指令与理想回答
- 3助手行为按要求回答并停下
SFT 主要改变模型的交互方式,而不是重新学习全部知识。
03指令微调(SFT,监督微调)
做法:准备大量「指令 → 理想回答」的示范数据,用和预训练一模一样的「预测下一个 token」继续训练。区别只在于数据,以及只对回答部分计算损失(模型不需要学会「生成用户的问题」)。
数据长什么样:
指令:把下面这句话翻译成英文。
输入:今天天气很好。
回答:The weather is nice today.
来源:人工撰写(InstructGPT 雇用了标注员写示范);把现有 NLP 数据集改写成指令(FLAN);让强模型自动生成(Self-Instruct)。
数据量不必很大:LIMA 论文(2023)只用 1000 条精心挑选的问答对微调 65B 的 LLaMA,没有用任何强化学习,效果就相当不错。作者据此提出「表面对齐假说」:知识主要在预训练中学到,对齐主要是学会和用户交互的风格与格式。
效果有多大:InstructGPT 论文(2022)发现,人类评估者更喜欢 13 亿参数的 InstructGPT 的回答,而不是 1750 亿参数的 GPT-3 的回答,后者大了 100 多倍(InstructGPT 用了 SFT + RLHF,RLHF 见下一节)。
04对话模板:模型怎么区分谁在说话
模型只认识 token 序列,所以多轮对话要被拼成一段带特殊标记的文本。走读一个典型模板(ChatML 风格,不同模型的标记不同):
<|im_start|>system
你是一个乐于助人的助手。<|im_end|>
<|im_start|>user
1+1等于几?<|im_end|>
<|im_start|>assistant
等于 2。<|im_end|>
逐行看:
<|im_start|>system:系统提示开始,设定身份和规则;<|im_start|>user:用户的话;<|im_start|>assistant:轮到助手,训练时只在这部分计算损失;<|im_end|>:一轮结束。模型学会了生成它就会停下,这就是模型「知道何时闭嘴」的原因。
实际后果:
- 换模型时必须用它自己的模板,否则效果显著变差。Hugging Face 的
chat_template就是用来自动处理这个的。 - 这些标记也占 token,计入上下文和费用。
- 第 16 讲(提示词基础)的「系统提示」,在模型眼里就是模板里的 system 段。
05全参数微调 vs LoRA
全参数微调:所有参数都参与更新。7B 模型用 16 位精度,光权重就约 14GB;训练时还要存梯度和优化器状态(Adam 每个参数还要存两个额外的数),总显存往往是权重的好几倍,需要多张 GPU。而且每个任务都得存一整份模型。
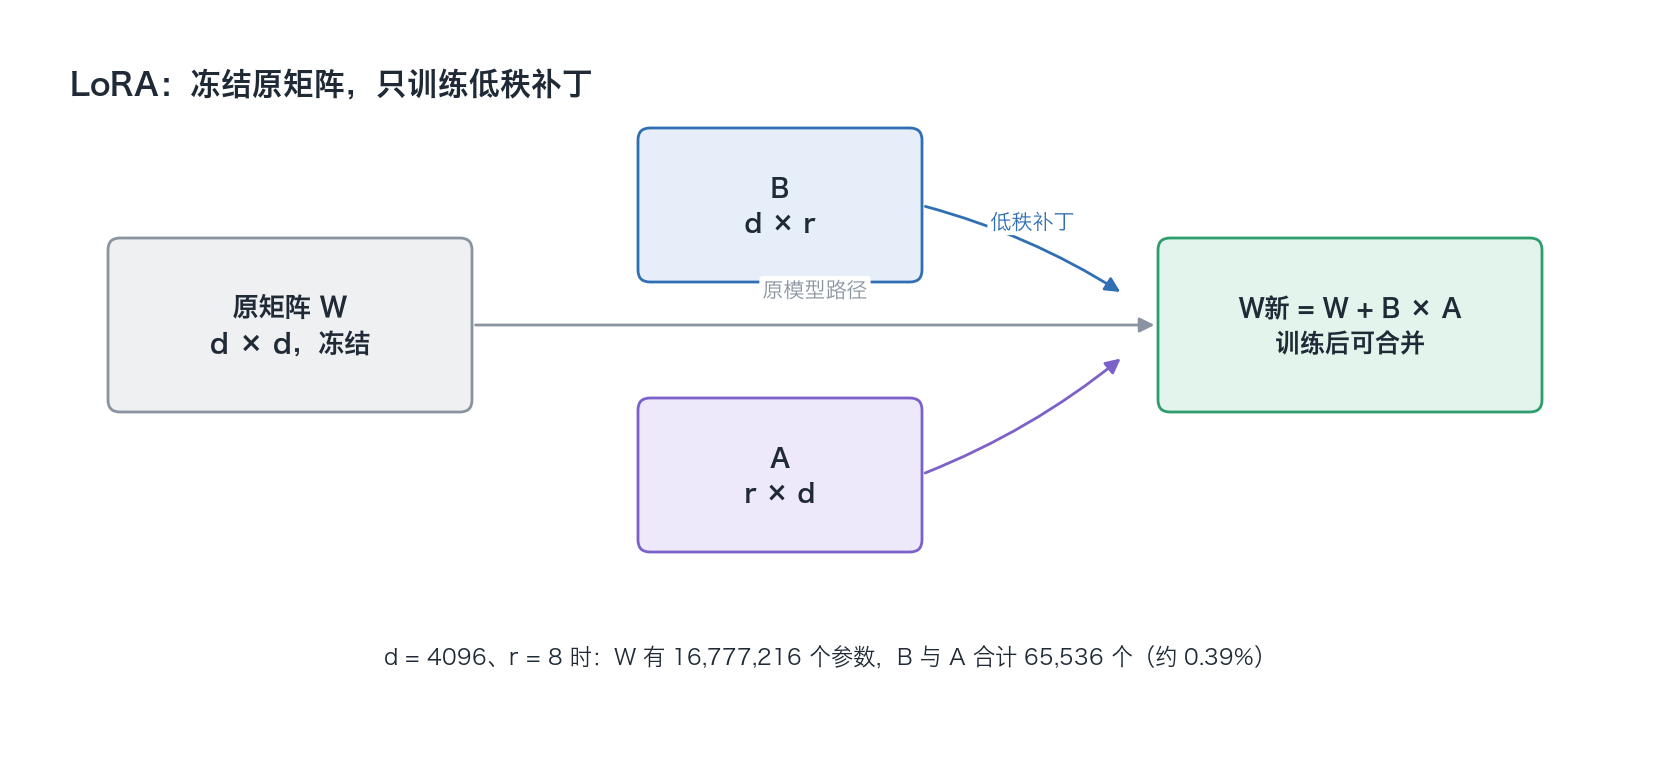
LoRA(低秩适配,2021):冻结原模型,只在旁边加一个小补丁。核心观察:微调时权重的变化量(ΔW)其实「信息量很低」,可以用两个瘦矩阵的乘积近似:
W_新 = W + B × A,其中 W 是 d×d,B 是 d×r,A 是 r×d,r 很小(比如 8)。
数值演示(d = 4096,r = 8):
- 原矩阵 W:4096 × 4096 = 16,777,216 个参数(冻结)
- B:4096 × 8 = 32,768;A:8 × 4096 = 32,768
- 可训练参数:65,536,只占原来的 0.39%。
为了手算,再缩小到 d = 4、r = 1:
- B = [1, 0, 2, 0]ᵀ(4×1),A = [0.5, 0, 0, 1](1×4)
- B×A 是一个 4×4 矩阵:第 1 行 = 1×A = [0.5, 0, 0, 1],第 2 行全 0,第 3 行 = 2×A = [1, 0, 0, 2],第 4 行全 0。
- 只用 8 个数(B 的 4 个 + A 的 4 个)就生成了 16 个数的修改量。「低秩」的意思就是:这些行都是同一行的倍数,变化的「方向」很少。
LoRA 的好处:
- 训练省显存、省时间(原论文在 GPT-3 175B 上,可训练参数减少到原来的万分之一,GPU 显存需求降到约三分之一);
- 一个基座 + 很多个几十 MB 的补丁,每个业务一个,按需切换;
- 训练后可以把 B×A 合并回 W,推理时没有额外开销。
B 初始化为 0,所以训练刚开始时 B×A = 0,模型和原来完全一样,从「不改动」平滑起步。
QLoRA(2023):先把冻结的基座压成 4 比特存储,再挂 LoRA 训练。论文报告可以在单张 48GB GPU 上微调 650 亿参数模型,且效果保持与 16 位全精度微调相当。
06什么时候选哪种(知识层面)
| 需求 | 更合适的做法 |
|---|---|
| 让模型掌握固定的输出格式、语气、领域术语 | SFT(常用 LoRA) |
| 让模型知道最新的、经常变的事实 | 检索增强 RAG(第 24 讲(RAG 原理)),而不是微调 |
| 数据少、资源有限 | LoRA / QLoRA |
| 要彻底改变模型能力、资源充足 | 全参数微调 |
注意:微调可能让模型忘掉一些原有能力(灾难性遗忘),通常要在训练数据里混入一些通用数据。
- 固定格式或语气SFT / LoRA
- 最新变化事实RAG
- 彻底改变能力全参数微调
07延伸阅读
- Ouyang et al., Training language models to follow instructions with human feedback(InstructGPT), 2022:arxiv.org
- Hu et al., LoRA: Low-Rank Adaptation of Large Language Models, 2021:arxiv.org
- Dettmers et al., QLoRA: Efficient Finetuning of Quantized LLMs, 2023:arxiv.org
- Zhou et al., LIMA: Less Is More for Alignment, 2023:arxiv.org
- Wei et al., Finetuned Language Models Are Zero-Shot Learners(FLAN), 2021:arxiv.org
- Wang et al., Self-Instruct: Aligning Language Models with Self-Generated Instructions, 2022:arxiv.org
- Hugging Face Transformers 文档「Chat templates」:huggingface.co
- Hugging Face PEFT 文档:huggingface.co
08一分钟讲给别人
试着用自己的话讲一遍基座模型只会续写,指令微调 SFT 用大量「指令 → 理想回答」的示范数据继续做下一个 token 预测,只在回答部分计算损失,让模型学会按要求回答。数据质量比数量重要,LIMA 用 1000 条就有不错效果。多轮对话靠带特殊标记的对话模板拼成一段文本,结束标记让模型知道何时停下。全参数微调更新所有参数,非常昂贵;LoRA 冻结原模型,只训练两个瘦矩阵的乘积作为补丁,参数常常不到 1%,QLoRA 再把基座压到 4 比特,单卡就能微调大模型。
5 道自测
先在心里答一遍,再展开对照。能说清理由,比答对数字更重要。
01SFT 和预训练在训练方法上有什么相同和不同?
02为什么对话模板里需要结束标记?
03d = 1024,r = 16,一个矩阵的 LoRA 可训练参数是多少?占原矩阵的百分比?
04LoRA 为什么把 B 初始化为 0?
05公司想让模型回答每天更新的产品价格,应该用微调还是检索?为什么?
已看 0/5 题
练动手练习
写一条你希望 AI 固定遵守的输出要求,例如“先给结论,再列出依据”。先直接把要求发给 AI,再设计两组“指令—理想回答”示例进行比较,观察示例如何帮助模型稳定遵守格式;不要让实验变成具体投资建议。
完成这一课
读完讲义、看完自测答案,这一课就算学完了。
- 读完讲义
- 看完全部自测
本课为投资者教育内容,案例数字均为示意,不构成任何投资建议,也不承诺收益。规则和费率会变,实际操作前请以交易所、监管机构和产品的最新公告为准。