01学完你能做到
说清幻觉从哪来、怎么缓解。
02什么是幻觉
幻觉(hallucination):模型生成了流畅、看起来合理、语气自信,但不正确的内容。OpenAI 在文章里举过一个例子:问一个常用聊天机器人,论文作者之一 Adam Tauman Kalai 的博士论文题目是什么,它自信地给出三个不同答案,全都不对;问他的生日,给了三个不同日期,也全错。
幻觉的麻烦在于:它和正确回答长得一样,语气同样笃定,读者很难分辨。
03分类
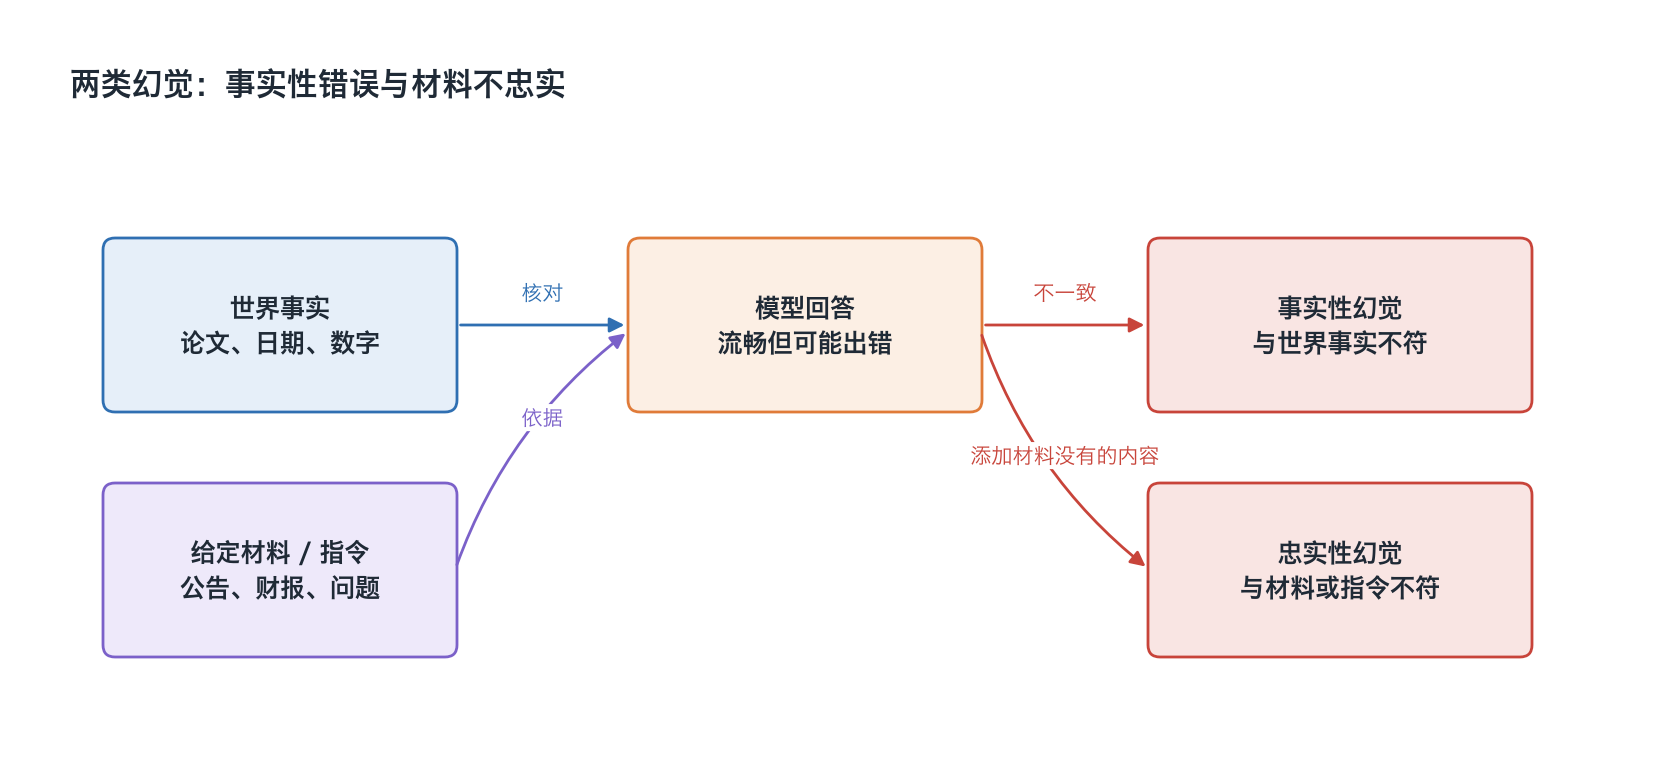
主流综述(Huang 等,2023)把幻觉分为两大类:
- 事实性幻觉:与世界事实不符。
- 例:编造不存在的论文和链接;把发明者、日期、数字说错。
- 忠实性幻觉:与用户给的材料或指令不符。
- 例:总结一份报告时加进给定资料没有的数字;要求「只用中文回答」却混入英文;前文说 A,后文说非 A。
在做 RAG(第 24 讲(RAG 原理))时,第二类特别重要:哪怕资料是对的,模型也可能「不忠实于资料」。
04幻觉从哪来
预训练:低频事实本来就学不准
OpenAI 2025 年的文章给了一个很好的类比:
- 给几百万张猫狗照片标上「猫」或「狗」,算法能学得很准,因为有规律可循;
- 但如果给每张宠物照片标上宠物的生日,无论算法多强,都一定会出错,因为生日是随机的,没有规律。
语言模型也是这样:
- 拼写、语法、括号配对有稳定规律,规模一大,这类错误就消失了;
- 任意的低频事实(某个不知名人物的生日、某篇冷门论文的标题),在训练数据里只出现过一两次甚至没出现,无法从规律中推出,于是模型只能「编一个最像的」。
另外,预训练只看到「流畅的正确文本」,没有被标为「错误」的反例,所以模型更难学会区分真假。
评测:只看准确率,等于奖励「猜」
这是 OpenAI 文章的核心论点。想象一场选择题考试:不会就空着得 0 分,瞎猜还有机会得分。如果只算答对率,理性的考生永远会猜。
数值演示:问模型某人的生日,它不知道。
- 猜「9 月 10 日」:有 1/365 的机会对。
- 说「我不知道」:一定是 0 分。
在只看准确率的评分下,猜中得 1 分,猜错和拒答都得 0 分,所以猜的期望得分 = 1/365 > 0 = 拒答。几千道题累积下来,爱猜的模型在排行榜上更好看。
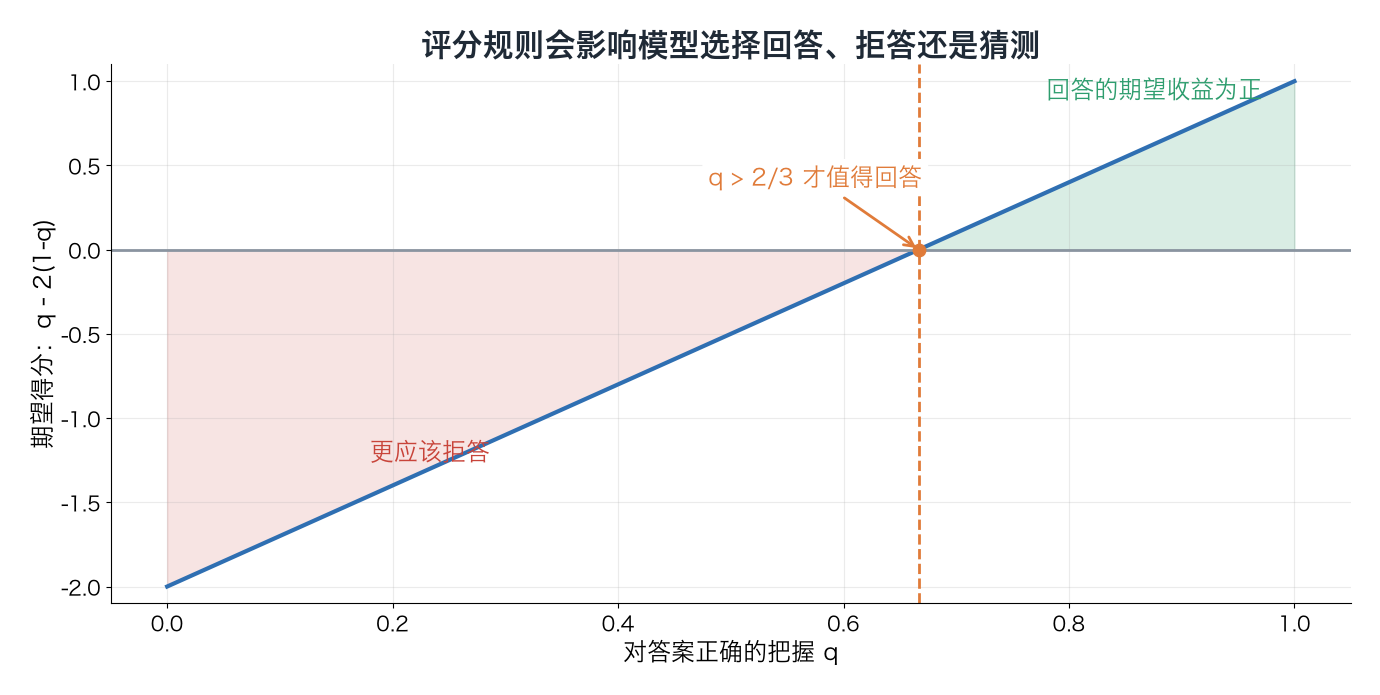
如果答错要扣分呢? 设模型对答案的把握为 q:
- 答错扣 1 分:猜的期望 = q − (1 − q) = 2q − 1。q > 0.5 才值得答。
- 答错扣 3 分:期望 = q − 3(1 − q) = 4q − 3。q > 0.75 才值得答。
评分规则直接决定了模型「该不该猜」。
真实数据:准确率差不多,幻觉差很多
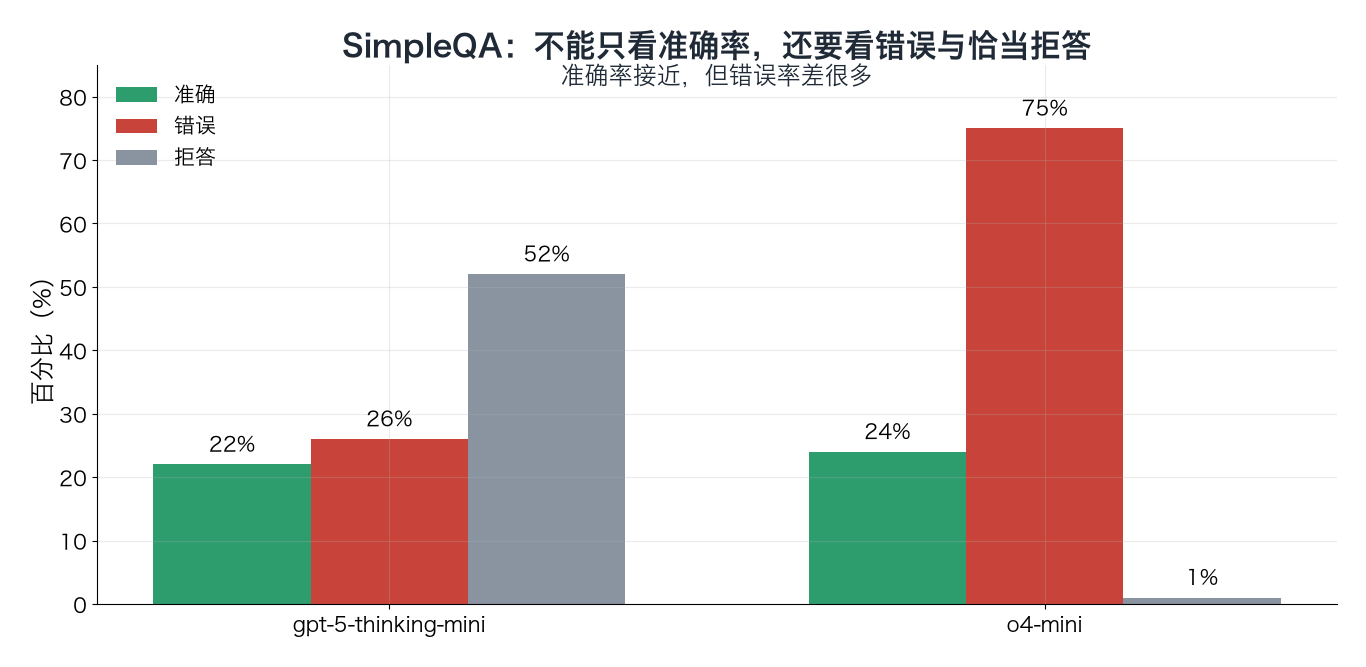
OpenAI 文章引用的 SimpleQA 评测数据(原始出处是 GPT-5 System Card):
| 指标 | gpt-5-thinking-mini | OpenAI o4-mini |
|---|---|---|
| 拒答率 | 52% | 1% |
| 准确率 | 22% | 24% |
| 错误率(幻觉) | 26% | 75% |
只看准确率,o4-mini 还稍高一点;但它的错误率是另一个模型的近三倍。「策略性地猜」提高了准确率,也大大增加了幻觉。
其他来源
- 训练数据本身有错误、过时信息;
- 解码随机性:采样到低概率的错误 token 后会「将错就错」(第 14 讲(解码与采样));
- 后训练可能让模型更倾向于自信、讨好的回答(第 11 讲(RLHF:用人类反馈训练模型));
- 上下文过长时,模型忽略或混淆给定资料中的信息。
05怎么缓解
模型和训练层面
- 改评分规则:自信的错误比不确定扣分更重,给恰当的「不确定」部分分。OpenAI 主张,主流的评测都要改,而不是只加几个专门的幻觉评测。
- 校准:让模型说的置信度和真实正确率相符。研究发现,大模型在一定程度上「知道自己知不知道」(Kadavath 等,2022)。OpenAI 的文章还指出:做到校准比做到准确容易得多,小模型反而可能更容易知道自己的边界。
- 推理模型:OpenAI 称 GPT-5 在推理时幻觉明显更少,但仍会发生。
使用层面(提示词前后对比)
改进前:
列出 5 篇关于大模型幻觉的论文,附链接。
(容易得到看似真实、实际不存在的论文和链接。)
改进后:
下面是我检索到的论文列表:〈粘贴资料〉。请只根据这些资料,列出与幻觉评测相关的论文。资料里没有的不要补充;如果不确定,写「资料中未提及」。每条注明来自资料的哪一段。
改进点:
- 提供资料(RAG),把「回忆」变成「阅读理解」;
- 明确允许拒答;
- 要求引用出处,便于核查;
- 必要时降低 temperature。
系统层面
- 检索增强(第 24 讲(RAG 原理))、调用工具查实时数据(第 28 讲(什么是 Agent)起);
- 让另一个模型或规则对输出做事实核查;
- 关键信息必须由人复核。
- 1提供可靠资料限定回答依据
- 2允许明确拒答资料没有就说未提及
- 3要求引用证据标出材料位置
- 4检索与规则核查交叉检查关键事实
- 5人工复核重要内容最后确认
降低幻觉需要同时给资料、给拒答空间、要证据并做复核。
06几个常见误解(来自 OpenAI 文章的结论)
- 「准确率做到 100% 就没有幻觉了」→ 准确率到不了 100%,有些问题本身就无法回答。
- 「幻觉不可避免」→ 不对,模型可以在不确定时选择拒答。
- 「只有更大的模型才能避免幻觉」→ 不一定,知道自己的边界比答对容易。
- 「幻觉是神秘的故障」→ 其统计机制已经可以解释。
- 「做一个好的幻觉评测就够了」→ 不够。几百个只看准确率的传统评测都在奖励猜,单独一个幻觉评测抵消不了,主流评测指标都要改。
07延伸阅读
- OpenAI, Why language models hallucinate, 2025-09-05:openai.com
- Kalai et al., Why Language Models Hallucinate, 2025(上文对应的论文):arxiv.org
- Huang et al., A Survey on Hallucination in Large Language Models: Principles, Taxonomy, Challenges, and Open Questions, 2023:arxiv.org
- Kadavath et al., Language Models (Mostly) Know What They Know, 2022:arxiv.org
08一分钟讲给别人
试着用自己的话讲一遍幻觉是模型流畅、自信但不正确的输出,分为与事实不符的事实性幻觉和与给定材料或指令不符的忠实性幻觉。根源之一是预训练:任意的低频事实没有规律可学,模型只能编出最像的答案。另一个根源是评测只看准确率,猜总比说不知道得分高,于是模型被训练成爱猜。缓解办法是改评分规则、惩罚自信的错误、提升校准,使用时提供资料、允许拒答、要求引用并人工复核。
5 道自测
先在心里答一遍,再展开对照。能说清理由,比答对数字更重要。
01事实性幻觉和忠实性幻觉的区别?各举一例。
02为什么模型很少拼错字,却常编错冷门人物的生日?
03答错扣 2 分、拒答 0 分,模型把握 q 至少多大才值得回答?
04在 SimpleQA 数据中,为什么说只看准确率会误导?
05举出两个使用者可以采用的减少幻觉的提示技巧。
已看 0/5 题
练动手练习
在任意 AI 聊天工具里,先粘贴一段包含明确事实的短材料,再问一个材料没有提供答案的问题。分别测试“请直接回答”和“只根据材料回答,不确定就说未提及”,比较两次回答的确定程度,并圈出需要人工核查的句子。
完成这一课
读完讲义、看完自测答案,这一课就算学完了。
- 读完讲义
- 看完全部自测
本课为投资者教育内容,案例数字均为示意,不构成任何投资建议,也不承诺收益。规则和费率会变,实际操作前请以交易所、监管机构和产品的最新公告为准。