01学完你能做到
写出清楚、具体、带角色和约束的提示词。
02提示词是什么
提示词(prompt) 是交给模型的全部文字输入。第 4 讲(词向量与语言模型)讲过,语言模型做的事是「根据前文预测下一个 token」,所以提示词就是那个「前文」。前文写成什么样,后面续写出来的内容就是什么样。
提示词工程不涉及改模型参数。它只改输入,所以成本最低、见效最快,是所有 AI 应用的第一道工序。
Anthropic 的文档给了一个好用的比喻:把模型当成一个聪明但刚入职的新同事,他不了解你们的规矩和背景,你说得越精确,结果越好。文档还给了一个检验办法:把提示词拿给一个不了解这项任务的同事看,如果他看不懂,模型多半也看不懂。
03系统提示和用户提示
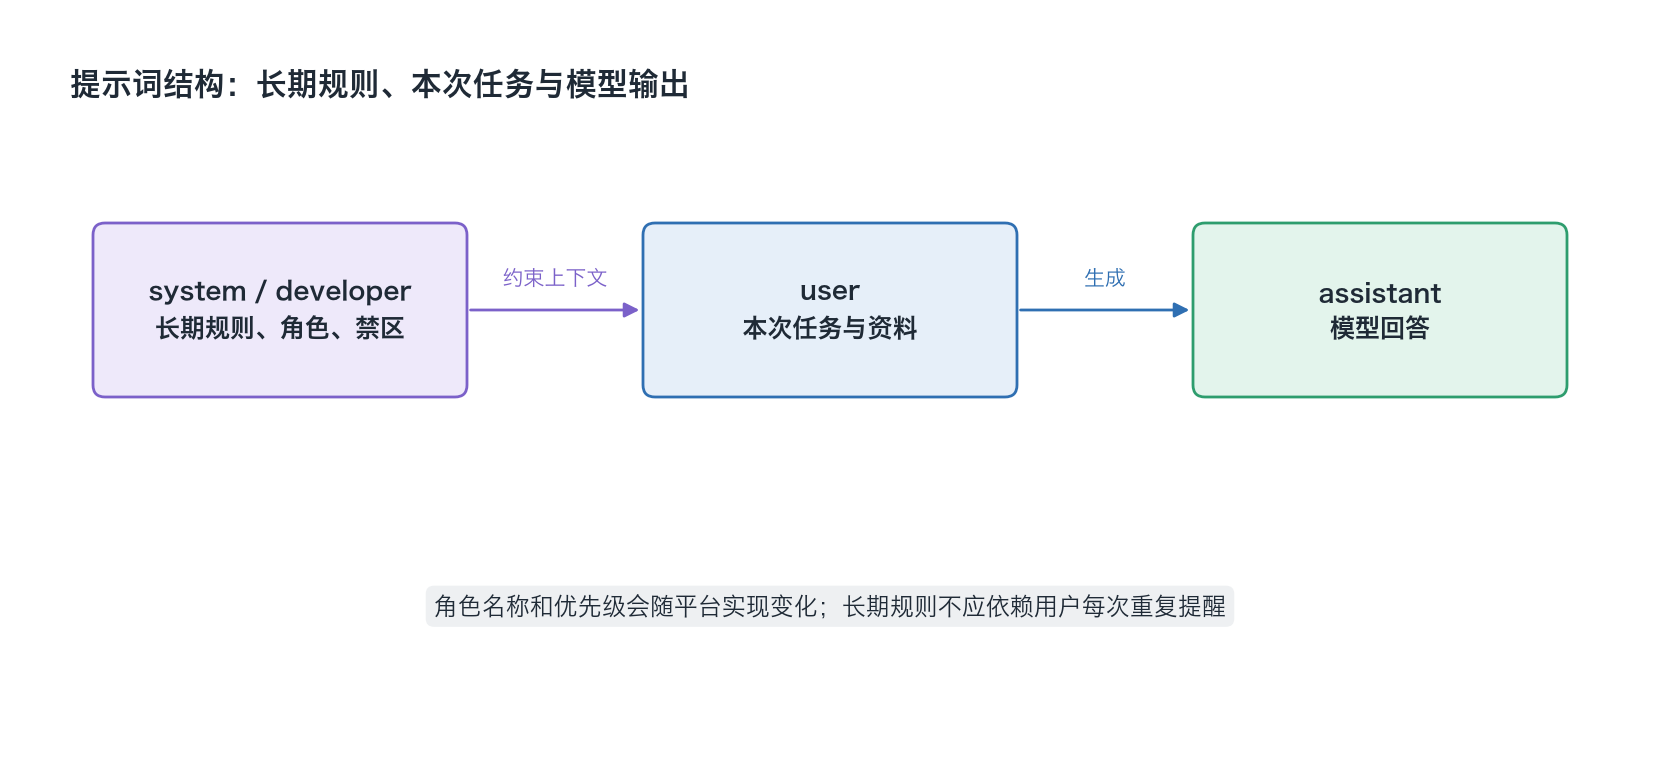
调用模型时,消息分成几种角色:
- 系统提示(OpenAI 新接口里叫
developer消息或instructions参数):开发者写好的长期规则,比如角色、语气、禁区、输出格式。 - 用户提示(
user):每次请求都不同的内容,比如这次要处理的文件和问题。 - 助手消息(
assistant):模型自己之前的回答。
OpenAI 文档明确写道:developer 消息的优先级高于 user 消息。它还打了个比方:developer 消息像函数定义,user 消息像传给函数的参数。
这对设计提示词意味着:
- 产品层面的规则(如「不提供投资建议」)应该放在系统提示里,不能指望用户每次都说。
- 用户输入的内容即使写着「忽略上面的规则」,也不应该推翻系统提示。不过,模型是否真的不会被推翻,要靠测试验证(第 39 讲(提示注入)会讲提示注入)。
04写好提示词的五个要素
| 要素 | 问自己 | 例子 |
|---|---|---|
| 角色 | 模型以什么身份回答? | 你是资深量化研究助理 |
| 任务 | 具体要做什么动作? | 列出周报里需要本周处理的风险 |
| 背景 | 为什么做、给谁看? | 读者是没有技术背景的销售总监 |
| 约束 | 不能做什么、范围多大? | 只依据资料;不确定就写「资料未提及」 |
| 格式 | 输出长什么样? | 先一句结论,再 3 条要点,总共不超过 200 字 |
Anthropic 文档还强调要解释原因。例如,与其只写「不要用省略号」,不如写「这段文字要交给语音合成朗读,它不会读省略号,所以不要用」。模型理解了原因,就能推广到没明说的类似情况。
- 角色以什么身份回答
- 任务具体做什么动作
- 背景为什么做、给谁看
- 约束范围与禁区
- 格式输出长什么样
05演示:同一个需求改三遍
第 0 版(模糊)
帮我写个产品介绍。模型不知道产品是什么、给谁看、写多长,只能写出一段泛泛的套话。
第 1 版(补上任务和背景)
帮我写一段「智能算法交易平台」的产品介绍,放在官网首页,读者是私募基金的交易主管。方向对了,但长度和重点仍然靠猜。
第 2 版(再补约束和格式)
你是一名金融科技产品的文案。
任务:为「智能算法交易平台」写官网首页介绍。
读者:私募基金交易主管,懂交易但不关心技术细节。
必须提到:降低冲击成本、支持多券商接入、实时绩效分析。
不能出现:收益承诺、「保证」「稳赚」等字样。
格式:一句标题(不超过 15 字)+ 3 个要点(每个不超过 30 字)。
每改一遍,模型需要「猜」的东西就少一些。检查方法很简单:数一数还剩哪些问题模型必须自己猜,比如长度、受众、重点、禁区、格式。
- 1写出任务先说明要做什么
- 2补受众和背景明确给谁、为什么
- 3补约束范围、禁区、证据
- 4补输出格式长度、结构、验收标准
每补一层真正影响答案的信息,模型需要猜的内容就少一层。
06分隔符:把指令和资料分开
当提示词里既有指令又有大段资料时,要用分隔符把它们隔开。常用的写法有:
- XML 标签,如
<资料>…</资料> - Markdown 标题
- 三个引号
Anthropic 文档建议用 XML 标签包裹不同类型的内容(指令、背景、示例、输入),因为这样模型解析得更清楚。OpenAI 文档也推荐同时使用 Markdown 和 XML 标签来标出逻辑边界。
分隔有两个好处:
- 模型更清楚哪部分是要遵守的规则,哪部分只是要处理的材料。
- 资料里如果混入「请忽略以上指令」之类的话,模型更不容易把它当成指令。这只能降低风险,不能保证安全。
关于长资料还有一条实用建议,来自 Anthropic 文档:长文档放在提示词前面,问题放在最后。文档称,在测试中这种写法能把回答质量最多提升 30%,复杂的多文档输入效果尤其明显。
- 1写明长期规则角色、约束、格式
- 2用标签包住资料XML、标题或引号
- 3把问题放最后长资料先给依据
- 4先引用再回答让结果可核查
分隔符能帮助模型区分指令和材料,但不能保证安全。
07给模型「思考空间」
模型每生成一个 token 的计算量是固定的。如果要求它直接给出答案,复杂问题就只能「一步猜到底」。如果允许它先把中间步骤写出来,每一步都成为后面步骤可以参考的「前文」,相当于给了它草稿纸。下面第 18 讲(思维链 CoT)会详细讲这种做法,叫思维链。
工程上常见的写法:
先在 <思考> 标签里逐条核对资料、列出计算过程,
再把最终结论写在 <答案> 标签里。
程序只把 <答案> 里的内容展示给用户,思考过程用来排查问题。
注意:第 13 讲(推理模型)讲的推理模型会在内部自动思考。OpenAI 文档说,推理模型给高层目标就能做好,GPT 类模型则需要更精确的指令。所以对推理模型,不必再手写「一步步想」。
- 1读取任务与规则确认目标和限制
- 2核对资料找出相关证据
- 3列步骤或计算先完成中间处理
- 4输出最终答案按格式展示结果
推理模型通常会自行完成更多推理,关键仍是目标、约束和验收标准清楚。
08常见误区
- 越长越好:不对。要写的是模型需要的信息,不是堆砌形容词。
- 只说不要什么:只写「不要啰嗦」,模型不知道该写成什么样。更好的写法是「用 3 条要点,每条不超过 30 字」。
- 改一次就上线:模型输出有随机性。OpenAI 文档建议固定模型版本,并为提示词建立测试和评估集(第 38 讲(评测)会讲评估)。
09延伸阅读
- Anthropic, Prompting best practices(Claude 文档):platform.claude.com
- OpenAI, Prompt engineering 指南:platform.openai.com
10一分钟讲给别人
试着用自己的话讲一遍提示词就是模型续写时依据的前文,写得越清楚,模型越不用猜。系统提示放长期规则,优先级高于用户提示;用户提示放每次的具体任务和资料。一条好的提示词要交代角色、任务、背景、约束和格式,最好再解释原因。用 XML 标签等分隔符把指令和资料分开,长资料放前面、问题放最后。复杂任务要给模型思考空间:先写过程,再写答案。
5 道自测
先在心里答一遍,再展开对照。能说清理由,比答对数字更重要。
01系统提示和用户提示分别适合放什么?哪个优先级更高?
02「帮我写份总结」缺了哪些要素?请改写成具体版本。
03为什么要用分隔符把资料和指令分开?
04「不要用省略号」和「这段文字要给语音合成朗读,它不会读省略号,所以不要用」哪个更好?为什么?
05对推理模型还需要写「请一步步思考」吗?
已看 0/5 题
练动手练习
把一个你平时会说的模糊任务写下来,例如“帮我整理这份周报”。再按角色、任务、背景、约束、格式五项补全提示词,分别提交两个版本,比较模型少猜了哪些内容。
完成这一课
读完讲义、看完自测答案,这一课就算学完了。
- 读完讲义
- 看完全部自测
本课为投资者教育内容,案例数字均为示意,不构成任何投资建议,也不承诺收益。规则和费率会变,实际操作前请以交易所、监管机构和产品的最新公告为准。