01学完你能做到
理解「让模型一步步想」为什么有效。
02什么是思维链
思维链(Chain-of-Thought,CoT):让模型在给出答案之前,先写出一系列中间推理步骤。
这个概念来自 Wei 等 2022 年的论文。他们的做法很简单:在 few-shot 示例里,不只写「问题 → 答案」,而是写「问题 → 推理过程 → 答案」。模型看到示例里有推理过程,回答新问题时也会先写推理过程。
- 1给出问题输入任务
- 2写中间步骤拆解复杂问题
- 3给出答案仍需独立核对
03演示:同一道题,两种提示
题目:每箱 37 瓶,买了 23 箱,送出去 158 瓶,还剩几瓶?
标准提示(示例只有答案)
问:罗杰有 5 个网球,又买了 2 罐,每罐 3 个,现在有几个?
答:11
问:每箱 37 瓶,买了 23 箱,送出去 158 瓶,还剩几瓶?
答:
模型要在一个 token 里直接「蹦出」一个三位数,容易出错,比如图中的「713」。
思维链提示(示例带推理过程)
问:罗杰有 5 个网球,又买了 2 罐,每罐 3 个,现在有几个?
答:罗杰原有 5 个。2 罐每罐 3 个,就是 6 个。5 + 6 = 11。答案是 11。
问:每箱 37 瓶,买了 23 箱,送出去 158 瓶,还剩几瓶?
答:
模型照着示例的格式回答:
一共 37 × 23 = 851 瓶。送出 158 瓶,851 − 158 = 693。答案是 693。我们逐步核对:37 × 23 = 37 × 20 + 37 × 3 = 740 + 111 = 851;851 − 158 = 693。正确。
(说明:「713」这个错误答案是示意。这类错误确实常见,下面的论文数据可以佐证。)
04为什么有效
可以从三个角度理解:
- 计算量:模型每生成一个 token 的计算量是固定的。直接给答案,等于只给它「一步」的计算量。写出 10 步推理,就多出了 10 步的计算量。
- 草稿纸:第 7 讲(注意力机制)讲过(因果注意力),模型生成每个新 token 时都能看到前面所有内容。写下的中间结果(比如 851)会成为下一步的输入,不用在「脑子里」记着。
- 拆解:复杂问题被拆成多个简单子问题,每一步都是模型擅长的小运算。
Wei 等论文的一个重要发现:这种能力在足够大的模型里才自然出现。小模型写出的推理过程常常不通顺,反而可能拉低效果。论文里最醒目的结果是:用 5400 亿参数的模型,只给 8 个思维链示例,就在 GSM8K(小学数学应用题)上达到当时的最好水平,超过了经过微调并配备验证器的 GPT-3。
05Zero-shot CoT:一句话的威力
Few-shot CoT 需要人工写推理示例。Kojima 等(2022)发现一个更省事的办法:不给示例,只在答案前加一句
Let's think step by step.(让我们一步一步地思考。)
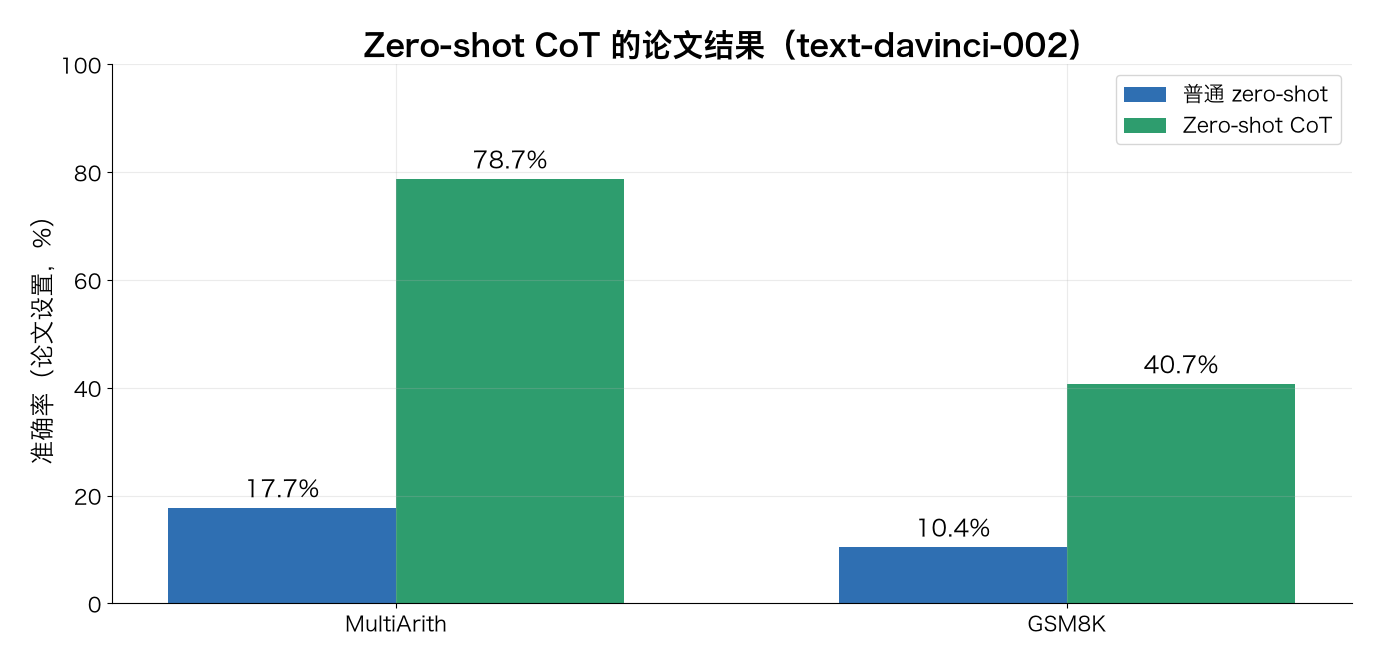
效果非常明显(text-davinci-002 模型):
- MultiArith:17.7% → 78.7%
- GSM8K:10.4% → 40.7%
论文还报告,在 5400 亿参数的 PaLM 上也有幅度相近的提升。
在实际调用时,论文的做法分两步:
- 第一次调用:问题 + 「Let's think step by step.」,让模型写出推理过程。
- 第二次调用:把推理过程接在后面,再加一句「所以答案(阿拉伯数字)是」,从中抽出干净的答案。
论文把这两步分别叫「推理抽取」和「答案抽取」,论文中的第二句触发词是 Therefore, the answer (arabic numerals) is,选择题则换成对应选项格式的触发词。论文全程用贪心解码。代价是每道题要调用两次模型。
论文还比较了不同的触发句,「Let's think step by step.」效果最好;换成和推理无关或误导性的句子,效果就明显变差。
- 1问题加触发句加入 step by step 提示
- 2生成推理过程第一次调用
- 3抽取最终答案第二次调用
06Plan-and-Solve:先计划,再执行
Wang 等(2023)分析了 Zero-shot CoT 的错误,归成三类:
- 计算错误:步骤对,但算错了;
- 漏步骤:跳过了必要的中间步骤;
- 理解错误:读错了题意。
针对漏步骤,他们提出了 Plan-and-Solve(PS):先制定计划,把任务拆成子任务,再按计划逐个完成。针对计算错误,又加了更细的指令,叫 PS+,比如「提取相关变量和对应数字」「注意计算正确」。
论文给出的 PS+ 提示是:
Let's first understand the problem, extract relevant variables and their corresponding numerals, and make a plan. Then, let's carry out the plan, calculate intermediate variables (pay attention to correct numerical calculation and commonsense), solve the problem step by step, and show the answer.
中文意译:
让我们先理解问题,提取相关变量和对应的数字,并制定一个计划。
然后按计划执行,计算中间变量(注意计算正确、常识正确),
一步步解题并给出答案。
论文在 GPT-3 上测试了 10 个数据集。PS+ 在所有数据集上都明显超过 Zero-shot CoT,在数学推理上与 8 个示例的 few-shot CoT 相当。
- 1理解问题提取变量和数字
- 2制定计划拆成子任务
- 3按计划执行计算并检查
07用的时候要注意
- 推理模型已经内置了思维链(第 13 讲(推理模型))。对 o 系列、R1 一类模型,不需要再写「一步步思考」。
- 简单任务不必用。查资料、改写句子这类任务加 CoT 只会增加长度和成本。
- 推理过程不一定可信。写出来的步骤看起来合理,但不能保证就是模型真正的计算路径,也可能中间出错、结论却碰巧对。重要结论仍要核对。
- 成本:输出 token 变多,费用和延迟都会增加。
08延伸阅读
- Wei et al., Chain-of-Thought Prompting Elicits Reasoning in Large Language Models, 2022:arxiv.org
- Kojima et al., Large Language Models are Zero-Shot Reasoners, 2022:arxiv.org
- Wang et al., Plan-and-Solve Prompting, 2023:arxiv.org
- Cobbe et al., Training Verifiers to Solve Math Word Problems, 2021(GSM8K 数据集):arxiv.org
09一分钟讲给别人
试着用自己的话讲一遍思维链是让模型先写中间推理步骤,再给答案。它有效是因为每个 token 的计算量固定,写出步骤等于多给计算量;写下的中间结果成了后续的输入,像草稿纸;复杂问题也被拆成了简单的小步骤。Few-shot CoT 在示例里写出推理过程,这种能力在大模型上才明显。Zero-shot CoT 只加一句「Let's think step by step」,就让 MultiArith 从 17.7% 升到 78.7%。Plan-and-Solve 先计划再执行,减少漏步骤和计算错误。推理模型已经内置了这一能力。
5 道自测
先在心里答一遍,再展开对照。能说清理由,比答对数字更重要。
01标准 few-shot 和 few-shot CoT 的示例有什么不同?
02从「计算量」的角度解释思维链为什么有效。
03Zero-shot CoT 在 GSM8K 上把准确率从多少提到了多少?
04Plan-and-Solve 针对 Zero-shot CoT 的哪类错误?PS+ 又加了什么?
05什么情况下不建议用 CoT?
已看 0/5 题
练动手练习
在任意 AI 聊天工具里,提交一道需要多步计算的题,先要求直接给答案,再要求写出中间步骤。用纸笔或计算器核对结果,比较两种提示的准确性、长度和耗时,不要把“写得像推理”当成已经验证正确。
完成这一课
读完讲义、看完自测答案,这一课就算学完了。
- 读完讲义
- 看完全部自测
本课为投资者教育内容,案例数字均为示意,不构成任何投资建议,也不承诺收益。规则和费率会变,实际操作前请以交易所、监管机构和产品的最新公告为准。