01学完你能做到
让模型稳定输出 JSON 等格式。
02为什么需要结构化输出
人读回答时,多一句客套话无所谓。程序读回答就不行了。比如风控系统要从模型输出里取出「风险等级」这个字段,再决定是否拦截。只要模型多写一句「好的,以下是结果:」,或者把字段名写成「风险级别」,程序就会解析失败。
所以,当模型的输出要交给程序而不是人看的时候,就需要结构化输出:让模型按约定的格式(最常见的是 JSON)输出,字段名、类型、取值范围都固定。
JSON 是一种用键值对表示数据的文本格式,例如:
{"风险等级": "高", "理由": "单笔金额超过日均 20 倍", "需要人工复核": true}03用 JSON Schema 描述「长什么样」
JSON Schema 是一份描述 JSON 结构的「说明书」。它规定:
- 有哪些字段,哪些字段必须有(
required); - 每个字段是什么类型(字符串、数字、布尔值、数组……);
- 取值能不能是固定几个选项之一(
enum); - 是否允许多出没定义的字段(
additionalProperties: false表示不允许)。
上面那个例子对应的 Schema 大致是:
{
  "type": "object",
  "properties": {
    "风险等级": {"type": "string", "enum": ["高", "中", "低"]},
    "理由": {"type": "string"},
    "需要人工复核": {"type": "boolean"}
  },
  "required": ["风险等级", "理由", "需要人工复核"],
  "additionalProperties": false
}
即使不写代码,也要能读懂这份说明书,因为它就是「模型输出」和「下游系统」之间的接口约定。
04三个可靠性层级
| 层级 | 做法 | 保证什么 | 不保证什么 |
|---|---|---|---|
| 1 | 只在提示词里写「请输出 JSON」 | 什么都不保证 | 可能夹带解释文字、漏字段、写错字段名 |
| 2 | JSON 模式 | 输出一定是合法 JSON | 不保证字段和取值符合你的要求 |
| 3 | 结构化输出(Schema + strict) | 输出符合你给的 Schema | 拒答、输出被截断这类情况仍需处理 |
OpenAI 文档原话的意思是:结构化输出是 JSON 模式的升级版,两者都保证合法 JSON,但只有结构化输出保证遵守 Schema;能用结构化输出时,建议总是用它。文档列出的好处有三条:
- 不需要再校验或重试格式错误的回答;
- 出于安全原因的拒答可以被程序识别出来;
- 提示词不必再用强硬措辞反复强调格式。
- 提示词要求不保证格式
- JSON 模式保证合法 JSON
- Schema + strict约束字段和类型
05原理:受约束解码
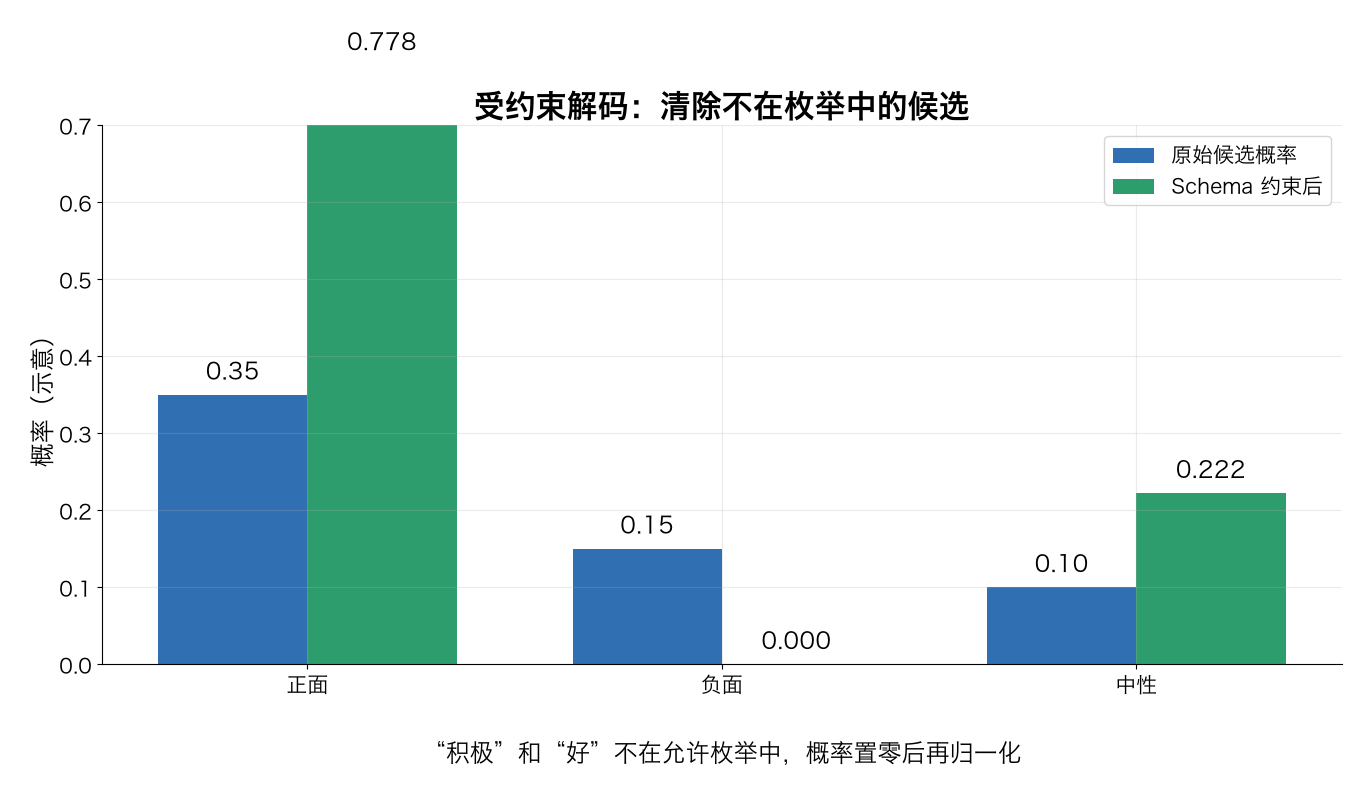
第 14 讲(解码与采样)讲过,模型每一步都会给所有候选 token 打出一个概率,再从中挑一个。受约束解码(constrained decoding)就是在挑之前加一道筛子:按 Schema 判断哪些 token 在当前位置是合法的,把不合法的概率清零,剩下的重新归一化。
手算演示(概率为示意):模型已经写到 {"情绪": ",Schema 规定这里只能是「正面 / 负面 / 中性」。
- 模型原本想写的下一个词:正面 0.35、积极 0.30、负面 0.15、中性 0.10、好 0.10。
- 「积极」「好」不在允许的枚举里,清零。
- 剩下的和:0.35 + 0.15 + 0.10 = 0.60。
- 重新归一化:正面 0.35/0.60 = 0.583,负面 0.15/0.60 = 0.250,中性 0.10/0.60 = 0.167。
不受约束时,模型有 40% 的概率写出不合法的词(「积极」或「好」)。受约束后,这个概率变成 0。
(说明:这是通用原理。OpenAI 等厂商内部具体怎么实现,文档没有详细公开。开源库 Outlines 的论文(Willard & Louf, 2023)公开了它的做法:把正则表达式或语法规则转换成有限状态机,事先为模型词表建好索引,生成时每一步只放行能让状态机继续走下去的 token。论文说这种做法能保证生成文本的结构,额外开销很小。)
- 1模型给候选概率所有可能 token
- 2Schema 筛选去掉不合法候选
- 3重新归一化得到合法输出分布
06程序侧兜底:解析、校验、重试
即使用了结构化输出,也不能完全不设防。OpenAI 文档专门提醒了两种边界情况:
- 拒答:出于安全原因拒绝回答时,返回的不是你的 Schema,而是一个单独的
refusal字段; - 截断:输出达到 token 上限时,JSON 可能写到一半就停了。
如果用的是只靠提示词的第 1 级做法,或者用的模型不支持结构化输出,就更需要兜底流程:
- 解析:尝试把文本解析成 JSON;
- 校验:按 Schema 检查字段、类型、取值;
- 重试:失败了就把错误信息附在提示里再调用一次,比如「上次输出缺少字段『理由』,请补全」;
- 设上限:最多重试 2 次,仍失败就走人工或默认值。
算一笔账(假设各次失败相互独立,这在现实中只是近似):单次失败率 5%,最多重试 2 次,那么 3 次全失败的概率是 0.05³ = 0.0125%,大约万分之一。
- 1解析 JSON先检查能否读取
- 2校验 Schema检查字段类型
- 3判断是否失败处理拒答和截断
- 4重试或转人工设置次数上限
回到第 1 步:失败且未到上限时带错误信息重试
07Schema 设计的几条建议
OpenAI 文档建议:
- 字段名起得清楚直观;
- 给重要字段写标题和说明(
description)。模型会读这些说明,它们相当于嵌在 Schema 里的提示词; - 用评测比较不同的结构设计,找出最适合自己场景的那一个。
再补充两条常用经验:
- 先推理、后结论:如果需要模型思考,可以在 Schema 里把「推理过程」字段放在「结论」字段前面。模型从左到右生成,这样写结论时已经有了推理作为「前文」(第 18 讲(思维链 CoT)的思维链原理)。OpenAI 文档里的数学辅导例子就是先
steps再final_answer。 - 用枚举代替自由文本:能用固定选项的字段,就不要让模型自由发挥。
08对推理模型写提示词有什么不同
第 13 讲(推理模型)讲的推理模型会在内部先思考,再给出回答。给它们写提示词时:
- 不必写「一步步思考」,它们本来就会;
- 给目标和约束,不要规定每一步怎么做。OpenAI 的提示词工程指南原话是:推理模型像资深同事,给它一个目标,就可以放心让它自己搞定细节;GPT 模型像新同事,给出明确的指令,它才能做出特定的结果。OpenAI 的推理模型最佳实践还提醒:提示词要简单直接,不必写「一步步思考」,有时反而有害;先试零样本,需要时再加少量示例;
- 格式要求依然要明确。内部想得再多,最终输出给程序时也要符合 Schema,结构化输出照样适用。
09延伸阅读
- OpenAI, Structured model outputs(Structured Outputs 指南):platform.openai.com
- OpenAI, Prompt engineering:platform.openai.com
- OpenAI, Reasoning best practices:platform.openai.com
- JSON Schema 官方入门 Understanding JSON Schema:json-schema.org
- Outlines(开源的结构化生成库):github.com ;Willard & Louf, Efficient Guided Generation for Large Language Models, 2023:arxiv.org
10一分钟讲给别人
试着用自己的话讲一遍当模型输出要交给程序时,需要结构化输出:用 JSON Schema 规定字段、类型、取值和必填项。可靠性分三级:只写在提示词里,什么都不保证;JSON 模式只保证是合法 JSON;结构化输出保证遵守 Schema。它的原理是受约束解码:每一步把不合法 token 的概率清零,再重新归一化。程序侧仍要处理拒答和截断,没有结构化输出时要解析、校验、带着报错重试,并设上限。Schema 字段要起清楚的名字、写说明,推理字段放在结论前面。
5 道自测
先在心里答一遍,再展开对照。能说清理由,比答对数字更重要。
01JSON 模式和结构化输出的区别是什么?
02模型写到 `"等级": "` 时,候选概率是:高 0.2、很高 0.4、中 0.3、低 0.1,允许的枚举是高/中/低。受约束解码后各选项的概率是多少?
03用了结构化输出,还有哪两种情况要处理?
04为什么建议把「推理过程」字段放在「结论」字段前面?
05单次解析失败率 10%,最多重试 1 次,最终失败率大约是多少(假设各次独立)?
已看 0/5 题
练动手练习
先选一个你熟悉的风险判断场景,例如给一段公告标注“需要人工复核”与否。请在纸上写出 3 个字段、每个字段的类型和允许取值,再让任意 AI 聊天工具只按这个 Schema 输出一个 JSON。最后故意删掉一个必填字段,检查你会在程序侧怎样发现并处理这个问题。
完成这一课
读完讲义、看完自测答案,这一课就算学完了。
- 读完讲义
- 看完全部自测
本课为投资者教育内容,案例数字均为示意,不构成任何投资建议,也不承诺收益。规则和费率会变,实际操作前请以交易所、监管机构和产品的最新公告为准。