01学完你能做到
知道让模型「写代码算」和「自己改稿」的思路。
02两个问题,两种思路
前几节的方法都有两个短板:
- 会算错:模型拆题拆对了,算术却出错(第 18 讲(思维链 CoT)的「713」)。
- 一次成稿:模型生成完就交,不会像人一样回头修改。
这节讲两种对策:
- PAL:把计算交给 Python;
- Self-Refine:让模型自己挑错、自己改稿。
03PAL:程序辅助语言模型
Gao 等(2022)的 PAL(Program-Aided Language models)把工作分成两半:
- 语言模型负责理解题目,并把解题步骤写成程序;
- Python 解释器负责运行程序、算出结果。
论文的看法是:模型擅长拆解问题,却常在计算环节出错。那就让它只做擅长的部分,计算交给不会算错的解释器。
演示:瓶子题
CoT 的输出(文字推理,自己心算):
37 × 23 = 871,871 − 158 = 713。答案是 713。 ← 乘法算错PAL 的输出(few-shot 示例里展示的是「把题目写成代码」,所以模型也照样写代码):
per_box = 37        # 每箱瓶数
boxes = 23          # 箱数
given_away = 158    # 送出瓶数
total = per_box * boxes
answer = total - given_away
解释器运行后:total = 851,answer = 693。
注意变量名直接对应题目里的量,读代码就像读解题思路。即使不会编程,也能大致检查「拆题」对不对,比如乘数是不是写反了。
效果与局限
论文在 13 个数学、符号和算法推理任务上做了测试。用 Codex 的 PAL 在 GSM8K 上达到了当时 few-shot 的最好水平,比用思维链的 PaLM-540B 高了 15 个百分点(top-1 绝对值)。
局限:
- 只能解决拆题正确的问题。如果题意理解错了,代码运行得再准,结果也是错的。
- 需要一个安全的代码执行环境(沙箱),否则模型写出的代码可能带来风险。
- 今天的「代码解释器」「数据分析」功能,以及 Agent 调用计算工具(第 29 讲(工具调用 / Function Calling)),都延续了这个思路:让模型决定算什么,让工具负责算准。
- 1读懂自然语言题目提取变量和目标
- 2模型写出程序把步骤变成代码
- 3解释器运行程序得到精确结果
04Self-Refine:自己反馈、自己改
Madaan 等(2023)的 Self-Refine 模仿人修改文章的过程。同一个模型轮流扮演三个角色:
- 生成者:写初稿;
- 反馈者:按标准指出具体问题;
- 改写者:根据反馈修改。
第 2、3 步循环进行,直到反馈者认为没有问题,或者达到设定的轮数上限。
它不需要训练数据、额外训练或强化学习,只需要写三段提示词。
演示:周报摘要的三轮修改
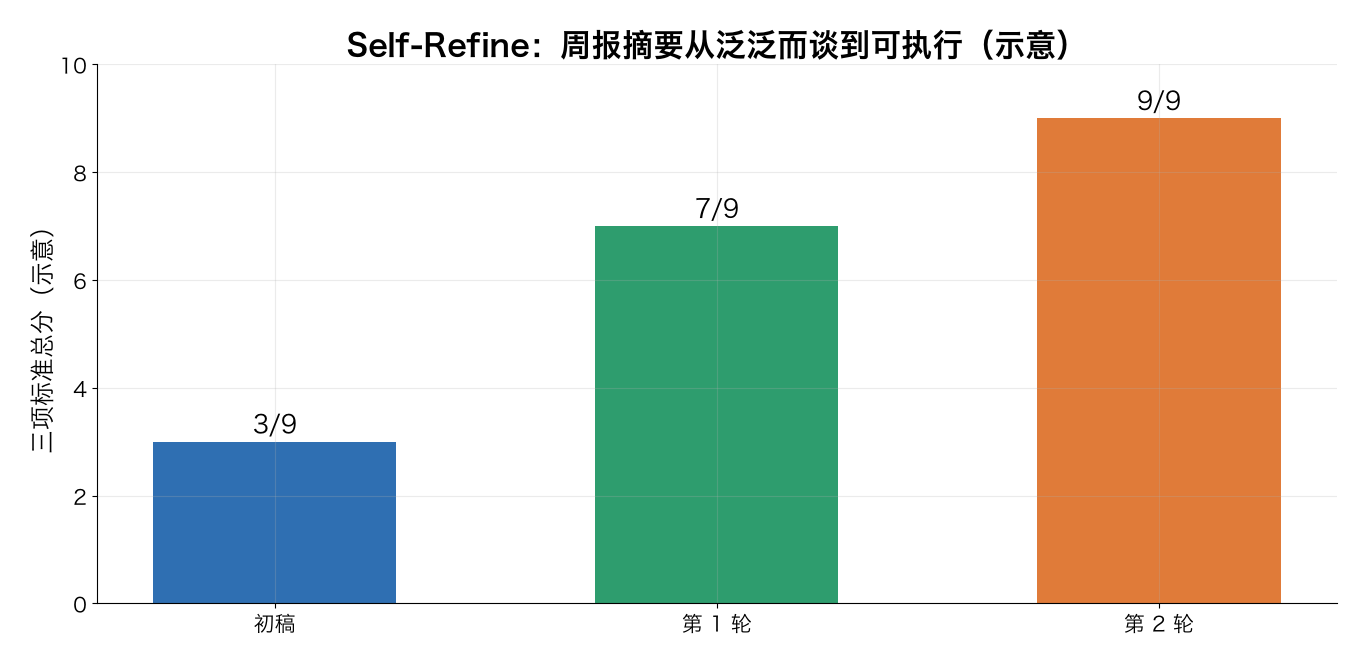
评分标准:准确、简洁、有行动建议,每项 0 到 3 分。
初稿(3/9)
本周系统整体运行良好,各方面工作有序推进,也遇到了一些问题,比如有延迟情况,团队正在积极处理,后续将继续关注相关情况,争取早日解决。
反馈 1
准确 2:「延迟」没说是哪个系统、延迟多少。简洁 1:「有序推进」「积极处理」都是套话。行动建议 0:没有写下一步谁做什么。
第 1 轮改写(7/9)
本周行情发送延迟 3 次,最长 1.2 秒,原因是网关限流。建议:运维扩容网关;研发增加监控报警。
反馈 2
简洁 2:可以先给结论。行动建议 2:没有负责人和截止日期。
第 2 轮改写(9/9)
结论:行情发送延迟需要本周处理。本周发生 3 次,最长 1.2 秒,原因是网关限流。行动:运维张三周三前完成网关扩容;研发李四周五前上线延迟报警。
反馈 3
三项都满分,停止。
(这个例子和分数是示意,不是论文数据。)
效果与局限
论文在 7 类任务上测试,从对话回复生成到数学推理,使用了 GPT-3.5、ChatGPT 和 GPT-4。在所有任务上,Self-Refine 的输出都更受人类评审和自动指标青睐,任务表现平均绝对提升约 20%。即使是 GPT-4,也能用这个方法继续改进。
局限:
- 反馈的质量决定上限。如果模型发现不了自己的错误,比如事实性错误,它会自信地说「没问题」。所以反馈标准要具体,最好能结合外部检查,比如运行代码、查资料。
- 每轮都要调用模型,成本和延迟都会增加。一定要设轮数上限。
- 可能越改越差:改着改着偏离原意或变得啰嗦。让反馈提示同时检查「是否忠实于原意」。
- 1生成初稿完成可检查版本
- 2按标准反馈指出具体问题
- 3根据反馈改写保持原意
回到第 1 步:未达标准就继续,达到上限就停止
05两种方法放在一起看
| PAL | Self-Refine | |
|---|---|---|
| 解决什么 | 计算出错 | 一次成稿质量不够 |
| 依赖什么 | 外部工具(代码解释器) | 模型自己的判断力 |
| 适合 | 数学、数据处理、需要精确计算的题 | 写作、代码、摘要等可以按标准改进的产出 |
| 最大风险 | 题意理解错 | 反馈发现不了真正的错误 |
两者还可以组合:先用 PAL 算出数字,再用 Self-Refine 打磨报告的文字。往后看,第 31 讲(先规划后执行与反思)的 Reflexion 会把「自我反思」扩展到 Agent 的多次尝试中。
06延伸阅读
07一分钟讲给别人
试着用自己的话讲一遍PAL 让模型把题目写成程序,交给 Python 解释器运行,模型只负责拆题,计算由解释器保证准确;它在 GSM8K 上比用思维链的 PaLM-540B 高 15 个百分点,前提是题意理解正确。Self-Refine 让同一个模型轮流生成、按标准给出具体反馈、根据反馈改写,循环到满意或达到轮数上限;它不需要额外训练,在 7 类任务上平均提升约 20%,但上限取决于模型能否发现自己的错误。
5 道自测
先在心里答一遍,再展开对照。能说清理由,比答对数字更重要。
01PAL 中语言模型和 Python 解释器各负责什么?
02什么情况下 PAL 也会给出错误答案?
03Self-Refine 的三个角色是什么?需要额外训练吗?
04为什么 Self-Refine 必须设轮数上限?
05「这份报告写得不够好,再改改」和「按准确、简洁、有行动建议三项逐条打分并指出问题」,哪个更适合当反馈提示?为什么?
已看 0/5 题
练动手练习
在任意 AI 聊天工具里,给一段短文本,先让它生成摘要,再要求按“准确、简洁、有行动建议”逐项反馈并改写一次。对比两版内容,检查改写是否真的纠正问题,以及是否加入了原材料没有的信息。
完成这一课
读完讲义、看完自测答案,这一课就算学完了。
- 读完讲义
- 看完全部自测
本课为投资者教育内容,案例数字均为示意,不构成任何投资建议,也不承诺收益。规则和费率会变,实际操作前请以交易所、监管机构和产品的最新公告为准。