01学完你能做到
知道什么时候给示例、给几个。
02三个名词
- Zero-shot(零样本):只给指令,不给示例。
- One-shot(单样本):给 1 个「输入 → 输出」示例。
- Few-shot(少样本):给几个示例,常见是 2 到 10 个。
这三个名词来自 GPT-3 论文(第 9 讲(预训练与规模定律)讲过),论文的题目就叫《Language Models are Few-Shot Learners》。
关键点:这三种做法都不改模型参数。模型只是在提示词里「看了几个例子」,然后照着规律回答,这叫上下文学习(in-context learning)。它和第 10 讲(指令微调 SFT 与 LoRA)讲的微调不同,微调要真的更新参数。
- Zero-shot只给指令
- One-shot给 1 个示例
- Few-shot给多个示例
03什么时候需要示例
| 情况 | 建议 |
|---|---|
| 常见任务,用一句话就能说清(翻译、摘要) | 先试 zero-shot |
| 输出格式特殊,用语言很难描述清楚 | 给示例,示例比描述更直观 |
| 标签有公司内部的定义(如「什么算高风险订单」) | 给示例,覆盖边界情况 |
| 想要特定的语气或风格 | 给 1 到 3 个风格样本 |
给几个?Anthropic 文档的建议是 3 到 5 个效果最好。文档还要求示例做到三点:
- 相关:贴近真实使用场景。
- 多样:覆盖不同情况,避免模型学到无关的规律。
- 结构清楚:用
<example>标签包起来,和指令区分开。
OpenAI 文档也建议示例尽量覆盖多样的输入。
04演示:从 zero-shot 到 few-shot
任务:把客户工单分成「账户问题 / 交易问题 / 数据问题」三类。
Zero-shot
把下面的工单分类为:账户问题、交易问题、数据问题。只输出类别。
工单:昨天的成交回报到现在还没发送过来。
模型可能输出「交易问题」,也可能输出「数据问题」。在公司内部,「回报没发送」到底算哪一类,模型并不知道。
Few-shot(3 个示例,覆盖边界)
把工单分类为:账户问题、交易问题、数据问题。只输出类别。
<example>工单:登录提示密码错误 → 账户问题</example>
<example>工单:下单被拒,提示超出风控限额 → 交易问题</example>
<example>工单:行情或回报发送延迟、缺失 → 数据问题</example>
工单:昨天的成交回报到现在还没发送过来。第三个示例专门说明了「发送延迟、缺失」属于数据问题,模型就能照着这条规则来分。示例的价值往往在于说清边界,而不只是演示格式。
05示例带来的偏差
Few-shot 很方便,但也不稳定。三篇论文指出了它的毛病。
顺序会大幅影响结果
Lu 等(2022)发现:同样几个示例,只换排列顺序,效果可能从「接近最优」掉到「接近随机猜」。他们还发现,这种现象在各种规模的模型里都存在;对一个模型好的顺序,换到另一个模型上未必好。
模型偏爱某些答案
Zhao 等(2021)发现,提示格式、示例的选择和顺序都会让准确率在「接近随机」和「接近最优」之间摆动。原因是模型对某些答案有偏好,比如:
- 偏爱提示末尾附近出现过的标签;
- 偏爱预训练数据里常见的词。
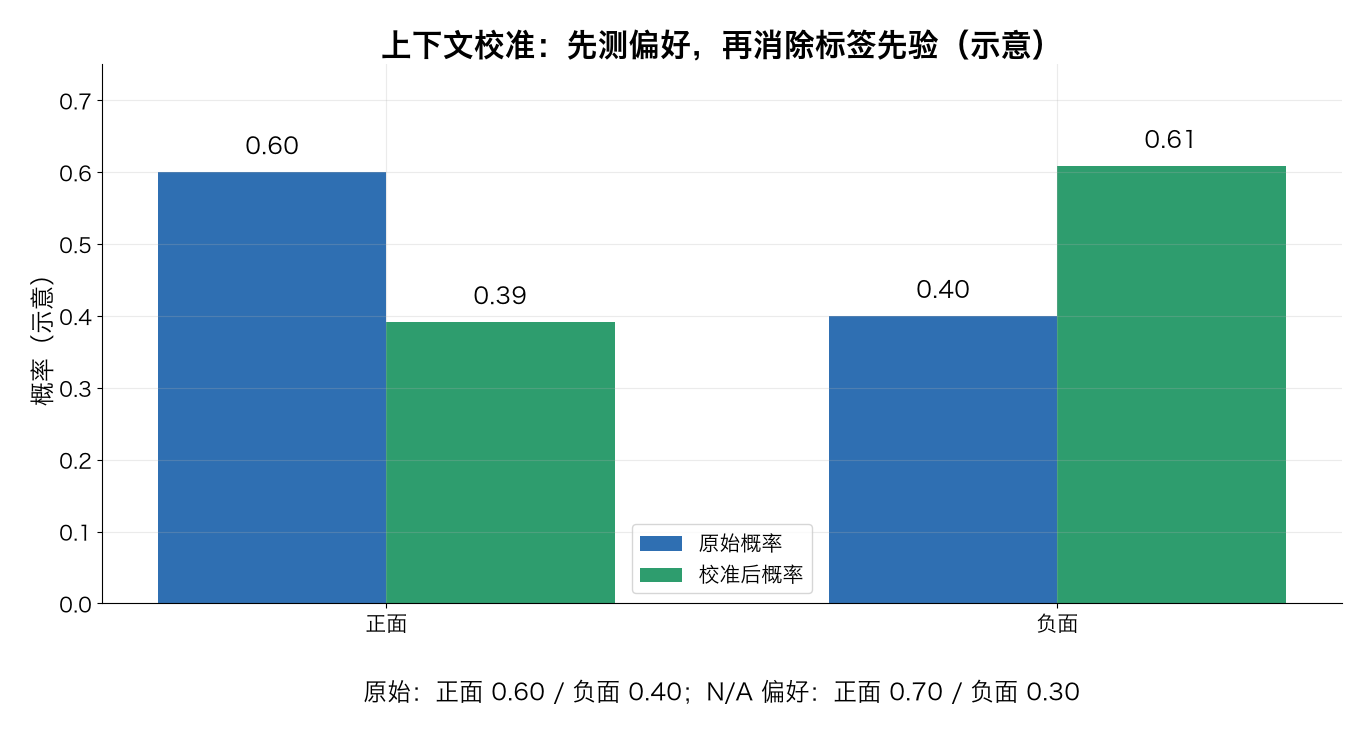
他们提出的修正办法叫上下文校准(contextual calibration)。
手算一遍(数字是示意,方法按论文):
- 把真实输入换成没有内容的「N/A」,看模型的偏见:P(正面)=0.70,P(负面)=0.30。正常情况下应该各 0.5,说明模型天生偏向「正面」。
- 输入真实评论,得到原始概率:正面 0.60,负面 0.40。不做校准的话,答案是「正面」。
- 校准:用每个概率除以对应的偏见,再归一化。
- 正面:0.60 / 0.70 = 0.857
- 负面:0.40 / 0.30 = 1.333
- 归一化:0.857 / (0.857 + 1.333) = 0.39,1.333 / 2.190 = 0.61
- 校准后答案变成「负面」。原来的「正面」主要来自模型的偏见。
论文报告,这个方法让 GPT-3 和 GPT-2 的平均准确率最多提升了 30 个百分点(绝对值),而且不同提示之间的差异也变小了。
标签对不对,没想象中重要
Min 等(2022)做了一个出人意料的实验:在分类和选择题任务中,把示例里的标签随机替换,效果几乎不下降。这个结论在 12 个模型上(包括 GPT-3)都成立。
他们认为,真正起作用的是示例提供的另外三样东西:
- 标签空间:一共有哪些可选答案;
- 输入的分布:真实输入大概长什么样;
- 整体格式:输入和输出怎么排列。
这不代表标签可以乱写。该结论来自分类和选择题实验,在需要精确规则的任务里(比如上面的工单分类边界)标签仍然重要。它说明的是:示例的很大一部分作用是「告诉模型这道题长什么样」。
06实用清单
- 先用 zero-shot 写一版,找出失败的样例,再针对这些样例补充示例。
- 示例要覆盖每个类别,数量大致平衡,避免模型偏向出现多的类别。
- 打乱示例顺序多测几次。如果结果波动很大,说明提示还不稳定。
- 用
<example>标签把示例和指令分开。 - 示例格式必须和你期望的输出完全一致,模型会照抄格式。
- 1测量空输入偏好用 N/A 得到各标签偏好
- 2得到真实输入概率保留原始结果
- 3按偏好校准除以偏好并归一化
07延伸阅读
- Brown et al., Language Models are Few-Shot Learners, 2020:arxiv.org
- Zhao et al., Calibrate Before Use: Improving Few-Shot Performance of Language Models, 2021:arxiv.org
- Lu et al., Fantastically Ordered Prompts and Where to Find Them, 2021:arxiv.org
- Min et al., Rethinking the Role of Demonstrations: What Makes In-Context Learning Work?, 2022:arxiv.org
- Anthropic, Prompting best practices:platform.claude.com
- OpenAI, Prompt engineering:platform.openai.com
- Prompt Engineering Guide 中文版:promptingguide.ai
08一分钟讲给别人
试着用自己的话讲一遍Zero-shot 只给指令,few-shot 在提示里放几个示例,两者都不改模型参数,属于上下文学习。示例最适合用来说明格式、风格和边界,Anthropic 建议给 3 到 5 个,并且要相关、多样、用标签隔开。Few-shot 不稳定:示例顺序可能让效果从接近最优掉到接近随机;模型偏爱末尾出现过的标签和常见词,可以用「N/A」测出偏见再做校准。示例的作用很大一部分在于展示标签空间、输入分布和格式。
5 道自测
先在心里答一遍,再展开对照。能说清理由,比答对数字更重要。
01Few-shot 和微调的根本区别是什么?
02用「N/A」测得 P(是)=0.8、P(否)=0.2;某个输入的原始概率是 P(是)=0.7、P(否)=0.3。校准后答案是什么?
03Min 等人的实验说明了什么?能不能因此随便写示例标签?
04为什么要打乱示例顺序测试?
05什么情况下优先考虑 few-shot?
已看 0/5 题
练动手练习
准备 5 条虚构的客户工单和“账户、交易、数据”三个类别,先不用示例让 AI 分类。再给它 3 条覆盖边界的示例,交换示例顺序后各测一次,比较 few-shot 是否稳定以及示例究竟说明了什么。
完成这一课
读完讲义、看完自测答案,这一课就算学完了。
- 读完讲义
- 看完全部自测
本课为投资者教育内容,案例数字均为示意,不构成任何投资建议,也不承诺收益。规则和费率会变,实际操作前请以交易所、监管机构和产品的最新公告为准。