01学完你能做到
知道多次采样和搜索怎么提升推理。
02问题:一条推理链容易「一错到底」
第 18 讲(思维链 CoT)的思维链只走一条推理路径,通常用贪心解码(每步取概率最高的 token,第 14 讲(解码与采样)讲过)。只要中间某一步出错,后面就全错了,而且没有机会回头。
这节讲两种改进思路:
- 自洽性:多走几条路,最后投票;
- 思维树:边走边评估,走不通就回头。
03自洽性(Self-Consistency)
Wang 等(2022)提出的方法分三步:
- 用思维链提示,把 temperature 调到大于 0,对同一道题采样多条不同的推理路径;
- 从每条路径里取出最终答案;
- 多数投票:出现次数最多的答案就是最终答案。
背后的直觉是:一道复杂题往往有多种正确解法,它们会殊途同归到同一个正确答案;而错误的推理各错各的,答案很分散。
演示:五条路径投票
还是第 18 讲(思维链 CoT)的瓶子题(正确答案 693):
| 路径 | 推理 | 答案 |
|---|---|---|
| 1 | 37×23=851,851−158=693 | 693 |
| 2 | 23×37=851,减 158 得 693 | 693 |
| 3 | 37×23 算成 871,871−158=713 | 713 |
| 4 | 先算 37×20=740,37×3=111,合计 851,再减 158 | 693 |
| 5 | 851−158 算成 683 | 683 |
计票:693 得 3 票,713 得 1 票,683 得 1 票,所以输出 693。单看任意一条路径,有 40% 的可能答错,但投票后答对了。
为什么条数越多越准
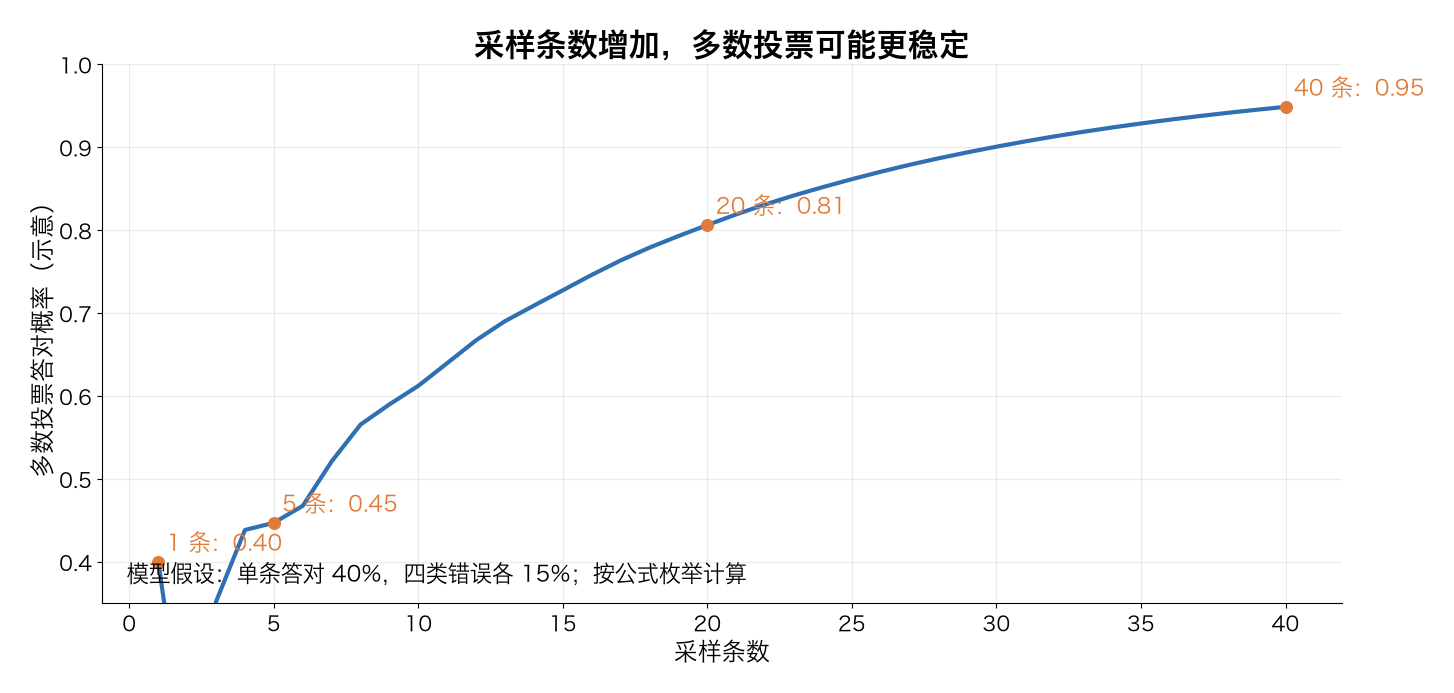
下面用一个模拟说明。假设单条路径只有 40% 的概率答对,其余 60% 平均分到 4 个不同的错误答案上(各 15%):
- 采样 1 条:答对概率约 0.39(理论值 0.40,误差来自随机模拟)
- 采样 5 条:约 0.55
- 采样 20 条:约 0.85
- 采样 40 条:约 0.96
即使单条路径不到一半的概率答对,只要正确答案比任何一个错误答案都更常出现,投票就会越来越准。反过来,如果模型总是犯同一种错误,错误答案比正确答案出现得多,投票就会越投越错。
论文结果(摘要):自洽性让思维链在多个基准上大幅提升,包括 GSM8K +17.9%、SVAMP +11.0%、AQuA +12.2%、StrategyQA +6.4%、ARC-challenge +3.9%。
局限:
- 成本随采样条数成倍增长;
- 需要能比对的答案(数字、选项)。开放式写作没法直接投票。
- 1同题多次采样temperature 大于 0
- 2抽取最终答案每条路径取一个答案
- 3多数投票出现最多的答案胜出
04思维树(Tree of Thoughts,ToT)
Yao 等(2023)指出,语言模型逐个 token 从左到右生成,就像下棋时每一步都不考虑后面几步。遇到需要探索、前瞻、回溯的任务就不行了。
思维树把解题过程变成一棵树:
- 想法(thought):一段有意义的中间步骤,比如 24 点里的一个算式;
- 生成:在每个节点让模型提出几个候选的下一步;
- 评估:让模型自己判断每个候选能不能凑成 24,分「sure(确定能)/ maybe(可能)/ impossible(不可能)」三档;论文对每个候选评估 3 次;
- 搜索:用广度优先或深度优先的方法往下走,走不通就回溯。论文在 24 点上用广度优先,每层保留最好的 5 个候选。
演示:24 点(4 9 10 13)
规则:用 4 个数各一次,通过加减乘除得到 24。
- 第一层,生成候选:
- 13 − 9 = 4,剩 4 4 10
- 4 + 9 = 13,剩 10 13 13
- 10 − 4 = 6,剩 6 9 13
- 评估:模型判断「10 13 13」不可能凑出 24,剪掉这个分支;另外两个「可能」,保留。(这两个旁支是示意;论文给出的解题路径就是下面这条主线。穷举结果显示:10 13 13 确实无解;6 9 13 有解,如 6 × (13 − 9) = 24,所以保留它是对的。)
- 第二层:在「4 4 10」下面试 10 − 4 = 6,剩 4 6。
- 第三层:4 × 6 = 24,成功。
完整算式:(13 − 9) × (10 − 4) = 24。
如果某个分支走到底也凑不出来,就退回上一层,换另一个保留的分支继续。普通思维链只能一路走下去,没有这个「退回」的机会。
论文结果:在 24 点上,GPT-4 用思维链只解出 4% 的题,用思维树解出了 74%。测试题是按人类解题耗时排序后较难的第 901–1000 题,共 100 道。思维链加自洽性(100 条取多数)也只有 9%,说明光「多走几条路」不够,关键在每一步的评估和回溯。
局限:每一步都要多次调用模型来生成和评估,调用次数远多于普通 CoT,成本高、速度慢。适合的场景是那些需要搜索的难题,比如规划、谜题、需要试错的设计。
- 1生成候选提出多个下一步
- 2评估可行性sure / maybe / impossible
- 3剪枝保留丢掉不可能分支
- 4继续或回溯走不通就换路
回到第 1 步:还有候选就继续,走不通就回溯
05三种方法对比
| 思维链 CoT | 自洽性 SC | 思维树 ToT | |
|---|---|---|---|
| 结构 | 一条链 | 多条独立的链 | 一棵树 |
| 什么时候选答案 | 走到底 | 全部走完后投票 | 每一步都评估、剪枝 |
| 能回溯吗 | 不能 | 不能 | 能 |
| 调用次数 | 1 次 | N 次 | 很多次 |
| 适合 | 一般推理 | 有标准答案的题 | 需要搜索和规划的难题 |
和第 13 讲(推理模型)的联系:推理模型在内部也会自我检查、换思路,可以理解为把类似「多路径、回头检查」的行为通过强化学习训练进了模型里,不再需要外部的程序来编排。
06延伸阅读
07一分钟讲给别人
试着用自己的话讲一遍单条思维链一步错就步步错。自洽性对同一题采样多条推理路径,再对答案多数投票;正确解法容易殊途同归,错误答案却很分散,所以投票能提高准确率,GSM8K 上提升了 17.9 个百分点,代价是调用次数成倍增加。思维树把推理变成一棵树,每步生成几个候选,让模型评估、剪枝,走不通就回溯,24 点任务上从 4% 提到 74%,但调用次数更多。
5 道自测
先在心里答一遍,再展开对照。能说清理由,比答对数字更重要。
01自洽性为什么要把 temperature 调到大于 0?
02五条路径的答案是 12、15、12、18、12,最终输出什么?
03什么情况下多数投票反而会越投越错?
04思维树比思维链多了哪三个能力?
05一道开放式写作题适合用自洽性吗?为什么?
已看 0/5 题
练动手练习
在任意 AI 聊天工具里,用同一道有明确答案的题采样 5 次,记录每条路径的最终答案并投票。再挑一道容易让模型犯同一种错误的题,比较多数投票何时有效、何时会放大系统性错误。
完成这一课
读完讲义、看完自测答案,这一课就算学完了。
- 读完讲义
- 看完全部自测
本课为投资者教育内容,案例数字均为示意,不构成任何投资建议,也不承诺收益。规则和费率会变,实际操作前请以交易所、监管机构和产品的最新公告为准。