01学完你能做到
理解从「写一句提示」到「管理整个上下文」的转变。
02从提示词到上下文
第 16–21 讲讲的是提示词工程:怎么把一段指令写好。
但在真实的 AI 应用里,尤其是 Agent(第 28 讲(什么是 Agent)起),模型每一步看到的远不止一句指令。它的上下文窗口里塞着:
- 系统提示(角色、规则);
- 工具说明(第 29 讲(工具调用 / Function Calling));
- 历史对话;
- 检索来的资料(第 24 讲(RAG 原理));
- 记忆和笔记(第 26 讲(记忆));
- 上一步工具调用返回的结果。
上下文工程(context engineering)关心的问题是:在每一步,窗口里该放哪些信息、放多少、按什么顺序放。
Anthropic 的工程文章给出的核心原则是:找到尽可能小、信息密度尽可能高的一组 token,让期望结果出现的可能性最大。
LangChain 的文章引用了 Andrej Karpathy 的比喻:大模型像一种新的操作系统,模型是 CPU,上下文窗口是内存(RAM),也就是模型的「工作记忆」。内存容量有限,所以要管理好装进去的东西。
- 提示词工程写清一段指令
- 上下文工程管理整个窗口
03为什么上下文是「有限资源」
很多模型的窗口已经有几十万甚至上百万 token,为什么还要省着用?
Anthropic 的文章给了两个理由。
理由一:上下文腐化。 窗口里的 token 越多,模型从中准确找回信息的能力越差。这种现象在所有模型上都存在,只是有的下降得平缓些。第 23 讲(上下文窗口与上下文腐化)会详细讲。
理由二:注意力预算。 文章说,大模型和人一样有「注意力预算」,每多一个 token 就消耗一点。原因来自架构:第 7 讲(注意力机制)讲过,Transformer 里每个 token 都要和其他所有 token 计算关系,n 个 token 就有 n² 对关系。
算一下:
- 1 千个 token:10³ × 10³ = 10⁶,一百万对关系;
- 1 万个 token:10⁸,一亿对;
- 10 万个 token:10¹⁰,一百亿对。
token 每多 10 倍,两两关系就多 100 倍。窗口越长,注意力就越被「摊薄」。文章还提到,模型在训练时见过的短文本远多于长文本,所以它对超长距离关系的经验也更少。
结论:上下文不是越多越好,而是边际收益递减。多放一段无关资料不是「免费」的,它会稀释真正重要的信息。
04四类策略
LangChain 的文章把上下文工程的常见做法归为四类:写入、选择、压缩、隔离。
| 策略 | 意思 | 例子 | 后面在哪节细讲 |
|---|---|---|---|
| 写入 Write | 把信息存到窗口外面,留着以后用 | 草稿本(scratchpad)、跨会话的长期记忆 | 第 26 讲(记忆) |
| 选择 Select | 需要时把相关信息取回窗口 | 检索资料、调出相关记忆、只挑相关的工具说明 | 第 24、25 讲 |
| 压缩 Compress | 只保留要点 | 把长对话总结成摘要、裁掉旧的工具结果 | 第 27 讲(压缩与隔离) |
| 隔离 Isolate | 把不同任务的上下文分开 | 子智能体各用各的窗口、在沙箱里运行代码 | 第 27、32 讲 |
- 写入存到窗口外
- 选择按需取回
- 压缩只留要点
- 隔离分开任务
05演示:给一个 Agent 记一笔上下文账
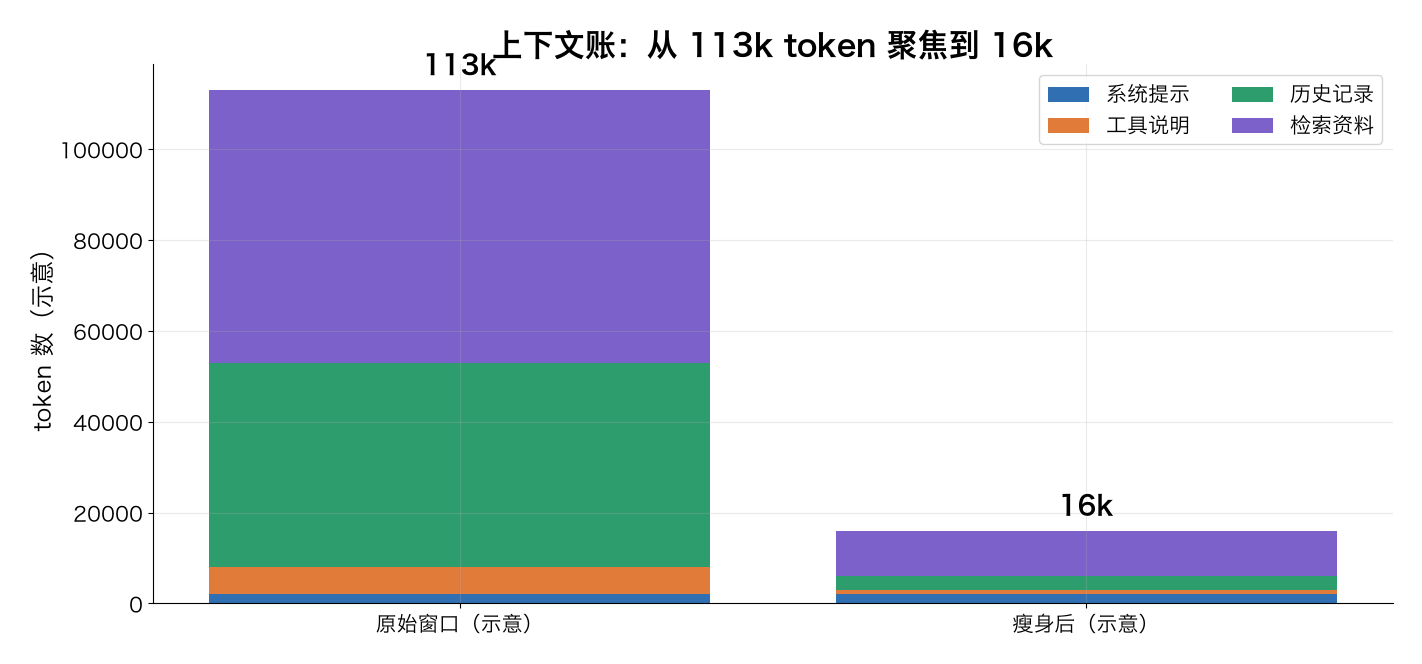
假设一个「研报助手」Agent,模型窗口是 128k token。第 15 步时,窗口里有:
| 内容 | token 数 |
|---|---|
| 系统提示 | 2,000 |
| 20 个工具的说明 | 6,000 |
| 前 14 步的完整对话和工具调用记录 | 45,000 |
| 检索到的 30 段研报全文 | 60,000 |
| 合计 | 113,000 |
(数字是示意。)
已经用掉 113k / 128k ≈ 88%,而且大部分是过时或低相关的内容。按四类策略逐项「瘦身」:
- 选择:这一步只需要用到 3 个工具,只放这 3 个的说明:6,000 → 约 1,000。
- 选择:30 段资料里只取与当前问题最相关的 5 段:60,000 → 约 10,000。
- 压缩:前 14 步的记录总结成一份「进展摘要」:45,000 → 约 3,000。
- 写入:完整的原始记录写进文件,需要时再读取,不占窗口。
瘦身后:2,000 + 1,000 + 10,000 + 3,000 = 16,000 token,只有原来的约 14%。剩下的都是和当前这一步最相关的信息。
06预先加载,还是「即用即取」
Anthropic 的文章还对比了两种获取信息的方式:
- 预先加载:一开始就把可能相关的资料检索好、全部放进窗口(传统 RAG 的做法);
- 即用即取(just in time):只在窗口里放轻量的「指针」,比如文件路径、存好的查询、网页链接,Agent 需要时用工具把内容读进来。
文章举的例子是 Claude Code。它采用混合策略:项目说明文件(CLAUDE.md)一开始就放进上下文,其他文件则让 Agent 用 glob、grep 这类搜索工具按需查找、读取。
文章也提醒:即用即取更慢,而且 Agent 如果不会用工具,可能会走弯路、浪费上下文。对于内容不常变化的场景(文章举了法律、金融),混合策略可能更合适。第 25 讲(RAG 进阶与常见失败)讲 Agentic RAG 时还会用到这个思路。
07延伸阅读
- Anthropic, Effective context engineering for AI agents:anthropic.com
- LangChain, Context Engineering(for agents):langchain.com
08一分钟讲给别人
试着用自己的话讲一遍上下文工程关心的是:每一步窗口里放什么、放多少。原则是找到尽可能小、信息密度尽可能高的一组 token。上下文是有限资源:token 越多,模型越难准确找回信息;n 个 token 有 n² 对关系,注意力会被摊薄,边际收益递减。常用策略分四类:写入(存到窗口外)、选择(按需取回)、压缩(只留要点)、隔离(分开放)。获取信息有两种方式:预先加载和即用即取,也可以两者混合。
5 道自测
先在心里答一遍,再展开对照。能说清理由,比答对数字更重要。
01提示词工程和上下文工程关注点有什么不同?
02上下文从 2 万 token 增加到 20 万 token,两两关系数增加多少倍?
03把「前 30 轮对话总结成 500 字摘要」属于四类策略中的哪一类?把「用户偏好存进数据库」呢?
04什么是「即用即取」?它的风险是什么?
05窗口还没满,为什么也不该把所有资料都放进去?
已看 0/5 题
练动手练习
找一个你熟悉的任务,例如让 AI 根据一份研报回答问题。把系统规则、全部资料、历史对话一次性堆在一起,再做一版:只留下当前问题最相关的资料,并把其余内容改成文件名或要点,比较两版的回答和成本感受。
完成这一课
读完讲义、看完自测答案,这一课就算学完了。
- 读完讲义
- 看完全部自测
本课为投资者教育内容,案例数字均为示意,不构成任何投资建议,也不承诺收益。规则和费率会变,实际操作前请以交易所、监管机构和产品的最新公告为准。