01学完你能做到
区分短期记忆和长期记忆,看懂「会话历史 / 摘要记忆 / 外部记忆」三种做法,理解 MemGPT 的「分页」思路。
02模型本身不记得你
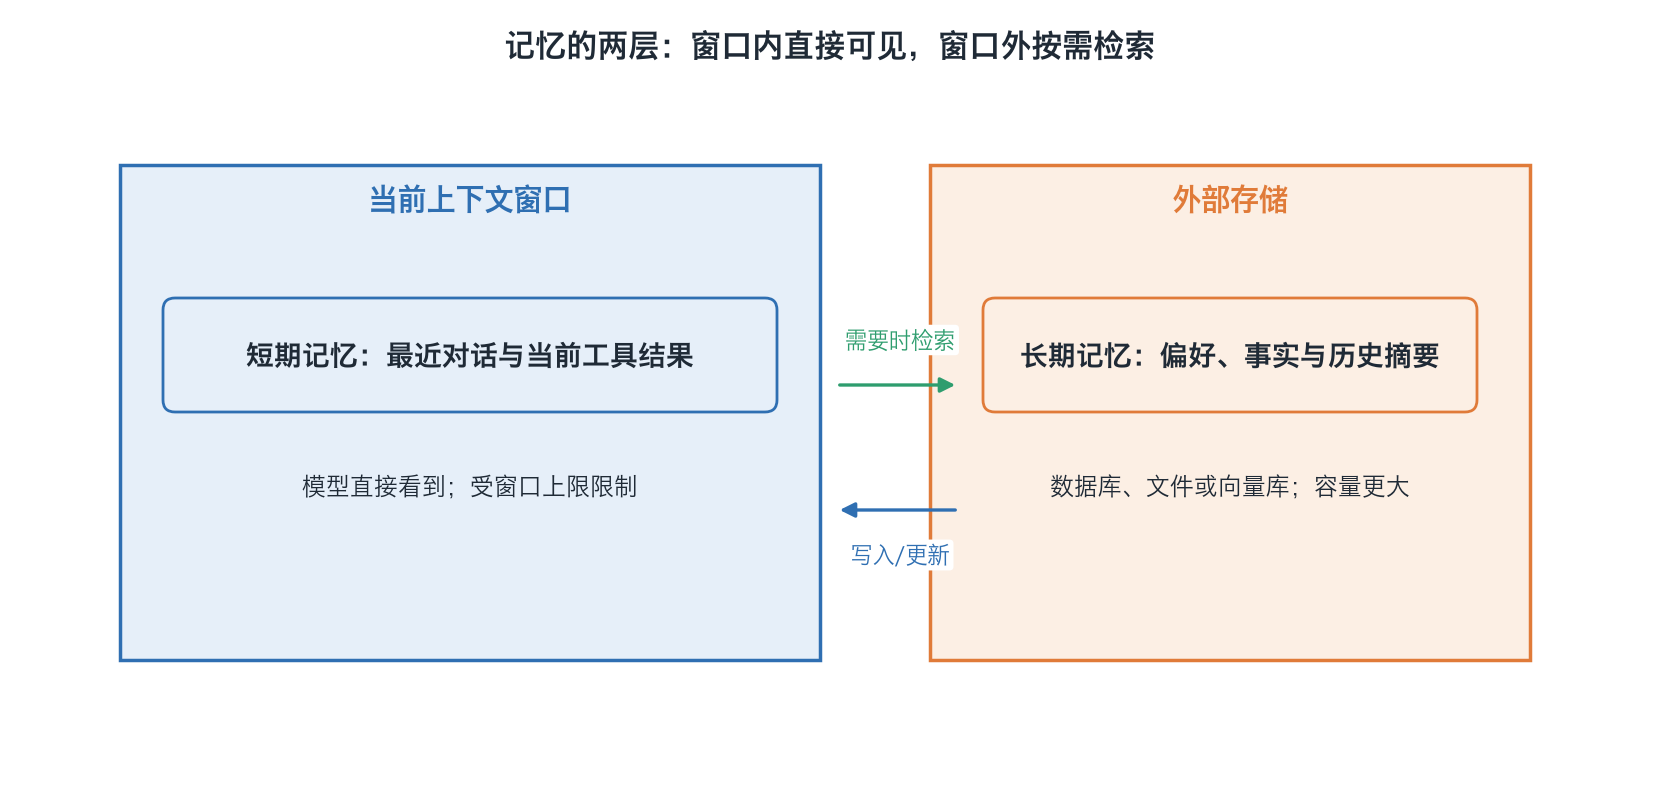
大模型的参数在训练完就固定了。你今天和它聊了什么,它不会写回参数里。下一次调用时,它「记得」的东西只有一个来源:这次请求里塞进窗口的文字。
所以 Agent 的「记忆」其实是一套管理窗口内容的工程:哪些放进窗口,哪些存到外面,什么时候取回来。第 22 讲(什么是上下文工程)把上下文工程的做法分成写入、选择、压缩、隔离四类,本节讲的就是其中的写入(存到窗口外),以及配套的选择(取回来)。
| 短期记忆 | 长期记忆 | |
|---|---|---|
| 放在哪 | 当前窗口里 | 窗口外:数据库、文件、向量库 |
| 用法 | 模型直接看得到 | 先检索、再放进窗口才能用 |
| 容量 | 受窗口上限限制 | 通常比窗口大得多,但受存储容量和检索设计限制 |
| 寿命 | 通常这次会话结束就没了 | 可以跨会话、跨天 |
| 例子 | 最近几轮对话、刚拿到的工具结果 | 用户偏好、过往订单、历史对话的摘要 |
Lilian Weng 在她的 Agent 综述里也这样划分:短期记忆就是上下文里的内容(in-context learning),长期记忆一般靠外部向量库加快速检索来实现。
03三种常见做法
① 会话历史(原样保留):把之前所有对话原样带上。最简单,也最忠实。缺点是越聊越长:成本上涨,还会出现第 23 讲(上下文窗口与上下文腐化)讲的上下文腐化,最后装不下。
② 摘要记忆(压成要点):旧对话交给模型总结成一段摘要,只带「摘要 + 最近几轮完整对话」。省空间,代价是有损,细节会丢。
③ 外部记忆(存出去,用时取):把事实、历史写进数据库或向量库,需要时按问题检索取回(检索的原理见第 24 讲(RAG 原理))。容量大,但取回取错就等于没记住。
实际产品通常三种一起用:最近的完整对话 + 较早的摘要 + 外部可检索的完整历史。
演示:一个「投研助手」第 30 轮对话时窗口里放什么(示意)
| 内容 | 来源 | 大约 token |
|---|---|---|
| 系统提示 + 工具说明 | 固定 | 3,000 |
| 用户画像:「关注新能源;不看 ST 股;报告要中文表格」 | 外部记忆,开场检索取回 | 200 |
| 第 1–25 轮的摘要 | 摘要记忆 | 800 |
| 第 26–30 轮完整对话 | 会话历史 | 4,000 |
| 合计 | 8,000 |
如果 30 轮完整对话全带上,按每轮 800 token 算是 24,000 token,再加系统提示 3,000,合计 27,000。用上面的组合约 8,000,省了约 70%。代价是第 1–25 轮的细节只剩摘要。(数字是示意。)
04MemGPT:把窗口当「内存」,把外部存储当「磁盘」
电脑内存小、硬盘大。操作系统的办法是分页:暂时不用的数据换到硬盘,要用时再换回内存,程序感觉自己有一块「很大的内存」。
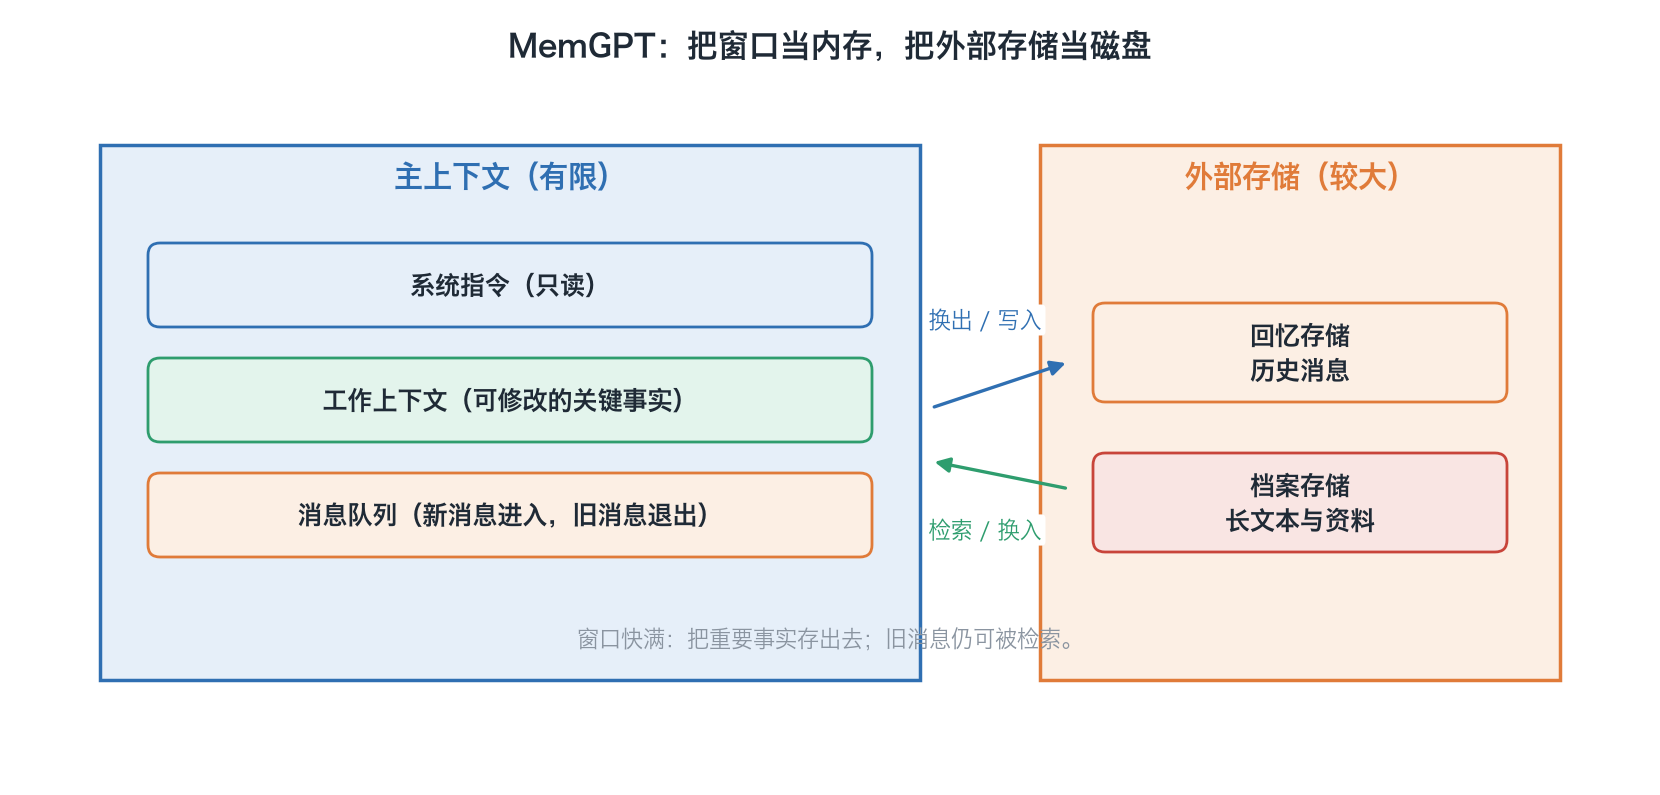
MemGPT(Packer 等,2023)把这个思路搬到 LLM 上,叫虚拟上下文管理:
- 主上下文(相当于内存,就是模型窗口),分三块:
- 系统指令:只读;
- 工作上下文:固定大小,存关键事实(比如用户的名字、偏好),只能由模型调用函数来改写;
- FIFO 消息队列:最近的对话,先进先出。队首放的是被挤出去的旧消息的递归摘要。
- 外部上下文(相当于磁盘):
- 回忆存储:全部历史消息的数据库,可以搜;
- 档案存储:存任意长度的文本,用向量检索。
关键在于:换入、换出由模型自己用函数调用来做。
演示:MemGPT 遇到「内存压力」时的一串动作
论文给的阈值是举例,这里照着走一遍:
- 对话越来越长,窗口用到约 70%(警告线)。系统往队列里塞一条「内存压力」提醒。
- 模型看到提醒,调用函数,把重要信息写进工作上下文或档案存储。例如:「用户下周三要去杭州出差」。
- 窗口到 100%(清空线)。系统把一部分旧消息挤出队列(论文举例是窗口的 50%),并生成新的递归摘要放在队首。
- 被挤出的完整消息没有删除,还在回忆存储里。
- 几天后用户问「我上次说哪天出差来着?」。模型调用搜索函数查回忆存储,取回原话再回答。
另外,模型可以在函数调用里设 request_heartbeat=true,意思是「执行完再叫我一次」。这样它就能连续调用多个函数,比如先搜、再翻页、再回答。
效果:论文的「深度记忆检索」任务要求回答很早以前会话里的细节。对照组只拿到过往会话的有损摘要。准确率:
| 模型 | 对照组 | 加 MemGPT |
|---|---|---|
| GPT-3.5 Turbo | 38.7% | 66.9% |
| GPT-4 | 32.1% | 92.5% |
| GPT-4 Turbo | 35.3% | 93.4% |
05Generative Agents:记忆流 + 打分检索 + 反思
Park 等(2023)在一个叫 Smallville 的小镇里放了 25 个由 LLM 驱动的居民。每个居民有一条记忆流:用自然语言记下自己经历的每件事。
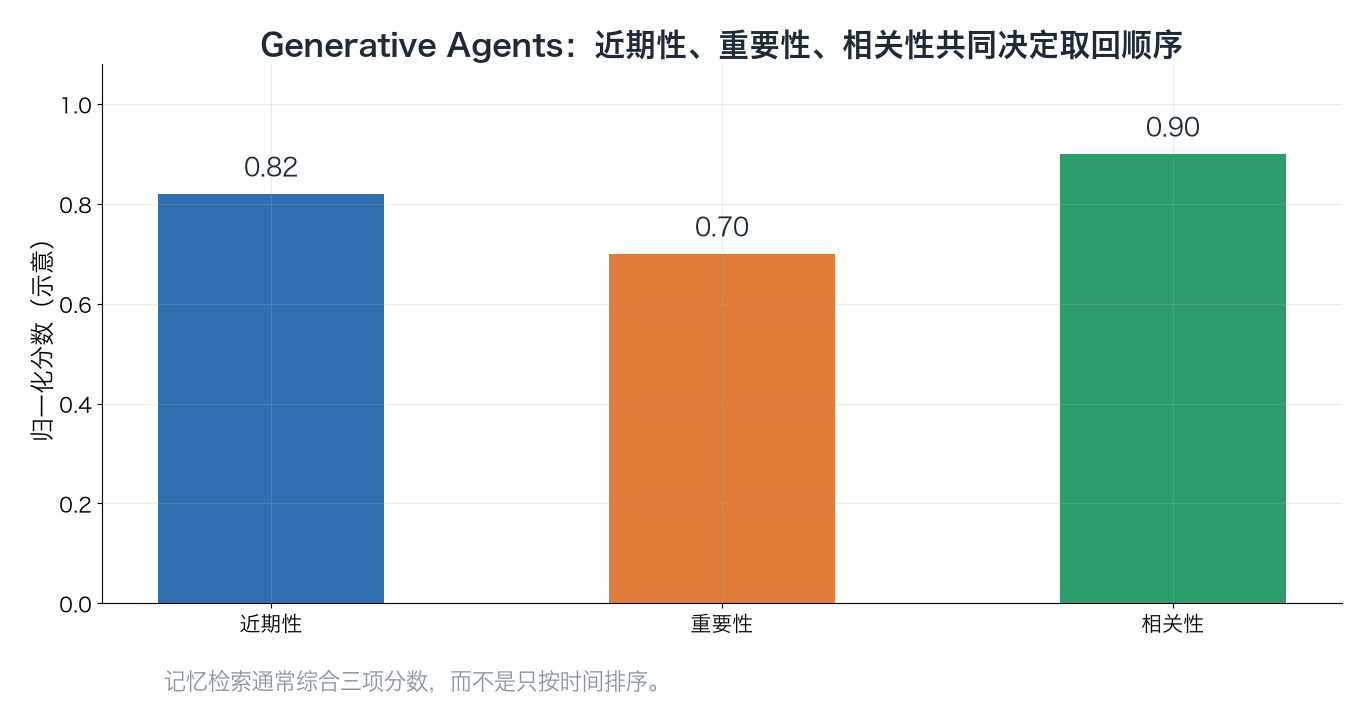
需要回忆时,不是全部塞进窗口,而是给每条记忆打三项分,加起来取最高的几条:
- 近期性:越久没被想起,分越低,每过一个游戏小时乘以 0.995;
- 重要性:让 LLM 打 1–10 分,论文的例子是打扫房间 2 分、约暗恋对象出去 8 分;
- 相关性:记忆和当前问题的嵌入向量的余弦相似度。
三项先各自缩放到 0–1,再相加(论文里权重都取 1)。
演示:手算一次检索(数字为示意)
问题:「这周有什么要紧事?」三条记忆:
| 记忆 | 距上次想起 | 近期性 0.995\^小时 | 重要性 | 相关性 |
|---|---|---|---|---|
| A 早餐吃了面包 | 1 小时 | 0.995 | 2 | 0.2 |
| B 答应周五交季度报告 | 30 小时 | 0.860 | 8 | 0.9 |
| C 同事推荐了一家咖啡店 | 5 小时 | 0.975 | 3 | 0.4 |
第一步,每列缩放到 0–1(最小记 0,最大记 1):
- 近期性:A = 1,B = 0,C = (0.975 − 0.860) / (0.995 − 0.860) ≈ 0.85
- 重要性:A = 0,B = 1,C = (3 − 2) / (8 − 2) ≈ 0.17
- 相关性:A = 0,B = 1,C = (0.4 − 0.2) / (0.9 − 0.2) ≈ 0.29
第二步,相加:A = 1.00,B = 2.00,C ≈ 1.30。
B 最先被取回。它虽然是 30 小时前的事,但又重要又相关。
反思:最近事件的重要性分数加起来超过 150 时(论文说大约一天两三次),居民会停下来「反思」。它先从最近 100 条记忆里提出 3 个最值得想的问题,再归纳出带引用的高层结论(比如「我很投入这项研究」),写回记忆流。这些结论之后也能被检索到。
消融实验(人工评分排名,TrueSkill μ 值):完整版 29.89 > 去掉反思 26.88 > 去掉反思和计划 25.64 > 人工扮演 22.95 > 去掉记忆 21.21。没有记忆的版本排最后。
论文也列了失败:该想起的没检索到;回忆时添油加醋;说话过于正式。
06设计记忆功能要回答的四个问题
- 记什么:偏好、事实、待办,还是全部对话?
- 何时写:每轮都写、由模型判断写,还是到压力线再写?
- 何时取:每次开场都取,还是让模型按需搜?
- 怎么改和删:用户说「我不再关注新能源了」,旧记忆要能被覆盖。用户要求删除时要能真删。
还要注意:外部记忆里存进了不可信内容,以后会被当成事实取回。这和第 39 讲(提示注入)的提示注入有关。
07延伸阅读
- Packer et al., MemGPT: Towards LLMs as Operating Systems, 2023:arxiv.org
- Park et al., Generative Agents: Interactive Simulacra of Human Behavior, 2023:arxiv.org
- Lilian Weng, LLM Powered Autonomous Agents, 2023:lilianweng.github.io
08一分钟讲给别人
试着用自己的话讲一遍模型参数不会记住对话,所谓记忆就是管理窗口里放什么。短期记忆在窗口内,直接可见但容量有限;长期记忆在窗口外,容量大但要先检索。常见做法有三种:会话历史原样保留、摘要记忆压成要点、外部记忆按需检索,通常组合使用。MemGPT 借用操作系统分页:窗口是内存,回忆存储和档案存储是磁盘,由模型调用函数自己换入换出。快满时系统先发压力提醒,满了再挤出旧消息并生成递归摘要。Generative Agents 用近期性 + 重要性 + 相关性给记忆打分来检索,并定期反思出高层结论。
6 道自测
先在心里答一遍,再展开对照。能说清理由,比答对数字更重要。
01短期记忆和长期记忆各放在哪?各自的主要缺点是什么?
02摘要记忆为什么叫「有损」?
03MemGPT 里,窗口到 70% 和到 100% 时分别发生什么?
04用本节的打分法,如果把 C 的重要性改成 8,C 的总分是多少?会超过 B 吗?
05MemGPT 里被挤出窗口的消息去哪了,还能找回吗?
06为什么记忆功能需要「覆盖」和「删除」?
已看 0/6 题
练动手练习
在纸上把一段 10 轮对话分成三层:最近几轮保留完整对话、较早内容压成摘要、需要跨会话复用的事实存到外部记忆。然后给出一个问题,标记它应该从哪一层取回,并说明如果取错会发生什么。
完成这一课
读完讲义、看完自测答案,这一课就算学完了。
- 读完讲义
- 看完全部自测
本课为投资者教育内容,案例数字均为示意,不构成任何投资建议,也不承诺收益。规则和费率会变,实际操作前请以交易所、监管机构和产品的最新公告为准。