01学完你能做到
知道 RAG 为什么会「答非所问」。
02先诊断:是没找到,还是没用好
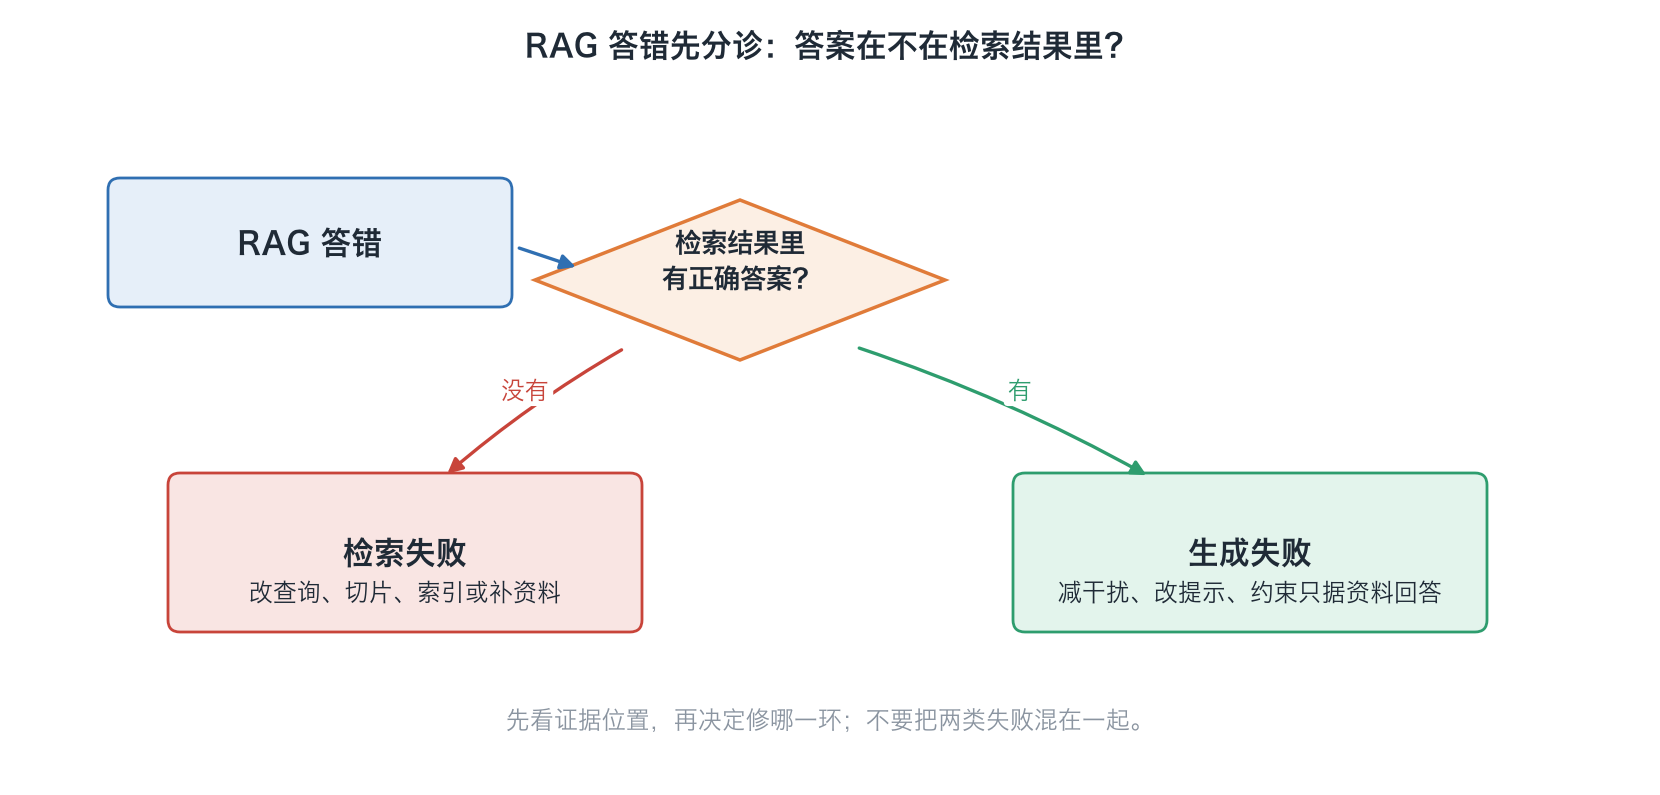
RAG 答错时,第一件事是判断错在哪一环。可以看检索出来的那几段资料,并按下面的诊断树一步步判断。
第一问:检索结果里有正确答案吗?
- 没有 → 检索失败。可能的原因:
- 资料库里根本没有这份资料(知识缺失);
- 用户的问法和文档的写法差别太大,比如用户说「钱怎么转出来」,文档写的是「提现」;
- 切片把关键信息切断了;
- 问题需要多份资料拼起来才能回答,一次检索取不全。
- 有 → 继续问第二个问题。
第二问:资料里有答案,模型为什么没答对? 这是生成失败。可能的原因:
- 答案埋在一大堆资料的中间,被忽略了(第 23 讲(上下文窗口与上下文腐化)的 Lost in the Middle);
- 干扰项太多,模型选错了段落;
- 模型不信资料,用自己的「记忆」回答(第 15 讲(幻觉)的幻觉);
- 提示词没有要求「只根据资料回答」。
为什么要先分清? 因为两种失败的修法完全不同。检索失败时,不能只改提示词;生成失败时,也不能只换嵌入模型。
在产品上,可以给每条错误样本打上「检索失败 / 生成失败」的标签,统计哪一类更多,再决定优先修哪一环(第 38 讲(评测)讲评测)。
03修检索的常用方法
查询改写
用户的原始问题往往口语化、不完整,也可能依赖上下文(例如「那它的手续费呢?」)。可以先让模型把问题改写成更适合检索的形式,再去检索。
Ma 等(2023)把这套流程叫 Rewrite-Retrieve-Read:先改写,再检索,再阅读回答。
演示(示意):
| 内容 | |
|---|---|
| 改写前 | 「那它的手续费呢?」 |
| 改写后 | 「某 App 提现到银行卡的手续费标准」(补全了指代,也换成了文档里的说法) |
HyDE:先编一个答案,再拿它去检索
问题和答案的写法往往不一样:问题短,还带问号;答案是一段陈述。HyDE(Gao 等,2022)的做法是:
- 先让模型写一段假想的答案文档(内容可能不准确,没关系);
- 把这段假想文档变成向量;
- 用这个向量去找真实的文档。
因为假想答案的「写法」更像真实答案,所以更容易找到对的段落。论文摘要提到,编码器会过滤掉假想文档中错误的细节。
混合检索 + 重排
第 24 讲(RAG 原理)讲过向量检索和关键词检索的混合。还可以再加一步重排(rerank):先粗取比如 100 段,再用更精细(也更慢)的模型给每一段和问题的相关度打分,只留最好的几段。
上下文检索(Contextual Retrieval)
切片的一个老问题是:单独一段话丢失了它的背景。例如「本季度营收增长 3%」,单看这句,不知道是哪家公司、哪个季度。
Anthropic 2024 年提出的做法是:建索引时,让模型给每一段生成 50–100 token 的背景说明,加在这一段前面,然后再做向量化和关键词索引。
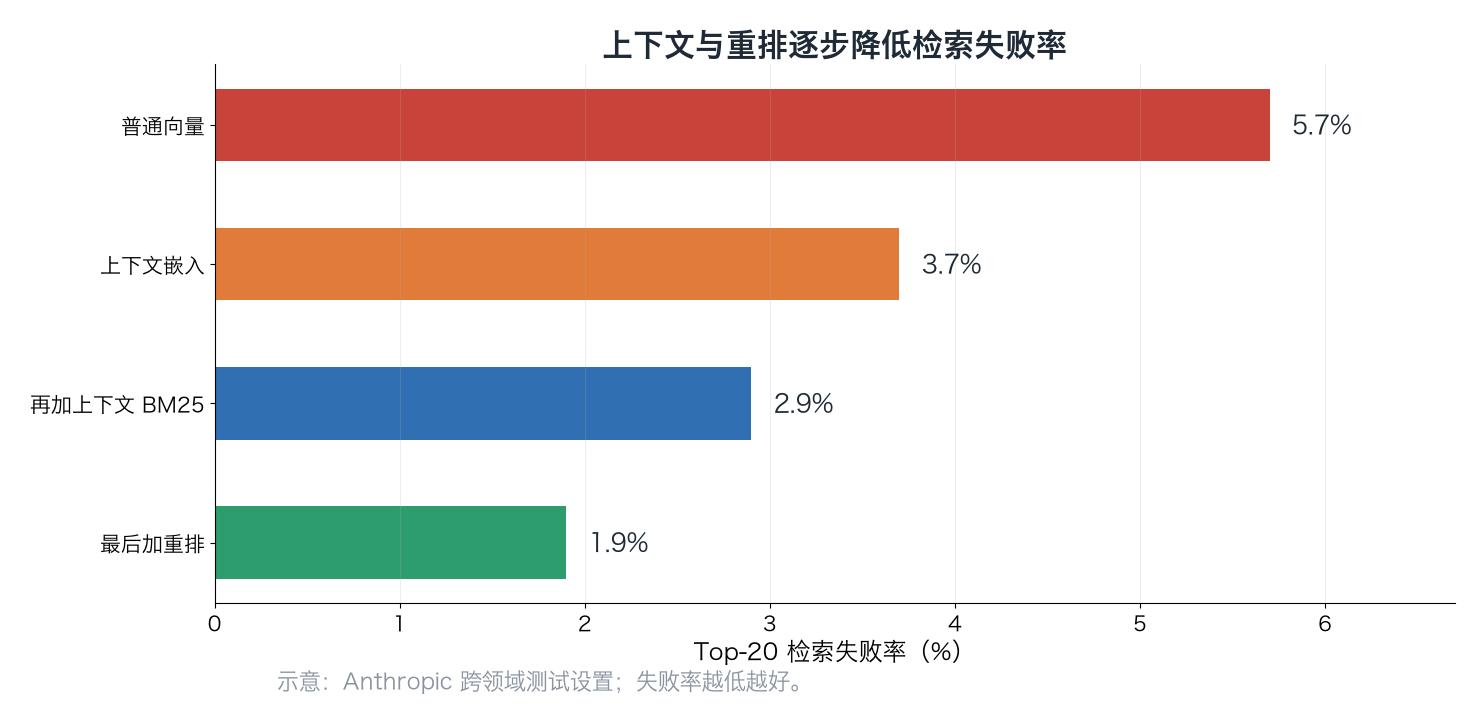
Anthropic 报告的 top-20 检索失败率:
| 做法 | 失败率 |
|---|---|
| 普通向量检索 | 5.7% |
| • 上下文嵌入 | 3.7%(降低 35%) |
| • 上下文关键词检索(BM25) | 2.9%(降低 49%) |
| • 重排 | 1.9%(降低 67%) |
04多跳问题与 Agentic RAG
有些问题一次检索答不了,例如:
「A 公司 CEO 的母校在哪个城市?」
需要先查「A 公司 CEO 是谁」,得到人名后,再查「这个人的母校」,最后查「这所学校在哪个城市」。每一步检索都依赖上一步的结果,这叫多跳(multi-hop)问题。
传统 RAG 只检索一次,而这类问题的第一次检索根本不知道该搜哪个人名。
Agentic RAG 把检索交给 Agent 决定:要不要检索、搜什么、结果够不够、要不要再搜一次。这就是第 30 讲(ReAct:边想边做) ReAct「思考 → 行动 → 观察」循环的一种应用。
轨迹演示(示意):
- 思考:要先知道 CEO 是谁。行动:检索「A 公司 CEO」。观察:张三。
- 思考:再查张三的教育背景。行动:检索「张三 毕业院校」。观察:某某大学。
- 思考:再查这所大学在哪里。行动:检索「某某大学 所在城市」。观察:杭州。
- 思考:信息够了。回答:杭州,并附上三处出处。
第 22 讲(什么是上下文工程)提到的「即用即取」就是这个思路:不预先塞满资料,而是由 Agent 按需取回。代价是调用次数更多、速度更慢,Agent 也可能走弯路。
- 1查 CEO得到人名
- 2查母校把人名带入查询
- 3查城市把学校带入查询
- 4回答并附出处汇总每一步证据
后一步查询依赖前一步结果;每一步都保留来源。
05让模型自己判断检索质量
两项代表性研究:
- Self-RAG(Asai 等,2023):训练模型自己决定什么时候需要检索,并用特殊的「反思标记」评价检索到的段落和自己写的内容;
- CRAG(纠正式 RAG)(Yan 等,2024):加一个轻量的检索评估器,给检索结果的质量打一个置信度,根据置信度采取不同动作。检索结果不好时,用网络搜索补充。
两者思路相同:不要盲目相信检索结果,先评估再使用。
06RAG 排查清单
- 资料库里真的有这份资料吗?
- 用户的说法和文档的说法一致吗?需不需要查询改写?
- 切片有没有切断关键信息?块有没有缺少背景?
- 需要精确词匹配吗?有没有加关键词检索?
- 取回来的段落里有答案吗?有的话,它排在第几?
- 提示词有没有要求「只根据资料回答,没有就说不知道,并标注出处」?
- 问题需要多步才能查到吗?需不需要 Agentic RAG?
- 资料里如果有恶意指令,比如「忽略以上要求」,会被模型执行吗?(第 39 讲(提示注入)讲提示注入)
07延伸阅读
- Ma et al., Query Rewriting for Retrieval-Augmented Large Language Models, 2023:arxiv.org
- Gao et al., Precise Zero-Shot Dense Retrieval without Relevance Labels(HyDE), 2022:arxiv.org
- Anthropic, Introducing Contextual Retrieval, 2024:anthropic.com
- Asai et al., Self-RAG: Learning to Retrieve, Generate, and Critique through Self-Reflection, 2023:arxiv.org
- Yan et al., Corrective Retrieval Augmented Generation, 2024:arxiv.org
- Anthropic, Effective context engineering for AI agents(即用即取):anthropic.com
- Yao et al., ReAct, 2022:arxiv.org
08一分钟讲给别人
试着用自己的话讲一遍RAG 答错时,先看检索结果里有没有正确答案:没有就是检索失败,有却没答对就是生成失败,两种失败的修法不同。修检索的方法有:查询改写;HyDE(先编一个假想答案再去检索);混合检索加重排;上下文检索(给每段加背景说明,Anthropic 报告失败率从 5.7% 降到 1.9%)。多跳问题要用 Agentic RAG,由 Agent 循环决定搜什么、够不够。Self-RAG 和 CRAG 让模型先评估检索质量,再决定怎么用。
5 道自测
先在心里答一遍,再展开对照。能说清理由,比答对数字更重要。
01检索结果里有正确答案,模型却答错了,这属于哪类失败?举两个可能的原因。
02HyDE 为什么要先编一个可能不准确的答案?
03「本季度营收增长 3%」这样的段落有什么问题?上下文检索怎么解决?
04为什么传统 RAG 难以回答「A 公司 CEO 的母校在哪个城市」?
05CRAG 在检索结果不好时会怎么做?
已看 0/5 题
练动手练习
准备一段包含明确答案的短资料和一个相关问题,先让 AI 检索或阅读后回答。若答案错了,先检查资料中是否真的有答案,再分别写下一条“修检索”和一条“修生成”的改法,不要一上来只改提示词。
完成这一课
读完讲义、看完自测答案,这一课就算学完了。
- 读完讲义
- 看完全部自测
本课为投资者教育内容,案例数字均为示意,不构成任何投资建议,也不承诺收益。规则和费率会变,实际操作前请以交易所、监管机构和产品的最新公告为准。