01学完你能做到
知道上下文越长不一定越好。
02上下文窗口是什么
上下文窗口是模型一次能「看到」的最大 token 数,输入和输出都算在里面(token 见第 6 讲(分词:模型看到的是 token))。窗口满了,最早的内容就得被裁掉或压缩。
近年来窗口越来越大,从几千 token 增长到几十万、上百万 token。很自然的想法是:既然放得下,就把所有资料都塞进去,让模型自己找。
这节用三项研究说明:放得下,不等于用得好。
03Lost in the Middle:中间的信息容易被忽略
Liu 等(2023)做了两个实验:
- 多文档问答:给模型很多篇文档,其中只有一篇包含答案;
- 键值检索:给一长串「键:值」对,问某个键对应的值。
他们只改变关键信息在输入中的位置,其他条件不变。
论文摘要的结论是:
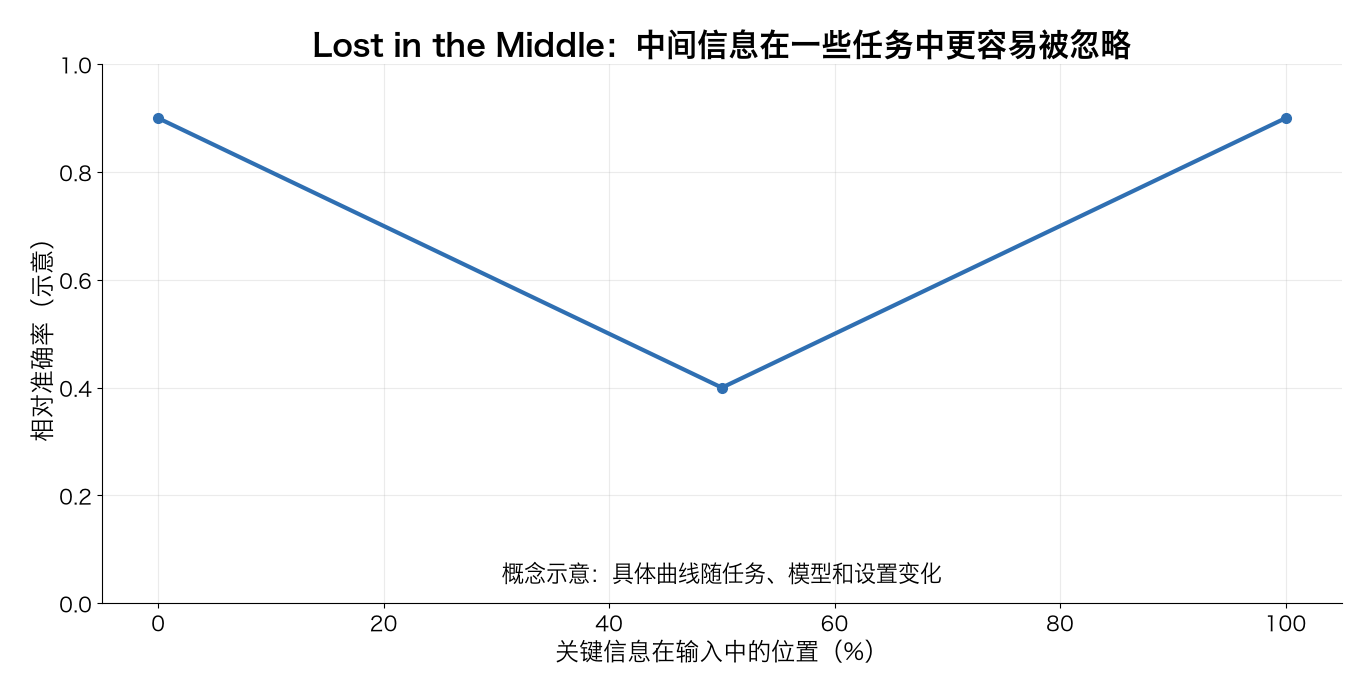
- 关键信息放在输入的开头或结尾时,效果通常最好;
- 关键信息放在中间时,效果显著变差;
- 即使是专门宣传「长上下文」的模型也有这个问题。
画成图就是一条 U 形曲线。(上图是示意曲线,形状参照论文结论,数值不是论文数据。)
实际启示:
- 最重要的指令和问题,放在开头或结尾。第 16 讲(提示词基础)提到 Anthropic 建议「长文档放前面、问题放最后」,也是同一个道理;
- 检索到多段资料时,最相关的放在两端,不要埋在中间。
04上下文腐化(Context Rot)
Chroma 在 2025 年发布了一份技术报告,名字就叫 Context Rot。他们测试了 18 个大模型,包括 GPT-4.1、Claude 4、Gemini 2.5、Qwen3。
他们的实验设计得很「干净」:任务本身都很简单,只改变输入长度,从而单独测量长度的影响。
报告的主要发现(共做了 4 组「大海捞针」扩展实验、LongMemEval 和重复词复制实验,约 19.4 万次模型调用):
- 输入越长,表现一致下降,在所有实验里都如此;
- 问题和答案的意思越不直接相关(不是字面匹配),长度带来的下降就越快;
- 干扰项(看起来相关但不是答案的内容)的影响因模型而异,输入越长影响越明显;
- 模型并不会「均匀地」使用上下文,表现会随长度变得越来越不可靠。
一个对比实验:聚焦版 vs 完整版
报告用 LongMemEval(一个对话记忆问答数据集)做了对比:
- 完整版输入:平均约 113k token,大部分是和问题无关的历史对话;
- 聚焦版输入:平均约 300 token,只保留回答问题需要的部分。
(数据集是清洗后的 306 道题,取自知识更新、时间推理、多会话三类问题。)
问题完全一样。模型在聚焦版上表现很好,在完整版上表现一致更差。因为完整版要求模型先在长文本里「找」,再推理,多了一步就多了出错的机会。
这正是第 22 讲(什么是上下文工程)说的:上下文要「尽可能小、信息密度尽可能高」。
一个容易误读的细节:Chroma 在它的「大海捞针」实验里测了 11 个针的位置,没有发现明显的位置差异。这和 Lost in the Middle 的 U 形曲线并不矛盾:两项研究的任务、模型、年代都不同。可以这样理解:「位置效应」不是在所有任务上都会出现,但「越长越差」在 Chroma 的所有实验里都出现了。
05KV 缓存:长上下文为什么又贵又慢
第 4 讲(词向量与语言模型)讲过,模型是一个 token 一个 token 地生成的(自回归)。每生成一个新 token,都要用到前面所有 token 的注意力信息,即每层的 Key 和 Value(第 7 讲(注意力机制))。第 7 讲(注意力机制)也提到过长上下文昂贵。为了不每次都重算,推理时会把它们存起来,这叫 KV 缓存。
KV 缓存占多少显存?每个 token 要存:
2(K 和 V)× 层数 × KV 头数 × 每个头的维度 × 每个数的字节数
算一个例子(假设配置:32 层,8 个 KV 头,每头 128 维,16 位精度即每个数 2 字节):
- 每个 token:2 × 32 × 8 × 128 × 2 = 131,072 字节 = 128 KB
- 12.8 万 token:131,072 × 128,000 = 16,777,216,000 字节 ≈ 15.6 GB(按 1 GB = 2³⁰ 字节算;按 1 GB = 10⁹ 字节算约 16.8 GB)
这只是一条请求的缓存。上下文越长,每个请求占的显存越多,同一张卡能同时服务的用户就越少。这就是长上下文贵的原因之一。
06多轮对话的成本累积
API 每次调用都要把全部历史重新发给模型,按输入 token 计费。
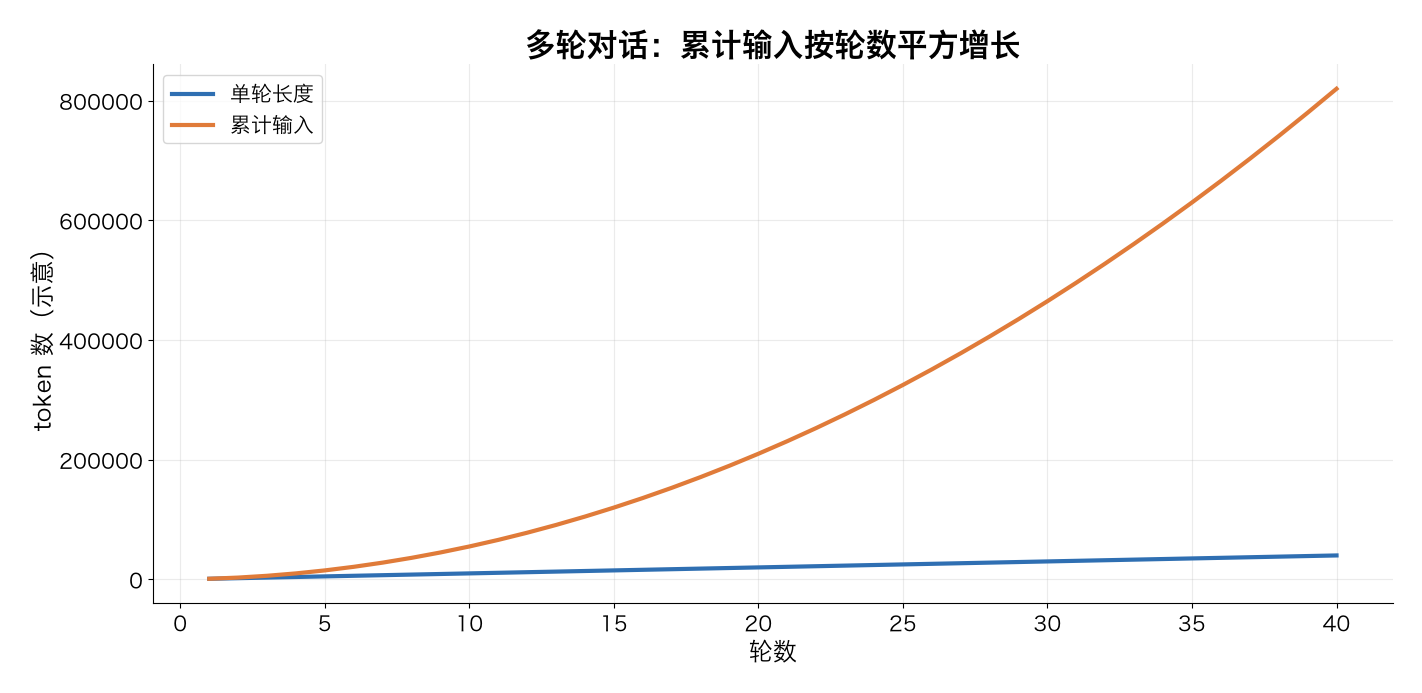
演示:假设每一轮对话新增 1,000 token(用户提问 + 模型回答)。
- 第 1 轮输入 1,000,第 2 轮 2,000,……,第 20 轮 20,000;
- 20 轮累计输入 = 1,000 × (1 + 2 + … + 20) = 1,000 × 210 = 210,000 token。
单轮长度线性增长,累计成本却按平方增长。轮数翻倍到 40 轮,累计就是 1,000 × 820 = 82 万,约为 20 轮的 4 倍。
缓解办法:
- 提示缓存(prompt caching):OpenAI 文档说明,它缓存的正是上面第 4 部分讲的 KV 状态,而不是文本本身。如果后一次请求和前一次的开头一段(前缀)完全相同,就能直接复用,省掉重算,输入更便宜、首字更快。文档给的做法:
- 稳定的指令、工具定义、参考资料放在最前面;时间戳、用户个人信息这类会变的内容放在后面;
- 多轮对话里只追加、不改写前面的消息;摘要、压缩或截断历史会改变前缀,让缓存失效;
- 工具定义的内容和顺序保持不变,不用某个工具时用设置关掉,而不是把它从列表里删掉。
缓存部分的折扣因模型而异(文档写的是「最高 95%」),以官方价格页为准。Anthropic 也提供类似功能;
- 压缩历史:第 27 讲(压缩与隔离)会讲;
- 只保留需要的内容:第 22 讲(什么是上下文工程)的四类策略。
- 1追加一轮对话历史变长
- 2重新发送历史输入包含前面内容
- 3累计成本上升总量近似按轮数平方增长
07延伸阅读
- Liu et al., Lost in the Middle: How Language Models Use Long Contexts, 2023:arxiv.org
- Chroma, Context Rot: How Increasing Input Tokens Impacts LLM Performance, 2025:research.trychroma.com
- OpenAI, Prompt caching:platform.openai.com
08一分钟讲给别人
试着用自己的话讲一遍上下文窗口是模型一次能看到的 token 上限,但放得下不等于用得好。Lost in the Middle 发现,关键信息放在开头或结尾时效果最好,放在中间时显著变差,所以重要内容要放两端。Chroma 测试了 18 个模型,发现输入越长表现越差;同一个问题,约 300 token 的聚焦版输入远好于约 113k token 的完整版。长上下文还很贵:KV 缓存随长度线性增长;多轮对话每次都要重发全部历史,累计成本按平方增长。
5 道自测
先在心里答一遍,再展开对照。能说清理由,比答对数字更重要。
01Lost in the Middle 的 U 形曲线说的是什么?对写提示词有什么启示?
02Chroma 的实验为什么故意用很简单的任务?
03按本节的假设配置,6.4 万 token 的 KV 缓存大约多大?
04每轮新增 500 token,10 轮累计输入多少 token?
05列举两种降低多轮对话成本的方法。
已看 0/5 题
练动手练习
准备一段 5 句的资料,其中只有一句包含答案。把这句分别放在开头、中间和结尾,让 AI 回答同一个问题,记录它是否找对。再把无关资料扩展到更长,比较“聚焦版”和“完整版”的回答差异。
完成这一课
读完讲义、看完自测答案,这一课就算学完了。
- 读完讲义
- 看完全部自测
本课为投资者教育内容,案例数字均为示意,不构成任何投资建议,也不承诺收益。规则和费率会变,实际操作前请以交易所、监管机构和产品的最新公告为准。