01学完你能做到
长任务里上下文越积越多时,用四种办法控制住它:压缩(compaction)、清理工具结果、结构化笔记、子智能体隔离。
02问题:长任务会把窗口撑爆
Agent 每调用一次工具,结果就追加进上下文。一次搜索返回几千 token,读一个文件可能上万 token。几十步之后,窗口里大部分是早就用过的旧工具结果。
这会带来三个问题:
- 装不下:超过窗口上限;
- 变笨:第 23 讲(上下文窗口与上下文腐化)讲的上下文腐化,内容越多,越难找准关键信息;
- 变贵:每一步都要把整段历史重新发一遍。
第 22 讲(什么是上下文工程)列过四类策略。本节讲其中的压缩和隔离,外加 Anthropic 文章里的结构化笔记(它属于「写入」,常和压缩配合使用)。
03清理工具结果:最轻的一刀
Anthropic 的上下文工程文章说:工具在很早之前就被调用过,Agent 为什么还要再看一遍原始结果?清理工具结果是最安全、最轻量的压缩方式之一。
做法很直接:只保留最近几条工具结果的完整内容。更早的换成一行占位,比如「[已清理:第 12 步搜索结果,结论已记在笔记里]」。
04压缩(compaction):总结后重开
文章的定义是:对话快到窗口上限时,把内容总结一下,再用这份总结开启一个新窗口。它通常是上下文工程里的第一道杠杆。
文章举了 Claude Code 的做法:
- 把消息历史交给模型,总结压缩出最关键的细节;
- 保留架构决策、没解决的 bug、实现细节;
- 丢掉重复的工具输出和消息;
- 带着这份压缩后的上下文,加上最近访问的 5 个文件,继续干活。
难点在于取舍。压得太狠,会丢掉当时看起来不重要、后来却很关键的细节。文章建议先追求「召回」,把该留的都留下,再逐步去掉多余的。
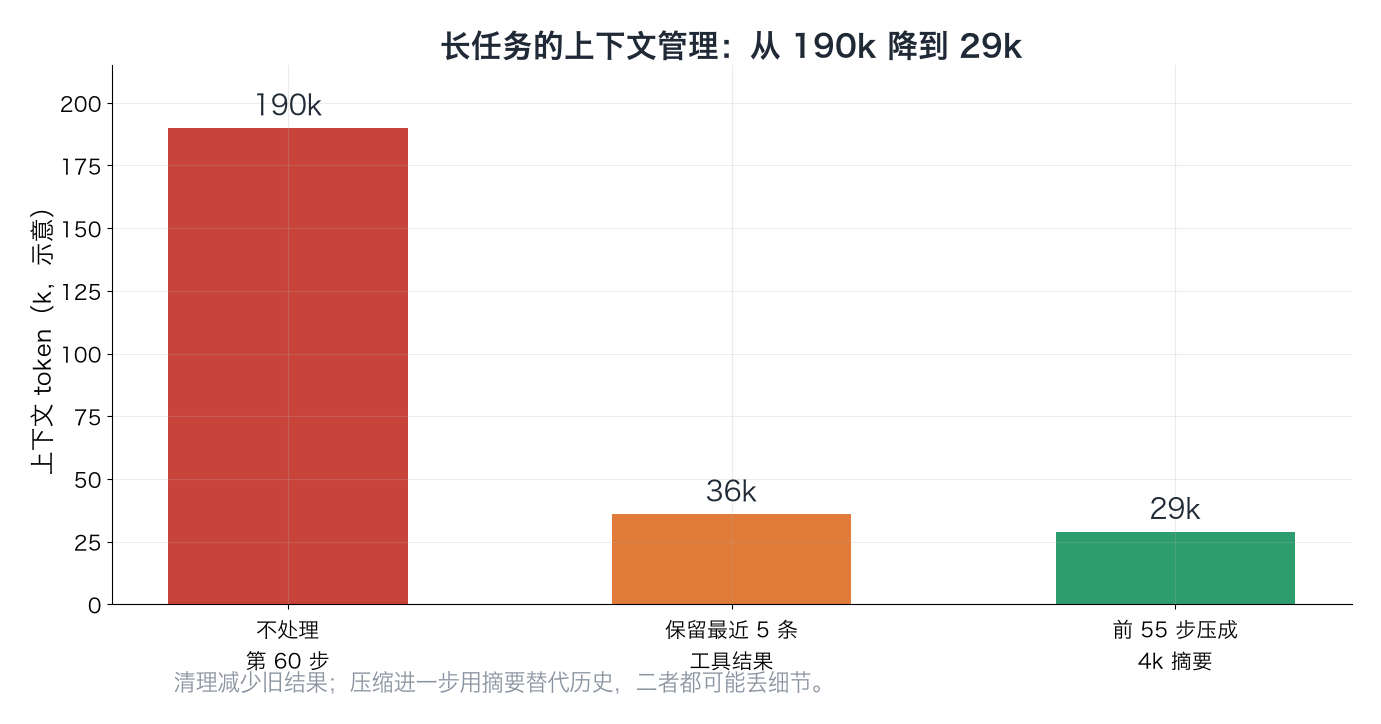
演示:长任务第 60 步的上下文账(数字为示意)
假设:系统提示 + 工具说明 10k;每步工具结果平均 3k;占位说明 + 简短思考每步 0.2k;窗口 200k。
| 做法 | 计算 | 合计 |
|---|---|---|
| 不处理 | 10k + 60 × 3k | 190k(逼近上限) |
| 清理旧工具结果,保留最近 5 条 | 10k + 5 × 3k + 55 × 0.2k | 36k |
| 再加压缩:前 55 步总结成 4k 摘要 | 10k + 5 × 3k + 4k | 29k |
从 190k 降到 29k,降了约 85%。而且留下的都是「当前要用的」内容。
副作用:第 23 讲(上下文窗口与上下文腐化)讲过,提示缓存要求开头一段完全不变,而摘要、压缩会改变这段前缀,让缓存失效。所以不要每一步都压,攒到一定程度再压一次。
05结构化笔记:让 Agent 自己记笔记
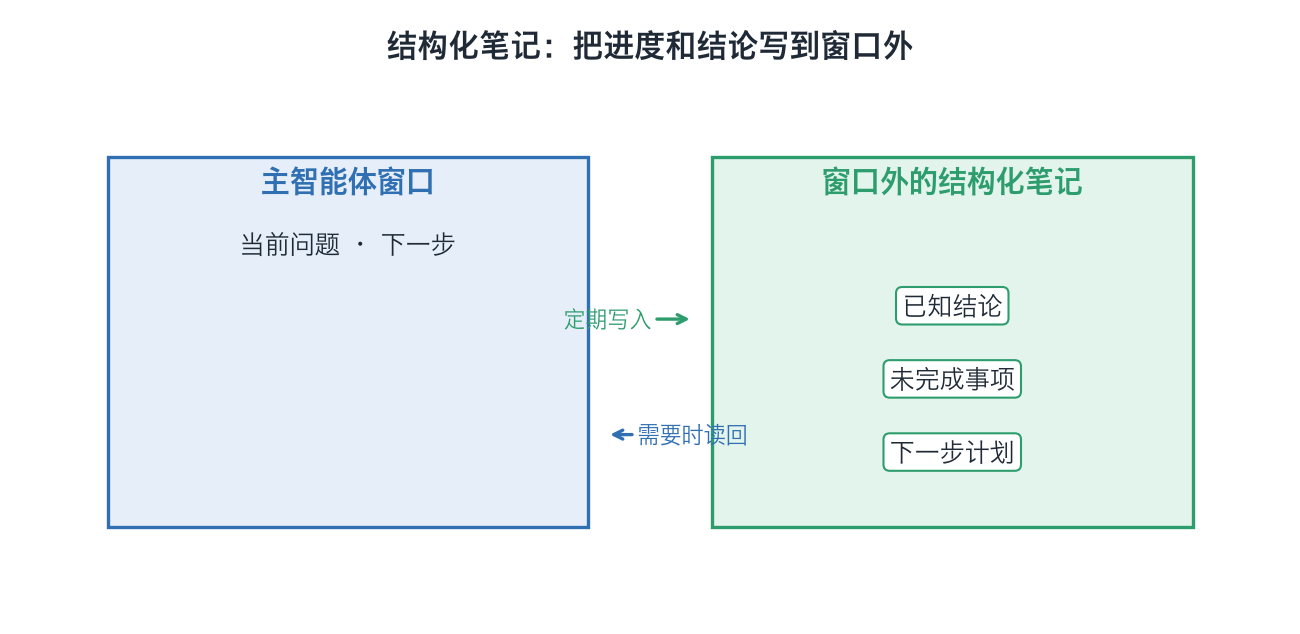
做法是让 Agent 定期把要点写到窗口之外(比如一个 NOTES.md 文件或待办清单),需要时再读回来。文章说这是一种开销很小的持久记忆,并举了两个例子:
- Claude Code 会建待办清单,自定义 Agent 可以维护一个
NOTES.md; - Claude 玩宝可梦时,在几千步游戏里记下精确的进度,例如「过去 1,234 步一直在 1 号道路练级」。上下文重置后,读一遍自己的笔记就能接着干。
笔记和压缩的区别:
| 压缩 | 结构化笔记 | |
|---|---|---|
| 谁来决定留什么 | 到点时整体总结一次 | Agent 边做边记 |
| 存在哪 | 新窗口的开头 | 窗口外的文件或记忆工具 |
| 典型内容 | 一段总结 | 待办、进度、已知结论、下一步 |
这和第 26 讲(记忆) MemGPT 的「工作上下文」是同一个思路:关键事实单独存放,可以随时改写。
06子智能体隔离:脏活放在别的窗口里干
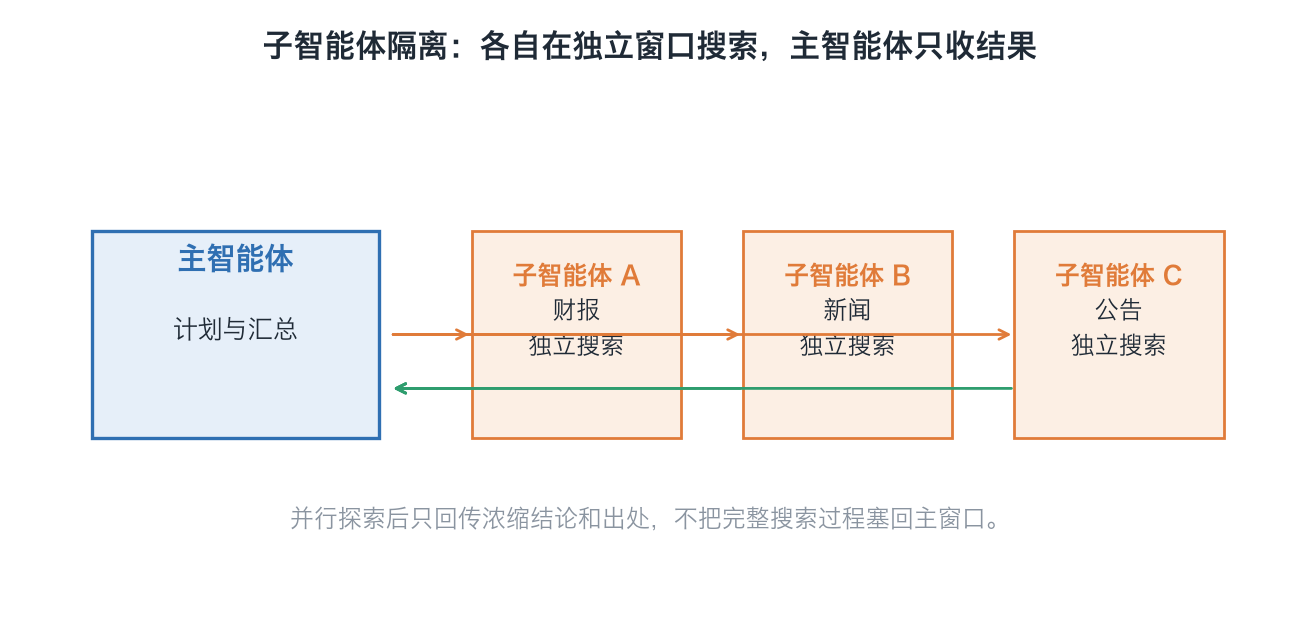
与其让一个 Agent 在同一个窗口里干完所有事,不如让主智能体只管计划和汇总,把具体的搜索、阅读交给子智能体。每个子智能体有自己干净的窗口。
Anthropic 的文章说:每个子智能体可能用几万甚至更多 token 去探索,但只交回浓缩后的总结(通常 1,000–2,000 token)。搜索细节被隔离在子智能体里,主智能体专心综合。
演示:调研「某新能源车企」
- 子智能体 A 查财报,B 查行业新闻,C 查监管公告,每个在自己的窗口里各花约 4 万 token;
- 各交回约 1.5k 的结论;
- 主智能体看到约 3 × 1.5k = 4.5k。如果全在一个窗口里做,要看约 3 × 40k = 12 万 token。
(数字是示意,倍数关系来自上面的 1,000–2,000 token 说法。)
07实际案例:Anthropic 多智能体研究系统
Anthropic 在 2025 年介绍了 Claude 的「Research」功能:主智能体拆出多个子智能体,让它们并行搜索。几个数字:
- 主智能体用 Claude Opus 4、子智能体用 Claude Sonnet 4 的组合,在他们内部的研究评测上比单个 Opus 4 高 90.2%;
- 在 BrowseComp 评测里,token 用量一项就解释了 80% 的表现差异。也就是说,多智能体效果好,很大一部分是因为能用更多 token;
- 代价是:单个 Agent 约用聊天的 4 倍 token,多智能体系统约 15 倍。
文章还提到几条长任务做法,正好对应本节内容:
- 上下文超过 20 万 token 会被截断,所以主智能体先把计划存进 Memory(结构化笔记);
- 一个阶段做完,就把它总结后存到外部记忆,再开新的子智能体,用干净的上下文继续(压缩 + 隔离);
- 子智能体把结果写到文件系统,只把轻量的「引用」交回主智能体,避免层层转述时丢信息。
什么时候不该用多智能体:文章说,任务要求所有智能体共享同一份上下文、或者子任务之间依赖很多时(比如大多数编程任务),多智能体目前并不合适。多智能体放在第 32 讲(多智能体)细讲。
08四种办法怎么选
| 情况 | 先用 |
|---|---|
| 工具结果大,用过就没用了 | 清理工具结果 |
| 对话或任务快到窗口上限 | 压缩 |
| 任务跨很多步,要记进度 | 结构化笔记 |
| 有几块可以独立做的大量搜索、阅读 | 子智能体 |
- 清理工具结果移除低价值旧结果
- 压缩总结后开启新上下文
- 结构化笔记把进度写到窗口外
- 子智能体隔离把独立搜索放到别的窗口
四种办法不是先后步骤,按任务瓶颈选择。
09延伸阅读
- Anthropic, Effective context engineering for AI agents:anthropic.com
- Anthropic, How we built our multi-agent research system, 2025-06-13:anthropic.com
10一分钟讲给别人
试着用自己的话讲一遍长任务里工具结果会越积越多,导致装不下、变笨、变贵。最轻的办法是清理旧工具结果,只留最近几条完整内容。压缩是快满时把历史总结一下,用总结开新窗口:Claude Code 保留架构决策和未解决的 bug,丢掉重复输出,并带上最近 5 个文件;难点是取舍,而且压缩会让提示缓存失效。结构化笔记让 Agent 边做边把进度写到窗口外。子智能体在各自干净的窗口里探索,只交回 1,000–2,000 token 的总结。Anthropic 的多智能体研究系统比单智能体高 90.2%,但 token 用量约为聊天的 15 倍。
6 道自测
先在心里答一遍,再展开对照。能说清理由,比答对数字更重要。
01为什么说清理工具结果是「最轻的一刀」?
02按本节演示的假设,如果保留最近 10 条工具结果(不做压缩),第 60 步约占多少 token?
03压缩得太狠会有什么风险?Anthropic 建议怎么调?
04结构化笔记和压缩有什么不同?
053 个子智能体各探索 5 万 token、各交回 2k,主智能体大约看到多少?
06多智能体为什么不总是更好?
已看 0/6 题
练动手练习
模拟一个需要多步完成的调研任务,先写下 5 条工具结果和 3 条待办。把已经用过的结果替换成占位,把关键进度写成窗口外的笔记,再把一个独立子任务交给“干净窗口”,比较主任务最终需要看到的信息量。
完成这一课
读完讲义、看完自测答案,这一课就算学完了。
- 读完讲义
- 看完全部自测
本课为投资者教育内容,案例数字均为示意,不构成任何投资建议,也不承诺收益。规则和费率会变,实际操作前请以交易所、监管机构和产品的最新公告为准。