01学完你能做到
区分「工作流(workflow)」和「智能体(agent)」,记住「LLM + 工具 + 循环」这个骨架,认识五种常用的工作流模式,并能判断一个需求该用哪种。
02一句话定义
Anthropic 在《Building effective agents》(2024 年 12 月)里把「智能体系统」分成两类:
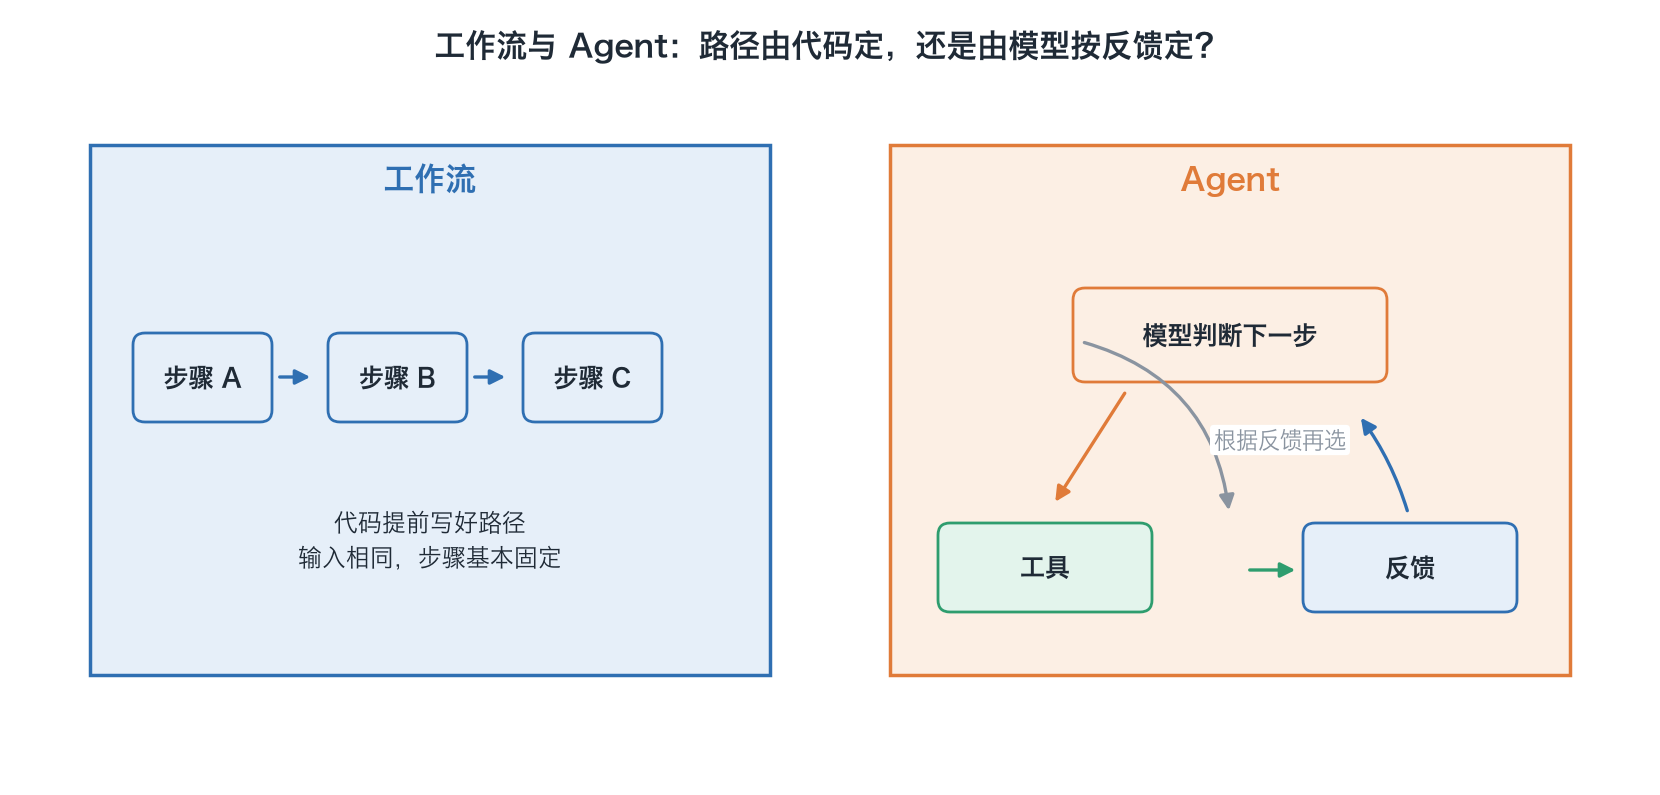
- 工作流(workflow):LLM 和工具按照预先写好的代码路径来编排;
- 智能体(agent):LLM 自己动态决定流程和工具的使用,自己掌控怎么完成任务。
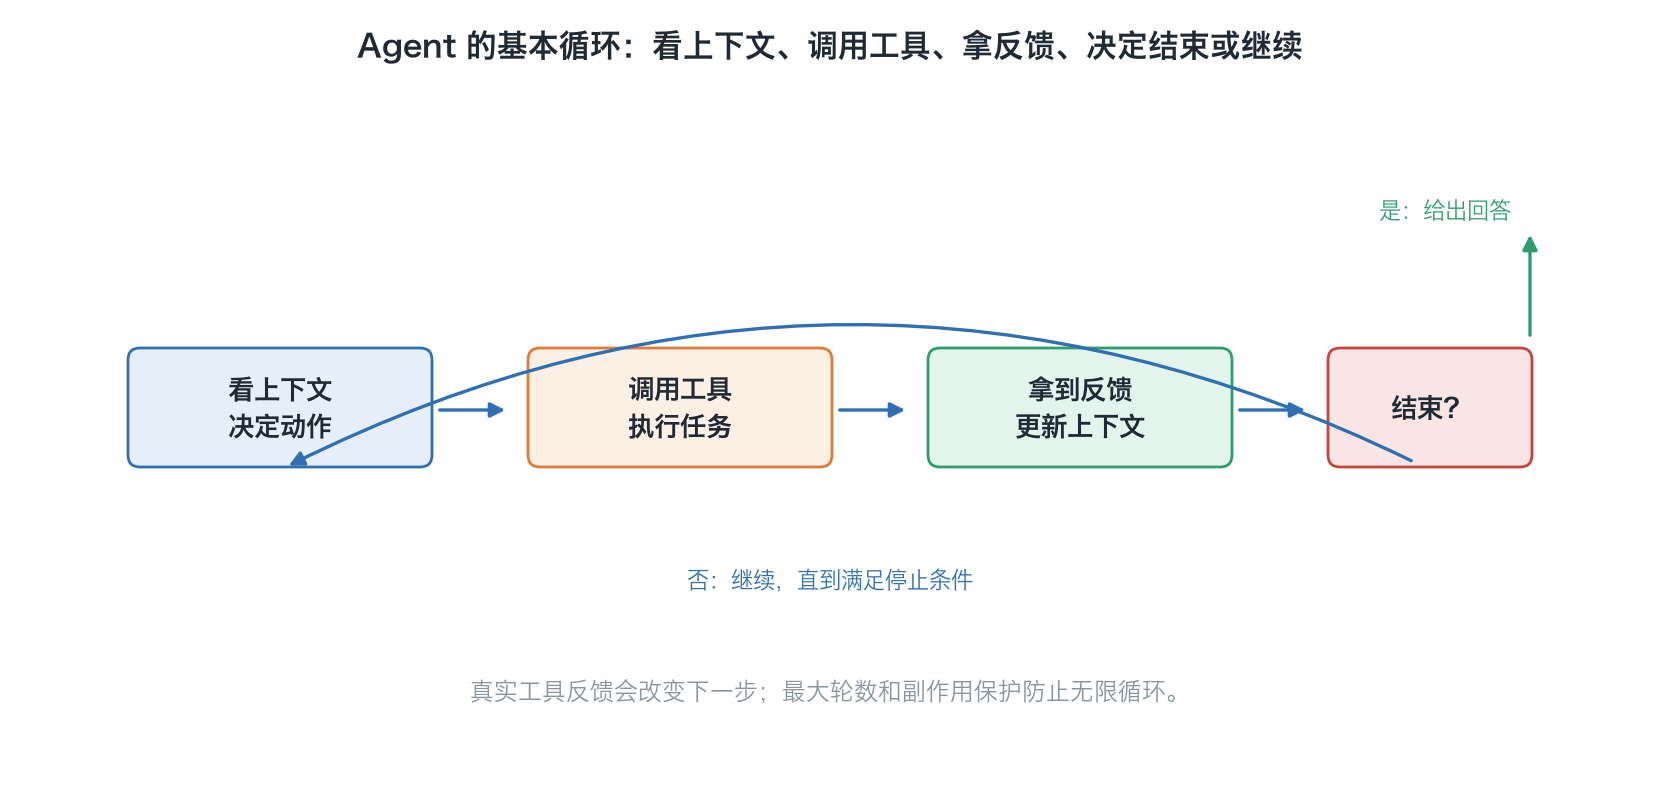
文章说,智能体落到实现上「通常就是 LLM 在一个循环里,根据环境反馈使用工具」。
两者的区别在于谁决定下一步:
| 工作流 | 智能体 | |
|---|---|---|
| 下一步由谁定 | 写代码的人,事先定好 | 模型,运行时根据反馈决定 |
| 步数 | 固定或有限几种 | 不固定,做到完成或碰到上限为止 |
| 可预测性 | 高,好测试 | 低,同一个任务每次的路径可能不同 |
| 适合 | 步骤清楚、可以拆好的任务 | 步骤事先说不清的开放任务 |
| 成本和延迟 | 低 | 高 |
OpenAI 的说法:OpenAI 的《A practical guide to building agents》把智能体定义为「代替你独立完成任务的系统」,并说一个智能体最基本由三部分组成:模型(负责推理和决策)、工具(调用外部函数或 API)、指令(行为准则和护栏)。它还明确说:用了 LLM 但不让 LLM 控制流程执行的应用,比如简单聊天机器人、单轮问答、情感分类器,都不算智能体。
注意用词差别:OpenAI 指南里的「workflow」泛指「为达成目标要完成的一串步骤」,和 Anthropic 说的「预先写死路径的工作流」不是一个意思。本课程按 Anthropic 的用法。
03骨架:LLM + 工具 + 循环
Anthropic 把所有这类系统的基本积木叫做增强型 LLM:一个 LLM,加上检索、工具、记忆三种增强(分别见第 24、29、26 讲)。
智能体就是把它放进循环里:
- 模型看当前上下文,决定下一步(调用哪个工具、用什么参数,或者直接回答);
- 程序执行工具,把结果(环境反馈)放回上下文;
- 回到第 1 步,直到模型认为完成,或者碰到停止条件。
Anthropic 强调两点:
- 每一步都要从环境拿到真实反馈(工具结果、代码运行结果),用来判断进展;
- 要设停止条件,比如最大轮数,防止无限循环。
OpenAI 指南列的常见退出条件是:调用了某个特定工具、产生了某种结构化输出、出错、达到最大轮数。
这个循环的细节(工具怎么定义、怎么回传)放在第 29 讲(工具调用 / Function Calling)讲;循环里「先想再做」的写法放在第 30 讲(ReAct:边想边做)讲。
04五种工作流模式
Anthropic 归纳了生产中常见的五种工作流。下面每种都配上文章中的例子,再加一个投研场景示意。
| 模式 | 怎么做 | 文章的例子 | 投研场景示意 |
|---|---|---|---|
| 提示链 | 把任务拆成固定几步,上一步输出喂给下一步;中间可以加程序检查(「关卡」) | 先写营销文案再翻译;先写大纲、检查大纲、再写全文 | 先抽取财报数字 → 程序校验数字加总 → 再写点评 |
| 路由 | 先分类,再交给对应的专门流程 | 客服问题分到退款、技术支持等;简单问题给小模型,难题给大模型 | 用户问题分成「查行情 / 解释概念 / 投诉」三条线 |
| 并行 | 同时跑多个 LLM 调用再汇总。分两种:分段(拆成独立子任务)和投票(同一任务跑多次) | 一个模型答题、另一个同时做安全审查;多次审查代码漏洞 | 同一份研报让 3 个调用分别找风险点,再合并 |
| 编排者-工作者 | 中心 LLM 运行时动态拆任务,分给工作者,再汇总 | 每次要改哪些文件事先不知道的编程任务 | 「对比这几家公司」,由编排者决定查几家、查什么 |
| 评估-优化 | 一个 LLM 生成,另一个按标准评价并给反馈,循环改进 | 文学翻译 | 写客户周报,按合规清单审一遍再改 |
几点辨析:
- 「编排者-工作者」和「并行-分段」很像。区别在于并行的子任务是事先写死的,编排者的子任务是运行时才决定的;
- 「评估-优化」就是第 20 讲(程序辅助与自我改进) Self-Refine 的思路,只是生成和评估可以由两个不同的调用来做;
- 第 27 讲(压缩与隔离)的多智能体研究系统,就是「编排者-工作者」的一个实例。
- 提示链固定步骤串联
- 路由分类后分流
- 并行同时跑独立任务
- 编排者—工作者运行时动态拆分
- 评估—优化评价后循环改进
五种模式是结构选项,不是必须依次执行的五个步骤。
05先选最简单的方案
Anthropic 的核心建议是:先找最简单的解法,只在需要时才增加复杂度,很多时候甚至根本不需要做成智能体系统。原因是智能体系统通常是用延迟和成本换效果。
演示:错误为什么会累积
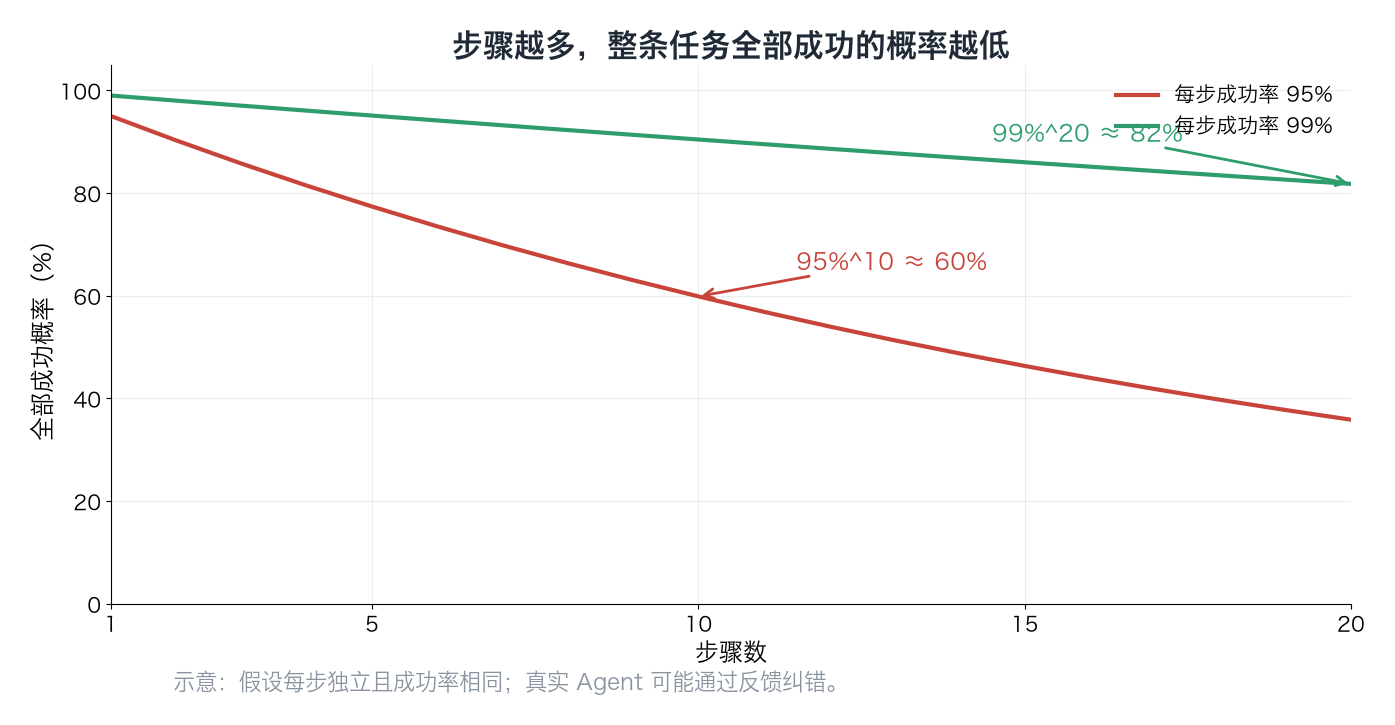
智能体自主决定步数,步数一多,错误就会累积。假设每一步独立、成功率相同(这是简化),整条任务全部做对的概率是:
- 每步 95%,走 10 步:0.95¹⁰ ≈ 60%;
- 每步 95%,走 20 步:0.95²⁰ ≈ 36%;
- 每步 99%,走 20 步:0.99²⁰ ≈ 82%。
所以同一个任务,能用 3 步工作流解决的,就不要让智能体走 15 步。真实情况下智能体可以靠环境反馈纠错,比这个算法乐观一些;但「步数越多越难稳」的趋势是成立的。这也是为什么第 35、36 讲要专门讲长任务和错误恢复。
判断顺序
- 单次 LLM 调用加检索、加几个示例能不能解决?能就停在这里。
- 步骤能事先说清楚吗?能就用工作流(提示链、路由、并行……)。
- 步骤事先说不清、需要根据中间结果灵活决定,而且结果容易验证,出错代价可控?这时才用智能体,并且要设停止条件、放在沙箱里测试(第 36 讲(权限、沙箱与错误恢复))。
OpenAI 指南也给了适合用智能体的三类场景:复杂决策(需要判断例外情况,比如客服退款审批)、难以维护的规则(规则多到改一条就容易出错)、大量非结构化数据(读文档、理解自然语言)。它同样建议先把单个智能体做好,靠逐步加工具扩展能力,不要一开始就上多智能体。
06Anthropic 的三条原则
- 简单:设计保持简单;
- 透明:把智能体的计划步骤显式展示出来;
- 精心设计智能体-计算机接口(ACI):像设计给人用的界面一样,认真写工具的说明文档、反复测试。
文章附录举了一个例子:他们做 SWE-bench 编程智能体时,花在优化工具上的时间比花在整体提示词上的还多。模型在离开项目根目录后用相对路径会出错,他们把工具改成必须用绝对路径,问题就没了。这种「让工具难以被用错」的设计叫防呆(poka-yoke),第 29 讲(工具调用 / Function Calling)会接着讲。
07延伸阅读
- Anthropic, Building effective agents, 2024-12-19:anthropic.com
- OpenAI, A practical guide to building agents:cdn.openai.com
- Lilian Weng, LLM Powered Autonomous Agents, 2023:lilianweng.github.io
08一分钟讲给别人
试着用自己的话讲一遍工作流是 LLM 和工具按事先写好的路径走;智能体是 LLM 在循环里根据环境反馈自己决定下一步、用什么工具。OpenAI 说智能体由模型、工具、指令组成,不让 LLM 控制流程的聊天机器人不算智能体。基本积木是增强型 LLM(检索、工具、记忆)。五种工作流模式是:提示链、路由、并行(分段或投票)、编排者-工作者、评估-优化。原则是先用最简单的方案,因为智能体用延迟和成本换效果,步骤一多错误还会累积。智能体要有真实反馈和停止条件,工具接口要认真设计。
6 道自测
先在心里答一遍,再展开对照。能说清理由,比答对数字更重要。
01工作流和智能体最本质的区别是什么?
02「每天早上抓取 5 个固定网站的新闻,翻译成中文,按模板汇总」,该用工作流还是智能体?用哪种模式?
03「编排者-工作者」和「并行-分段」有什么区别?
04每步成功率 90%,走 5 步,全部做对的概率约多少?
05为什么智能体一定要设停止条件?
06一个只做单轮情感分类的 LLM 应用,按 OpenAI 的定义算不算智能体?为什么?
已看 0/6 题
练动手练习
列出三个你熟悉的任务,例如固定网站汇总、公告风险抽取和跨资料查证。分别标记它们是单次问答、固定工作流还是需要根据反馈动态决定的 Agent,并为每个选择写下一个停止条件。
完成这一课
读完讲义、看完自测答案,这一课就算学完了。
- 读完讲义
- 看完全部自测
本课为投资者教育内容,案例数字均为示意,不构成任何投资建议,也不承诺收益。规则和费率会变,实际操作前请以交易所、监管机构和产品的最新公告为准。