01学完你能做到
说清 ReAct 的「思考 → 行动 → 观察」循环,知道它和「只用思维链」「只行动」有什么区别,认识它常见的失败方式。
02名字的意思
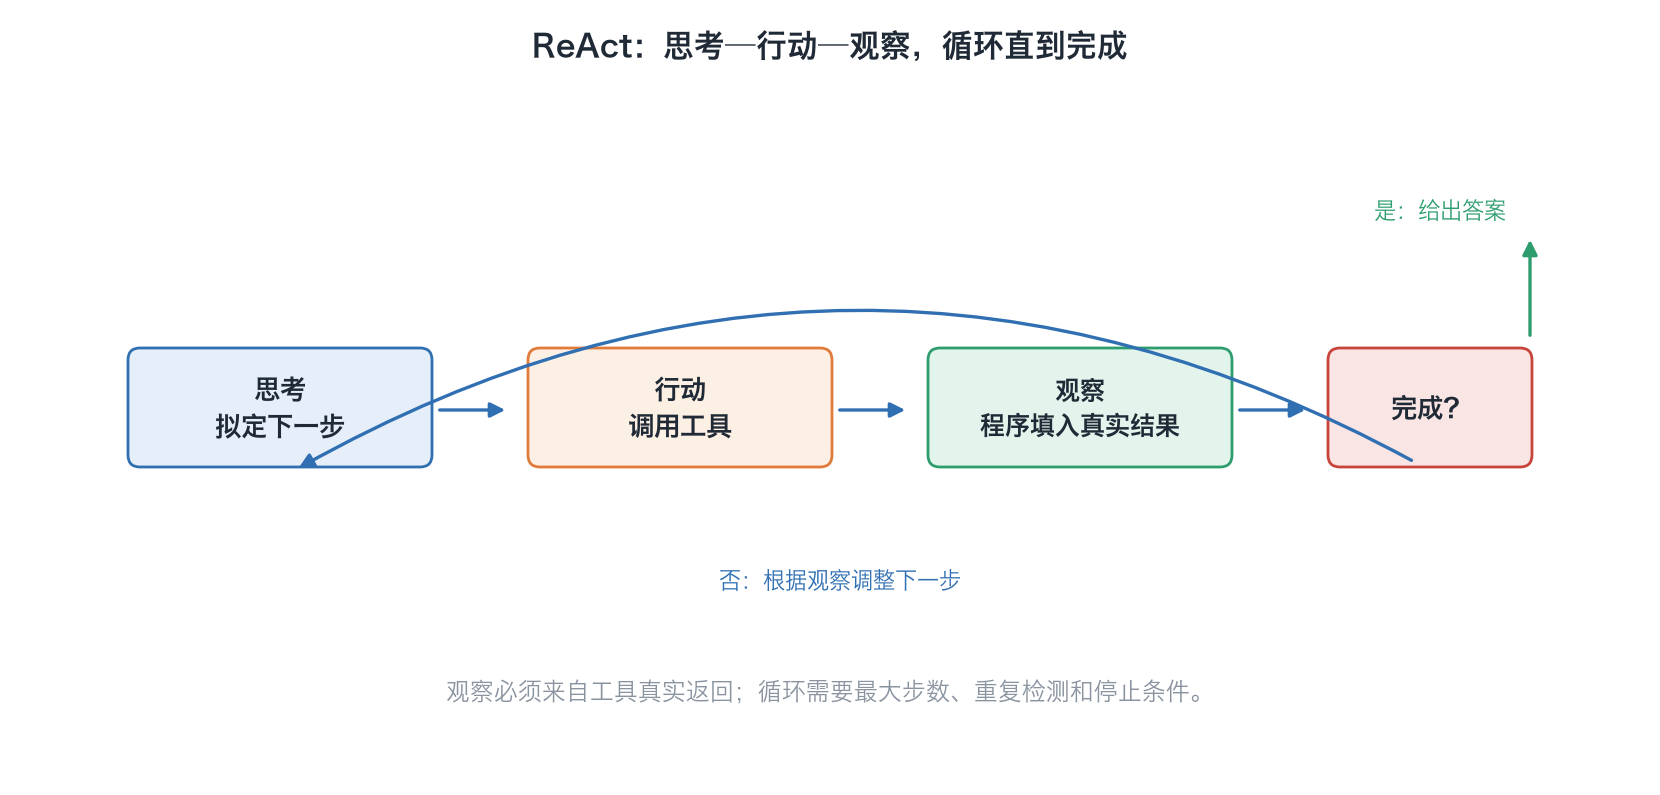
ReAct = Reasoning + Acting,推理加行动,出自 Yao 等(2022)的论文。思路很简单:把模型能做的「动作」扩充一种,即用语言写下的思考。思考不改变外部世界,只用来整理思路、做计划、解读观察结果。
于是模型的输出变成交替的三种内容:
- 思考(Thought):我现在知道什么、下一步该干什么;
- 行动(Action):调用一个工具,比如
Search[...]; - 观察(Observation):工具返回的结果,由程序填进来,不是模型写的。
然后再思考、再行动……直到行动是 Finish[答案]。这就是第 28 讲(什么是 Agent)「LLM + 工具 + 循环」最经典的一种写法。
03和其他三种做法比较
| 做法 | 做什么 | 主要问题 |
|---|---|---|
| 标准提示 | 问题 → 直接给答案 | 不推理,也不查资料 |
| 只用思维链(CoT,第 18 讲(思维链 CoT)) | 只在「脑子里」一步步推理 | 不接触外部世界,知识过时或缺失时会编造(幻觉) |
| 只行动(Act) | 只调用工具,不写思考 | 不知道自己在干什么,难以拆解目标、跟踪进度 |
| ReAct | 思考和行动交替 | 推理有外部事实支撑,行动有计划指导 |
论文的说法是:推理帮助模型制定、跟踪、更新行动计划,处理异常;行动让模型能从外部(知识库、环境)获取信息。
04演示:一条真实的 ReAct 轨迹
论文在 HotpotQA(需要多步查资料的问答)上用的工具只有三个:
search[实体]:返回维基百科页面的前 5 句,没有该页面就推荐 5 个相近的实体;lookup[字符串]:在当前页面里找包含该字符串的下一句;finish[答案]:结束并给出答案。
下面是论文附录里的提示示例,翻译并精简如下:
| 步骤 | 内容 |
|---|---|
| 问题 | 科罗拉多造山运动的东段延伸到哪个地区?那里的海拔范围是多少? |
| 思考 1 | 我需要搜「科罗拉多造山运动」,找到东段延伸到哪,再查那里的海拔。 |
| 行动 1 | Search[Colorado orogeny] |
| 观察 1 | 科罗拉多造山运动是科罗拉多及周边地区的一次造山事件。 |
| 思考 2 | 没提到东段,我要在页面里找「eastern sector」。 |
| 行动 2 | Lookup[eastern sector] |
| 观察 2 | 东段延伸到高平原(High Plains),称为中部平原造山运动。 |
| 思考 3 | 东段延伸到高平原,我要搜高平原,找海拔范围。 |
| 行动 3 | Search[High Plains] |
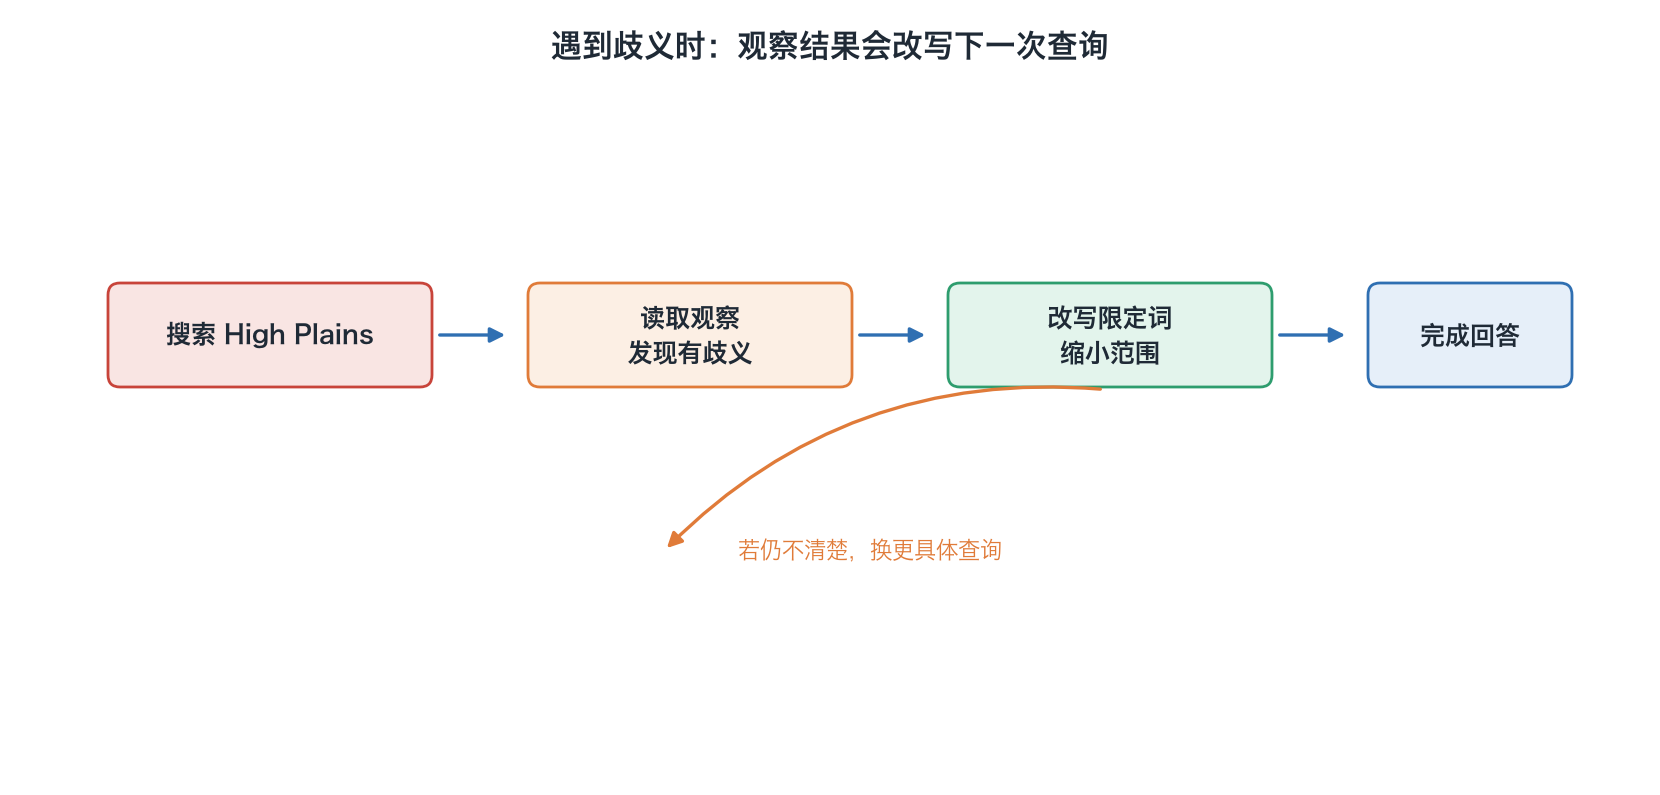
| 观察 3 | 「High Plains」指两个不同的地区。(有歧义) |
| 思考 4 | 应该改搜 High Plains (United States)。 |
| 行动 4 | Search[High Plains (United States)] |
| 观察 4 | ……高平原海拔从约 1,800 英尺升到 7,000 英尺。 |
| 思考 5 | 答案是 1,800 到 7,000 英尺。 |
| 行动 5 | Finish[1,800 to 7,000 ft] |
值得注意的有三处:
- 思考 2:观察结果没给出想要的信息,模型换了一个工具(lookup),而不是瞎猜;
- 思考 4:搜索结果有歧义,模型根据观察改写了查询。这正是第 29 讲(工具调用 / Function Calling) Toolformer 做不到的「交互式」用法;
- 每个事实都来自观察,可以追溯。
对比:只行动会怎样迷路
论文附录给了 ALFWorld(文字版家务游戏)里只行动(Act)失败的例子。任务是「把一把干净的刀放到台面上」:
- 去台面 2,拿起刀 1;
- 回到台面 1,执行「在水槽 1 洗刀 1」→ 什么也没发生(它根本没走到水槽边);
- 去台面 3,想拿刀 2 → 什么也没发生(手里已经有刀了);
- 回台面 2 拿刀 1 → 什么也没发生;
- 又回台面 1「在水槽洗刀」→ 什么也没发生……一直循环。
没有思考,它不会停下来想「我在哪?为什么没反应?」。ReAct 的版本会写出类似「我要先去水槽洗刀,再放到台面上」的计划,按计划行动。
05实验结果
PaLM-540B,少样本提示:
| 方法 | HotpotQA(精确匹配) | FEVER(准确率) |
|---|---|---|
| 标准提示 | 28.7 | 57.1 |
| CoT | 29.4 | 56.3 |
| CoT-SC(自洽性,第 19 讲(自洽性与思维树)) | 33.4 | 60.4 |
| 只行动 Act | 25.7 | 58.9 |
| ReAct | 27.4 | 60.9 |
| CoT-SC → ReAct | 34.2 | 64.6 |
| ReAct → CoT-SC | 35.1 | 62.0 |
怎么看这张表:
- ReAct 一直比只行动好,说明「思考」有用;
- 在 FEVER(核查事实真假)上 ReAct 比 CoT 好(60.9 对 56.3),因为需要查准确的事实;在 HotpotQA 上反而略差(27.4 对 29.4);
- 最好的是两者结合,互相兜底:
- ReAct → CoT-SC:ReAct 在规定步数内(HotpotQA 7 步、FEVER 5 步)给不出答案,就改用 CoT-SC;
- CoT-SC → ReAct:CoT-SC 多次采样里,多数答案出现的次数不到一半(说明模型自己心里也没底),就改用 ReAct 去查。
在需要连续行动的任务上,差距更大:
- ALFWorld:ReAct 最好的一次成功率 71%,只行动最好 45%,模仿学习方法 BUTLER 37%;
- WebShop(模拟网购):成功率 40.0% 对 30.1%,比之前最好的方法高 10 个百分点。
06常见失败
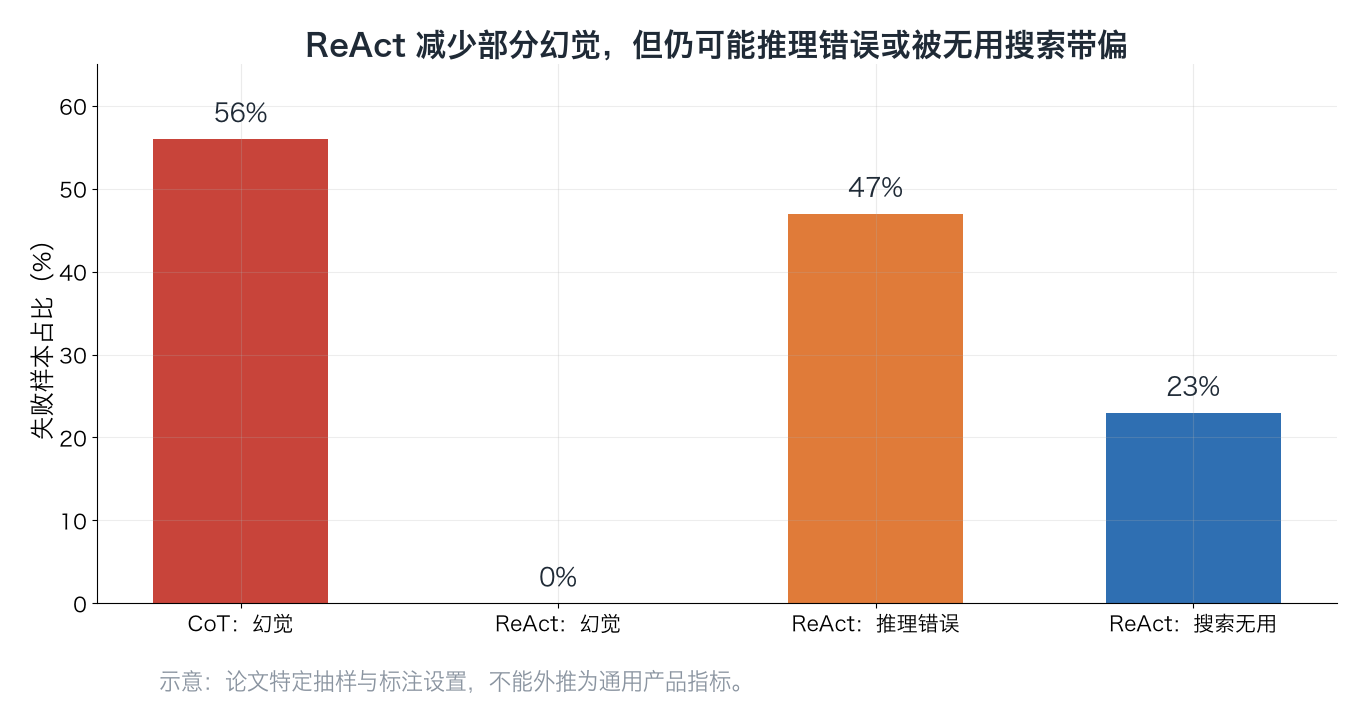
论文从 HotpotQA 里随机抽了 ReAct 和 CoT 各 50 条答对的、50 条答错的,共 200 条,人工标注原因。失败部分:
| 失败类型 | ReAct | CoT |
|---|---|---|
| 推理错误(包括陷入重复步骤出不来) | 47% | 16% |
| 搜索结果为空或没用 | 23% | —(CoT 不搜索) |
| 幻觉 | 0% | 56% |
| 标签歧义(答对了但和标准答案写法不同) | 29% | 28% |
另外,在答对的样本里,CoT 有 14% 其实是带着编造的推理「蒙对」的,ReAct 只有 6%。
把它翻译成产品语言:
- 原地打转:重复同样的思考和行动。解法:设最大步数;检测重复调用;最多时给出「换个思路」的提示,或者交给 CoT 兜底。
- 被差的搜索结果带偏:论文说,没有信息量的搜索结果会让模型很难恢复、重新组织思路。解法:改进工具(第 29 讲(工具调用 / Function Calling)),比如返回更相关的内容、有用的报错。
- 格式不稳:hello-agents 教程第 4 章指出,ReAct 依赖精心设计的提示词模板,模型不按格式输出就会导致解析失败、流程中断。解法:用原生工具调用代替自己解析文本,见第 29 讲(工具调用 / Function Calling)。
- 又慢又贵:每一步都要调用一次模型。简单问题不需要 ReAct(第 28 讲(什么是 Agent):先选最简单的方案)。
- 缺乏全局规划:走一步看一步,可能陷入局部最优。这引出第 31 讲(先规划后执行与反思)的「先规划后执行」。
hello-agents 第 4 章给的调试建议也很实用:每次调用前打印完整的提示词;解析失败时打印模型的原始输出;检查工具的输入输出格式;在提示词里加一两个完整的「思考-行动-观察」成功示例。
07延伸阅读
- Yao et al., ReAct: Synergizing Reasoning and Acting in Language Models, ICLR 2023:arxiv.org
- Datawhale, hello-agents 第四章《智能体经典范式构建》4.2.4 节:github.com
08一分钟讲给别人
试着用自己的话讲一遍ReAct 让模型交替输出思考、行动和观察:思考用来做计划、解读结果,行动调用工具,观察是程序填回来的真实结果,直到 Finish 给出答案。和只用思维链比,它的推理有外部事实支撑,幻觉大大减少(CoT 失败中 56% 是幻觉,ReAct 是 0%);和只行动比,它有计划、会根据观察改写查询。它的主要失败是推理打转(47%)和被没用的搜索结果带偏(23%)。最好的做法是 ReAct 和 CoT-SC 互相兜底;在 ALFWorld 上成功率 71% 对只行动的 45%。实际使用要设步数上限、检测重复,并用好的工具和原生工具调用。
6 道自测
先在心里答一遍,再展开对照。能说清理由,比答对数字更重要。
01ReAct 的「观察」是谁写的?为什么这一点很重要?
02只用 CoT 最主要的失败类型是什么?ReAct 为什么能避免?
03ReAct 最主要的失败类型是什么?你会怎么在产品里防范?
04为什么在 HotpotQA 上 ReAct 单独用反而比 CoT 略差,结合起来却最好?
05在演示轨迹里,模型遇到「High Plains 有歧义」时做了什么?这体现了 ReAct 的哪个优势?
06「CoT-SC → ReAct」在什么条件下切换?
已看 0/6 题
练动手练习
选一个需要查资料的事实问题,先让 AI 直接回答,再要求它按“思考目标—调用工具—观察结果—继续或结束”的 ReAct 格式完成。给它一次有歧义的检索结果,观察它是否会改写查询,并记录它可能在哪一步陷入循环。
完成这一课
读完讲义、看完自测答案,这一课就算学完了。
- 读完讲义
- 看完全部自测
本课为投资者教育内容,案例数字均为示意,不构成任何投资建议,也不承诺收益。规则和费率会变,实际操作前请以交易所、监管机构和产品的最新公告为准。