01学完你能做到
知道 Agent 怎么先列计划再动手,计划失效时怎么重规划,以及怎么用「写反思」从失败中学习。
上一节(第 30 讲(ReAct:边想边做))讲了 ReAct:想一步、做一步、看一步。它的毛病之一是走一步看一步,缺少全局规划。这节讲两种补法:
- 先规划后执行:动手之前先列出整份步骤清单。
- 反思(Reflexion):做失败了,用文字总结教训,下次带着教训再试。
02先规划后执行(Plan-and-Execute)
名字从哪来
「Plan-and-Execute」是业界对一种架构的叫法,没有一篇对应的原始论文。和它最接近的学术工作是 Plan-and-Solve 提示(Wang 等,2023),第 18 讲(思维链 CoT)讲过。Plan-and-Solve 把 Zero-shot CoT 的「Let's think step by step」换成了下面这句:
Let's first understand the problem and devise a plan to solve the problem. Then, let's carry out the plan and solve the problem step by step.
(先理解问题,制定解题计划;然后按计划一步一步解题。)
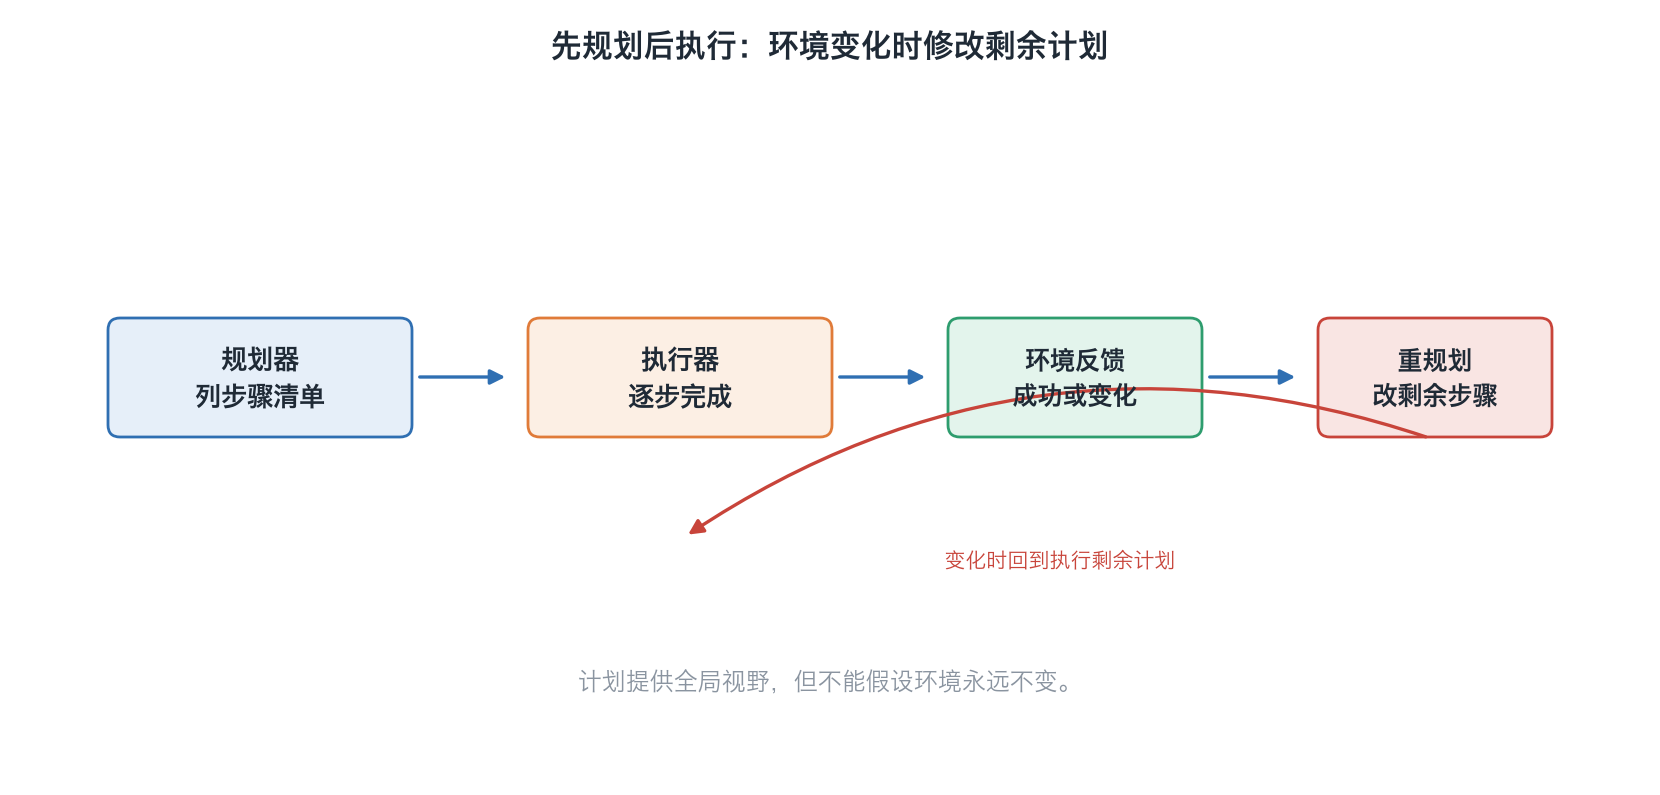
Plan-and-Solve 是一次回答里先写计划再解题。Plan-and-Execute 把这个思路放大成系统结构,分成三个角色:
| 角色 | 做什么 | 类比 |
|---|---|---|
| 规划器(Planner) | 读任务,写出步骤清单 | 项目经理排期 |
| 执行器(Executor) | 按清单一步一步做,每步可以调工具 | 工程师干活 |
| 重规划(Replan) | 根据已完成的结果,修改剩下的计划 | 周会调整排期 |
演示:同一个任务,ReAct 和先规划后执行怎么走
任务:「对比我们产品和竞品 A、B 的定价,写一页结论。」(示意,不是真实运行记录)
ReAct 的走法(第 30 讲(ReAct:边想边做)):
- 想:先查竞品 A。做:搜索 A 的定价。看:找到了。
- 想:A 有三档,再细看一下企业版……(越挖越深)
- ……20 步后窗口快满了,B 还没查。
先规划后执行的走法:
- 规划器先列清单:① 查我方定价;② 查 A;③ 查 B;④ 做对比表;⑤ 写结论。
- 执行器做 ①②。
- 执行器做 ③ 时发现 B 下架了,触发重规划:把 ③ 改成「查 B 的替代品 C」,后面的步骤不变。
- 执行器做完 ④⑤。
两种做法的差别:
- 有全局视野:清单写在那里,不容易在某个分支上陷太深,也不容易漏步骤(Plan-and-Solve 本来就是为了减少「漏步骤错误」)。
- 省钱:规划可以用强模型,执行用便宜模型;每步执行时不必把全部推理历史带上。
- 代价:计划是基于开头的信息写的,环境一变就过时,所以必须能重规划。不能重规划的计划比没有计划还危险,Agent 会照着错的清单一路做下去。
什么时候适合
| 适合先规划 | 适合 ReAct 边走边看 |
|---|---|
| 步骤能事先大致想清楚(调研、报告、迁移) | 下一步完全取决于上一步的结果(排查 bug、探索网页) |
| 任务长,怕中途跑偏 | 任务短,几步就完 |
| 想让人先审计划再执行 | 要求反应快 |
实际产品经常混用:先出计划,每一步内部再用 ReAct 循环。Claude Code 和 Cursor 里的「待办清单(todo list)」就是这种做法:模型先写待办,做完一项勾一项,中途可以增删。(这里描述的是产品的公开表现,不涉及内部实现。)
03反思:Reflexion
核心想法
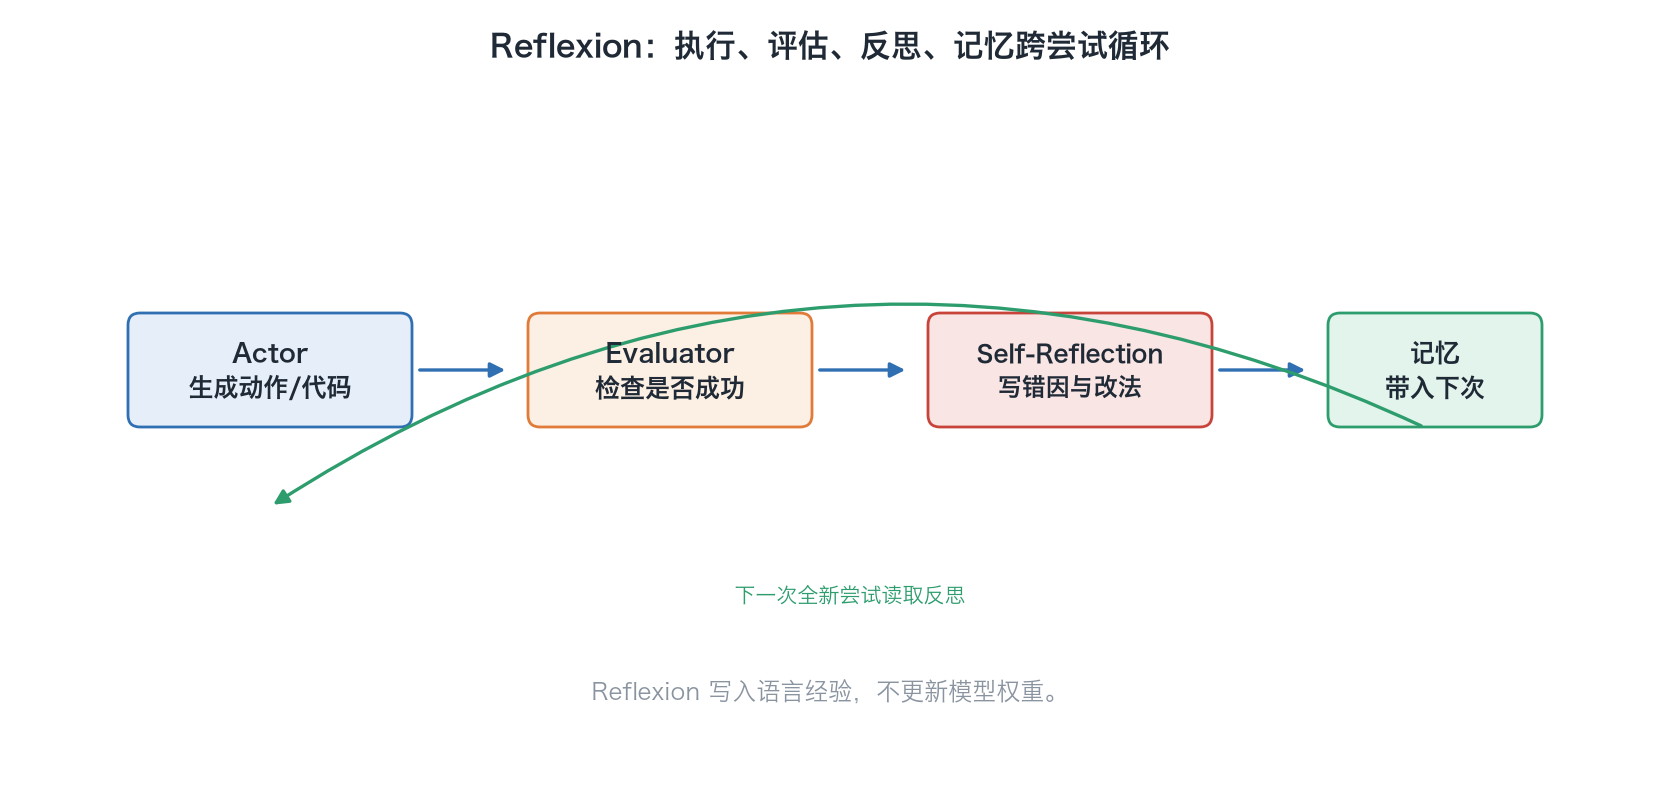
Shinn 等(2023)的 Reflexion,论文标题是「用语言做强化学习」。传统强化学习靠大量试错更新模型权重,又贵又慢。Reflexion 不改权重,而是:
- 让 Agent 试一次;
- 拿到反馈(成功或失败,或者单元测试报错);
- 让模型用文字写一段反思:错在哪、下次怎么改;
- 把反思存进记忆,下一次尝试时放进上下文。
论文的说法是:反思像一个「语义梯度」,给出改进的具体方向。
三个部件
| 部件 | 论文名 | 做什么 |
|---|---|---|
| 执行者 | Actor | 生成动作或代码(可以是 ReAct、CoT) |
| 评估者 | Evaluator | 给这次尝试打分:对还是错 |
| 自我反思 | Self-Reflection | 把失败轨迹和分数变成一段文字建议 |
再加一个记忆:存最近几条反思。论文说上限 Ω 通常设为 1–3 条,因为上下文窗口有限。在 AlfWorld 实验里,他们只保留最近 3 条。
演示:写函数时的一轮反思(示意)
任务:写函数 median(nums) 返回中位数。
第 1 次尝试:Actor 写出 sorted(nums)[len(nums)//2]。评估:Agent 自己写的测试 median([1,2,3,4]) == 2.5 没通过,返回了 3。反思(存入记忆):
我没处理偶数长度的情况。偶数个元素时,中位数是中间两个数的平均值。下次要先判断长度奇偶。
第 2 次尝试:Actor 读到这条反思,写出分奇偶的版本,测试通过。
注意第 2 次是全新的一次尝试,不是在第 1 次的代码上打补丁。第 1 次留下的只有那段文字。
和第 20 讲(程序辅助与自我改进) Self-Refine 的区别
| Self-Refine(第 20 讲(程序辅助与自我改进)) | Reflexion | |
|---|---|---|
| 改的对象 | 同一份输出,一稿一稿地改 | 整个下一次尝试 |
| 反馈来源 | 模型自己评 | 可以是环境、测试、启发式规则或模型 |
| 记忆 | 本次改稿历史 | 跨尝试保存的反思 |
| 典型场景 | 写作、改代码风格 | 需要多次试错的任务(游戏环境、编程) |
论文结果
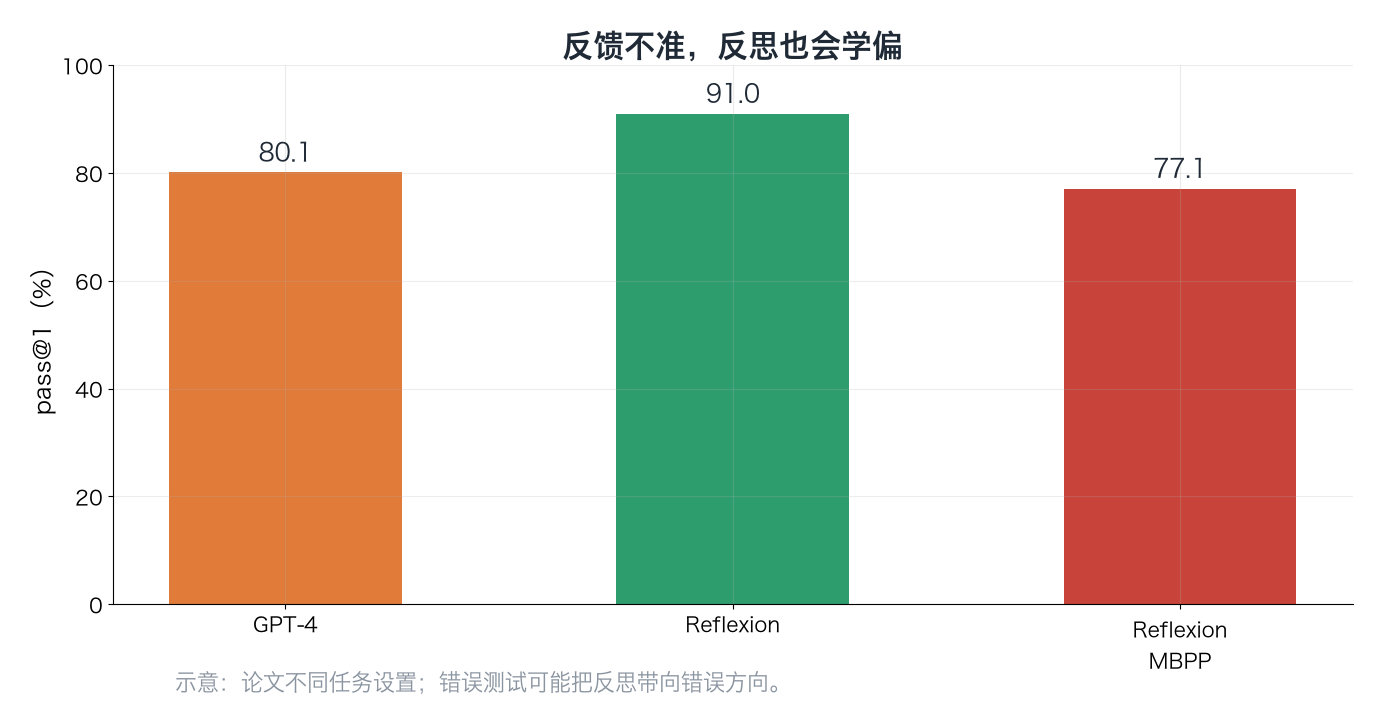
- 编程:HumanEval(Python)pass@1 达到 91.0%,当时的 GPT-4 是 80.1%。
- 决策:AlfWorld 134 个任务里,ReAct + Reflexion 完成了 130 个。只用 ReAct 时,第 6 到第 7 次尝试之间就不再进步。
- 论文摘要的汇总说法:比强基线高 AlfWorld 22%、HotPotQA 20%、HumanEval 11%(都是绝对值)。
图里有个反例值得看:MBPP Python 上 Reflexion(77.1)反而低于 GPT-4(80.1)。论文的解释是:Agent 自己写的测试有假阳性,测试本身错了却显示「通过」。MBPP Python 的假阳性率是 16.3%,HumanEval Python 只有 1.4%。
这一点很重要:反思的质量取决于反馈的质量。评估信号不准,反思就会朝错的方向「学习」。
局限(论文自己写的)
- 本质上仍是策略优化,可能卡在局部最优。
- 记忆只是一个有容量上限的滑动窗口。
- 很多代码难写准确的测试:不确定输出、调外部 API、并发等。
04重规划:计划和反思合在一起
把两节内容合起来看,一个能自我纠正的 Agent 有两个层次的循环:
| 层次 | 什么时候触发 | 改什么 |
|---|---|---|
| 步骤内(ReAct,第 30 讲(ReAct:边想边做)) | 每次工具调用之后 | 下一个动作 |
| 计划层(重规划) | 某一步失败,或者出现新信息 | 剩下的步骤清单 |
| 尝试层(Reflexion) | 整次任务失败 | 下一次整体尝试的思路 |
演示:设计一个「重规划触发条件」清单
设计 Agent 时,可以明确写出何时重规划,不让模型自己随意决定(示意):
- 某一步连续失败 2 次 → 重规划这一步及之后的步骤;
- 工具返回「资源不存在」 → 重规划;
- 已用步数超过计划的 1.5 倍 → 停下,请人确认;
- 重规划超过 3 次 → 放弃,报告人类。
第 4 条很重要。Reflexion 论文在 AlfWorld 里用的也是简单的启发式规则:同一动作得到同样的结果超过 3 轮,或者动作数超过 30,就触发反思。有上限的循环才安全。错误恢复的更多做法在第 36 讲(权限、沙箱与错误恢复)展开。
05延伸阅读
06一分钟讲给别人
试着用自己的话讲一遍ReAct 走一步看一步,容易陷进细节、缺全局。先规划后执行把工作分成规划器、执行器和重规划:先列清单再执行,环境变了就改剩下的计划。它是业界叫法,学术上最接近的是 Plan-and-Solve 提示。Reflexion 不改模型权重,而是让 Agent 失败后用文字写反思,存进记忆(通常 1–3 条),下次带着反思重新尝试。它让 HumanEval 从 80.1% 升到 91.0%,AlfWorld 完成 130/134。但在 MBPP Python 上反而下降,因为自己写的测试有假阳性,反馈不准,反思就学偏。三层循环(步骤、计划、尝试)都要设上限。
7 道自测
先在心里答一遍,再展开对照。能说清理由,比答对数字更重要。
01Plan-and-Execute 有原始论文吗?学术上最接近的工作是什么?
02先规划后执行的三个角色分别做什么?为什么必须有重规划?
03举一个更适合 ReAct、不适合先规划的任务。
04Reflexion 的「强化学习」和传统强化学习最大的区别是什么?
05Reflexion 的三个部件和记忆各做什么?记忆为什么只存 1–3 条?
06为什么 Reflexion 在 MBPP Python 上反而不如 GPT-4?这对设计 Agent 有什么启示?
07Reflexion 和 Self-Refine 的主要区别是什么?
已看 0/7 题
练动手练习
先给一个你熟悉的非投资任务(例如整理一份长报告)写出 4–5 步计划,再故意加入一个“资料不存在”的变化,改写后续步骤。然后让任意 AI 聊天工具分别用 ReAct 和“先规划后执行”的方式回答同一个小问题,比较哪种更容易漏步骤;最后写下一条失败反思,看看它能否指导下一次尝试。
完成这一课
读完讲义、看完自测答案,这一课就算学完了。
- 读完讲义
- 看完全部自测
本课为投资者教育内容,案例数字均为示意,不构成任何投资建议,也不承诺收益。规则和费率会变,实际操作前请以交易所、监管机构和产品的最新公告为准。