01学完你能做到
知道多个 Agent 怎么分工协作,常见的两种组织方式,以及它为什么贵、哪里容易出问题。
第 27 讲(压缩与隔离)讲「隔离」时提过:子智能体在各自干净的窗口里干活,只交回总结。这节把它展开成完整的话题:什么时候用多个 Agent,怎么组织,代价是什么。
02为什么要多个 Agent
一个 Agent 把所有事揽在一个上下文里,会遇到三个问题:
- 窗口装不下:调研要读几十个网页,全塞进一个窗口会腐化(第 23 讲(上下文窗口与上下文腐化));
- 串行太慢:一个接一个搜,耗时长;
- 角色混在一起:同一个模型既写代码又审代码,容易「自己给自己放水」。
多智能体的思路和公司分部门一样:拆开、并行、各管一摊。
03两种组织方式
方式一:编排者-子智能体(Orchestrator–Subagents)
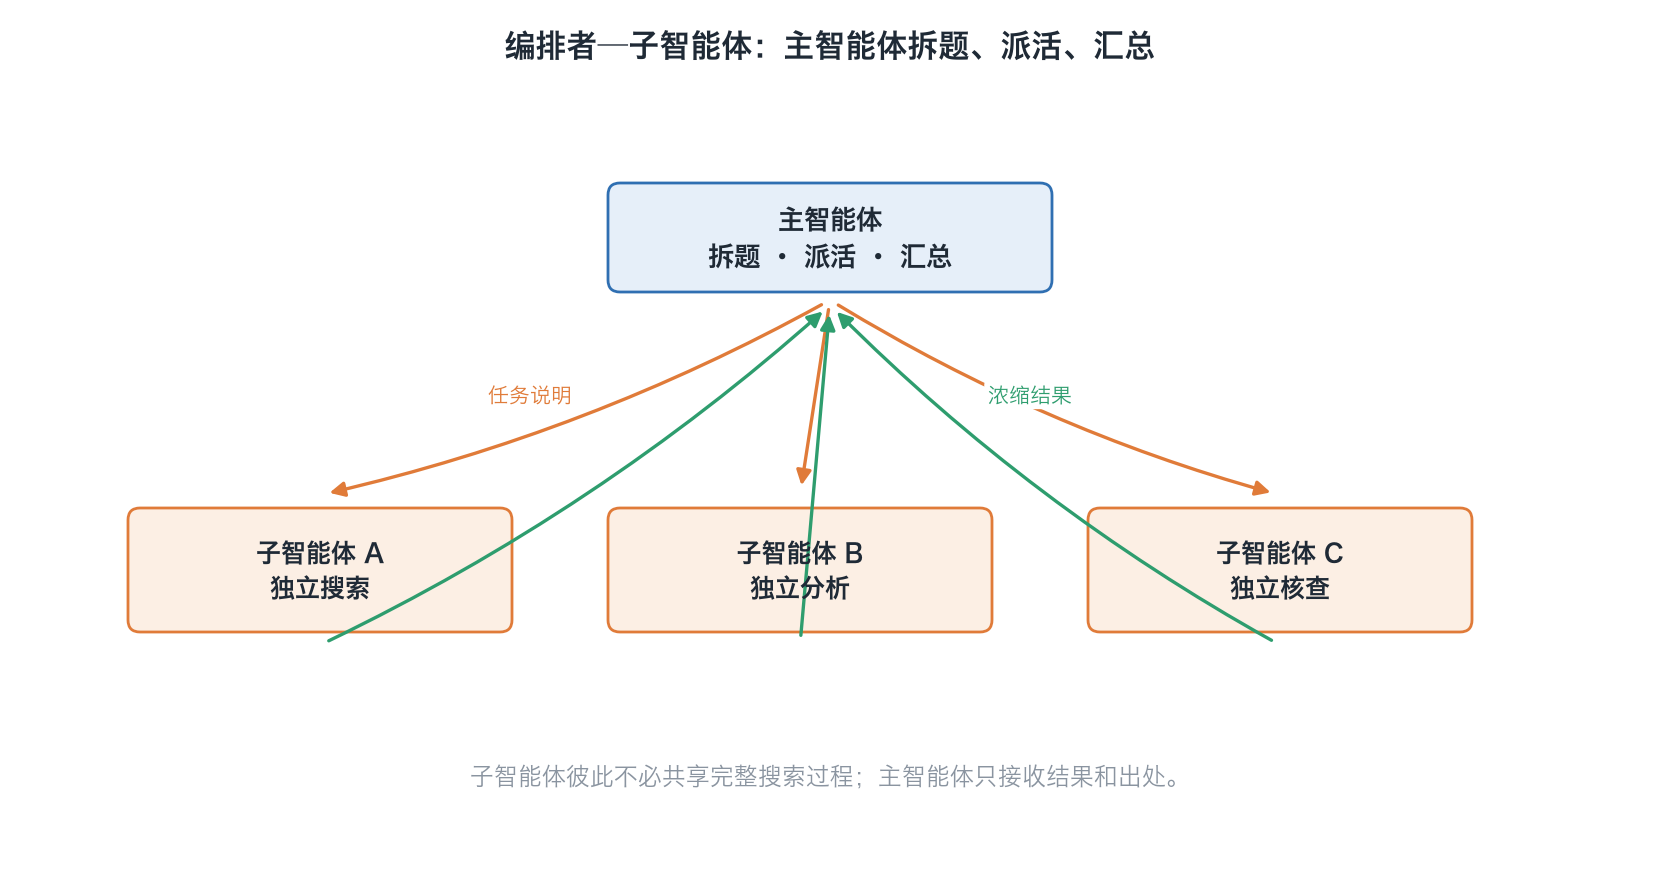
一个主智能体负责拆题、派活、汇总;多个子智能体各自独立完成一块,只把精简结果交回。子智能体之间不直接对话。
代表是 Anthropic 的研究系统(第 27 讲(压缩与隔离)讲过它的 90.2% 和 15 倍 token)。这节补充它在怎么派活上的经验:
- 主智能体给每个子智能体的任务说明要包含四样东西:目标、输出格式、该用哪些工具和来源、清楚的任务边界。
- 早期主智能体只给一句「研究一下半导体短缺」,结果子智能体理解偏了,或者几个子智能体做了一模一样的搜索:一个查 2021 年汽车芯片危机,另外两个重复调查 2025 年供应链,没有有效分工。
- 并行做法:主智能体同时起 3–5 个子智能体,每个子智能体同时调 3 个以上工具。复杂查询的研究时间最多缩短 90%。
方式二:对话式多智能体(Conversational)
几个 Agent 像开会一样互相发消息,通过对话推进任务。代表是微软的 AutoGen(Wu 等,2023)。
AutoGen 有两个核心概念:
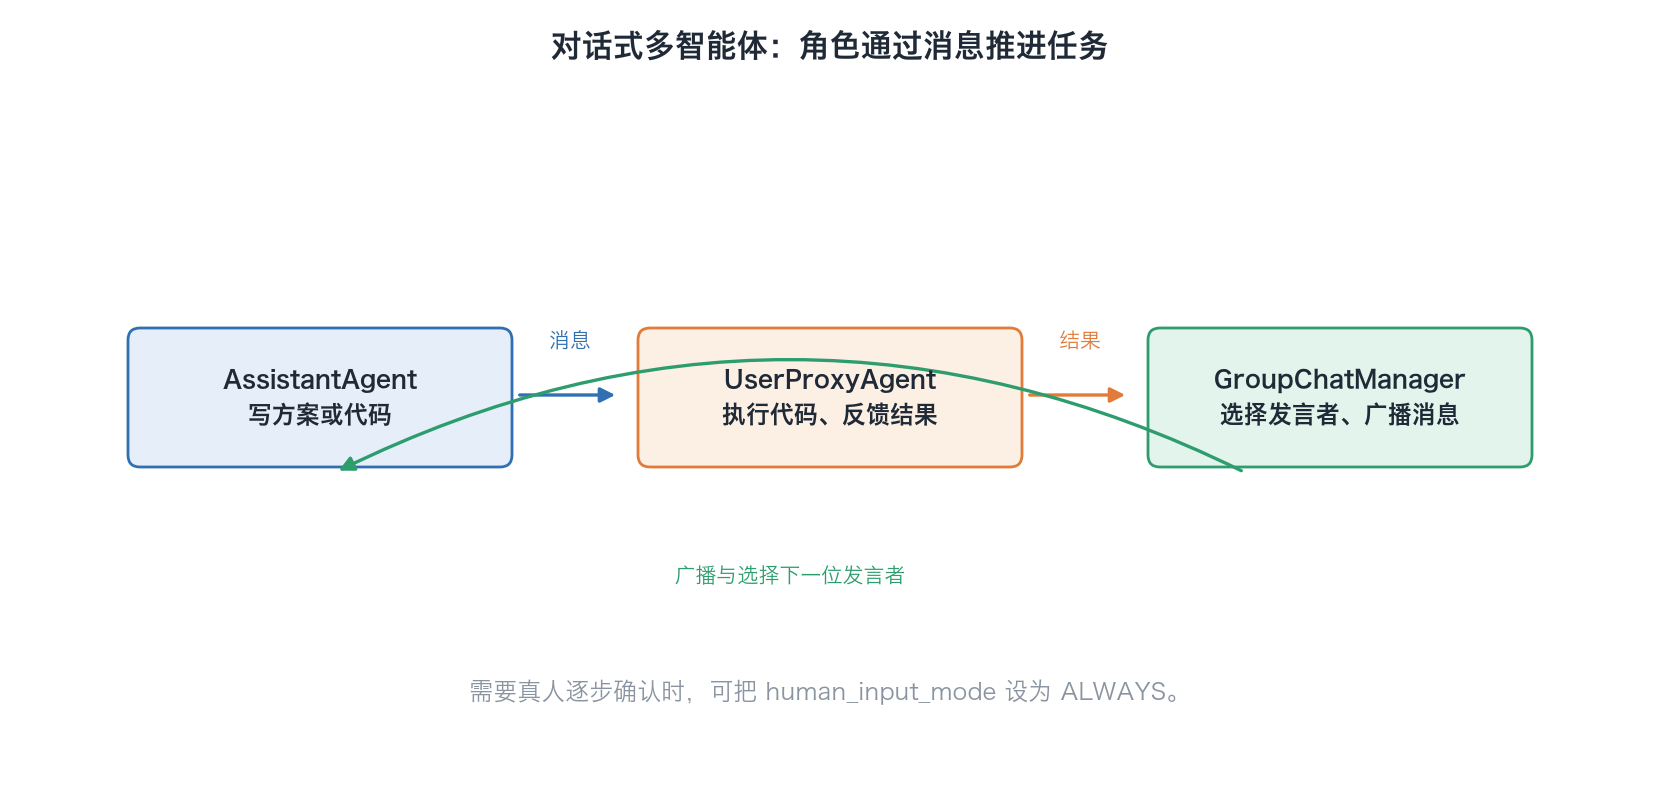
- 可对话智能体(conversable agent):每个 Agent 都能收发消息,背后可以是大模型、工具或真人,也可以是它们的组合。
- 对话编程(conversation programming):开发者只做两件事:① 定义有哪些 Agent、各自什么角色;② 规定它们怎么对话。
内置的两个常用角色:
| 角色 | 背后是 | 做什么 |
|---|---|---|
| AssistantAgent(助手) | 大模型 | 写方案、写代码 |
| UserProxyAgent(用户代理) | 真人和/或工具 | 执行代码、征求人的意见,把结果反馈给助手 |
更复杂时有 GroupChatManager(群聊管理器):动态挑选下一个发言者,再把他的发言广播给其他人。
演示:AutoGen 两个 Agent 的一段对话(示意)
任务:「画出今年 META 和 TESLA 股价涨幅对比图」(论文图 1 用的就是这类例子)。
- 用户代理 → 助手:画出 META 和 TESLA 今年的股价涨幅图。
- 助手:这是一段 Python 代码,用 yfinance 下载数据并画图。
- 用户代理(自动执行代码):报错,没有安装 yfinance。
- 助手:请先运行
pip install yfinance,再运行原代码。 - 用户代理(执行):成功,图已保存。
- 助手:完成。TERMINATE
中间没有人插手,靠的是 AutoGen 的自动回复机制:收到消息就自动生成回复,直到满足终止条件。把用户代理的 human_input_mode 设成 "ALWAYS",每一步都会先问真人,就变成了人在回路里。
论文里的一个例子:多智能体真比单智能体好吗
OptiGuide(供应链优化问答)用了三个角色:
- 指挥官:接用户问题,协调其他两个角色;
- 写手:写代码、解释结果;
- 安全员:检查代码是否安全。
流程:写手写代码 → 指挥官交给安全员检查 → 通过后执行 → 写手解释结果。安全员拦下了,就把问题打回给写手。
论文做了对照实验:让一个 Agent 同时负责写代码和审安全,和多 Agent 版本比较。测试集是 100 个编程任务,安全和不安全的各一半。多 Agent 版本识别不安全代码的 F1 分数,用 GPT-4 时高 8%,用 GPT-3.5-turbo 时高 35%。另外,核心工作流代码从 430 多行减到 100 行。
这个结果和第 28 讲(什么是 Agent)讲的「评估-优化」模式是一个道理:干活的和把关的分开,把关更严。第 36 讲(权限、沙箱与错误恢复)还会讲到 Anthropic 用独立评估者做 QA 的例子。
04代价:很费 token
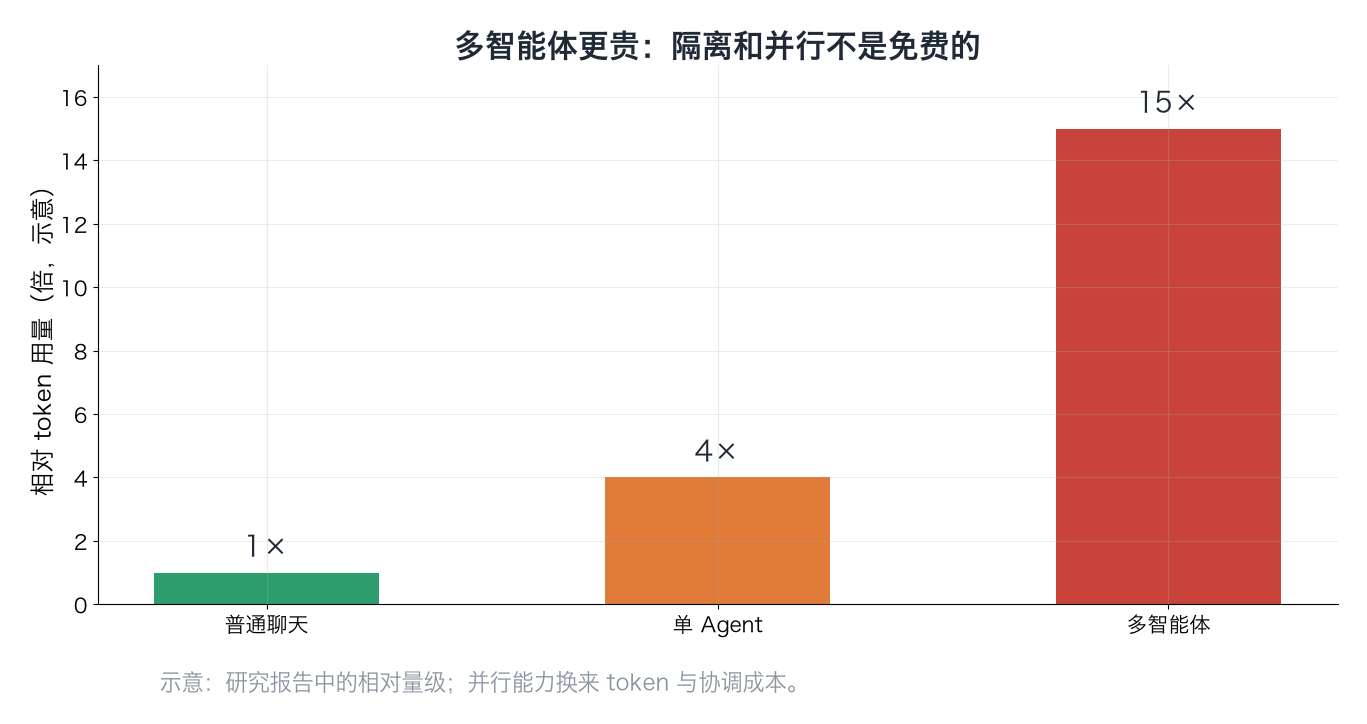
Anthropic 的数据(第 27 讲(压缩与隔离)已讲):单个 Agent 约用普通聊天 4 倍的 token,多智能体约 15 倍。他们还发现,在他们的评测里,token 用量本身就解释了 80% 的表现差异。多智能体好用,很大程度上是因为它能花更多 token。
所以要按任务难度分配投入。Anthropic 把下面的「投入分级」直接写进了主智能体的提示词:
| 任务类型 | 投入 |
|---|---|
| 简单查事实 | 1 个智能体,3–10 次工具调用 |
| 直接对比 | 2–4 个子智能体,每个 10–15 次调用 |
| 复杂研究 | 10 个以上子智能体,分工明确 |
演示:算一笔账(示意数字)
假设一次普通聊天花 2,000 token,模型价格按每百万 token 10 美元算:
- 普通聊天:2,000 × 10 / 1,000,000 = 0.02 美元
- 单 Agent(约 4 倍):8,000 token ≈ 0.08 美元
- 多智能体(约 15 倍):30,000 token ≈ 0.30 美元
一天 1 万次请求,多智能体比单 Agent 多花约 (0.30 − 0.08) × 10,000 = 2,200 美元/天。所以只有任务价值够高、而且确实能并行时才值得用。
05协调问题:常见失败
Anthropic 说多智能体的协调复杂度增长很快。他们早期遇到的错误:
- 一个简单问题起了 50 个子智能体;
- 没完没了地在网上找根本不存在的资料;
- 子智能体之间互相发太多更新,彼此干扰。
还有结构上的瓶颈:主智能体同步等待一批子智能体全部完成才继续。这让协调变简单,但主智能体无法中途纠偏,子智能体之间也不能协作,一个慢的会拖住全部。
| 失败 | 原因 | 对策 |
|---|---|---|
| 重复劳动、留空白 | 派活说明太模糊 | 写清目标、格式、工具、边界 |
| 简单题过度投入 | Agent 不会判断该花多少力气 | 把投入分级写进提示词 |
| 互相干扰 | 消息太多 | 只交回精简结果,限制通信 |
| 整体卡住 | 同步等待 | 设超时;未来可以改异步 |
| 错误累积 | 有状态、一步错步步错(第 28 讲(什么是 Agent)) | 检查点、可恢复(第 35、36 讲) |
什么时候不该用多智能体
第 27 讲(压缩与隔离)已经说过:子任务之间依赖多、需要共享大量上下文的任务(比如大多数编程任务)不适合拆。拆开以后,每个子智能体只看到局部,合起来容易对不上。
06延伸阅读
- Wu et al., AutoGen: Enabling Next-Gen LLM Applications via Multi-Agent Conversation, 2023:arxiv.org
- Anthropic, How we built our multi-agent research system, 2025-06-13:anthropic.com
07一分钟讲给别人
试着用自己的话讲一遍多智能体是把任务拆给多个 Agent:窗口更干净,可以并行,角色能分开。常见两种形态:编排者-子智能体(Anthropic 研究系统,主智能体派活、子智能体只交回结果);对话式(AutoGen,可对话智能体加对话编程,有助手、用户代理、群聊管理器)。把写代码和审安全分开,识别不安全代码的 F1 提高 8%(GPT-4)到 35%(GPT-3.5)。代价是 token:单 Agent 约 4 倍,多智能体约 15 倍,所以要按难度分级投入。常见失败有派活说明模糊导致重复劳动、过度投入、互相干扰、同步卡住。依赖多、需要共享上下文的任务不要拆。
7 道自测
先在心里答一遍,再展开对照。能说清理由,比答对数字更重要。
01多智能体解决单 Agent 的哪三个问题?
02编排者-子智能体和对话式多智能体的主要区别是什么?
03Anthropic 认为主智能体给子智能体的任务说明要包含哪四样东西?说明太模糊会怎样?
04AutoGen 里 AssistantAgent 和 UserProxyAgent 各做什么?怎么让每一步都由真人确认?
05OptiGuide 的对照实验说明了什么?
06多智能体为什么贵?Anthropic 怎么防止简单题过度投入?
07什么样的任务不适合拆成多智能体?
已看 0/7 题
练动手练习
选一个不涉及荐股或预测的小任务,例如比较两份公开公告的披露差异。先为一个主 Agent 写出 3 个彼此独立的子任务,规定每个子任务的目标、输出格式、资料来源和边界,再判断这个任务是否真的值得并行;最后估算如果多开 3 个 Agent,哪些重复劳动或通信成本可能出现。
完成这一课
读完讲义、看完自测答案,这一课就算学完了。
- 读完讲义
- 看完全部自测
本课为投资者教育内容,案例数字均为示意,不构成任何投资建议,也不承诺收益。规则和费率会变,实际操作前请以交易所、监管机构和产品的最新公告为准。