01学完你能做到
看懂一份工具定义(schema),说清「模型提出调用 → 程序执行 → 结果回传」这个循环,知道好工具该怎么设计。
02模型自己不会「执行」任何东西
模型通常输出文字或结构化调用请求。所谓「调用工具」,是模型输出一段格式固定的请求,比如「我要调用 get_fund_nav,参数是 000001」。真正执行的是你的程序。程序把结果再发回给模型,模型据此继续。
OpenAI 文档的定义是:函数调用(也叫工具调用)让模型能够连接外部系统,访问训练数据之外的数据。
为什么需要它?前面几节讲过模型的几个短板:知识有截止日期、会幻觉(第 15 讲(幻觉))、算术不可靠(第 20 讲(程序辅助与自我改进)用 PAL 让模型写程序来算)。工具调用让模型把这些事交给可靠的外部系统去做。
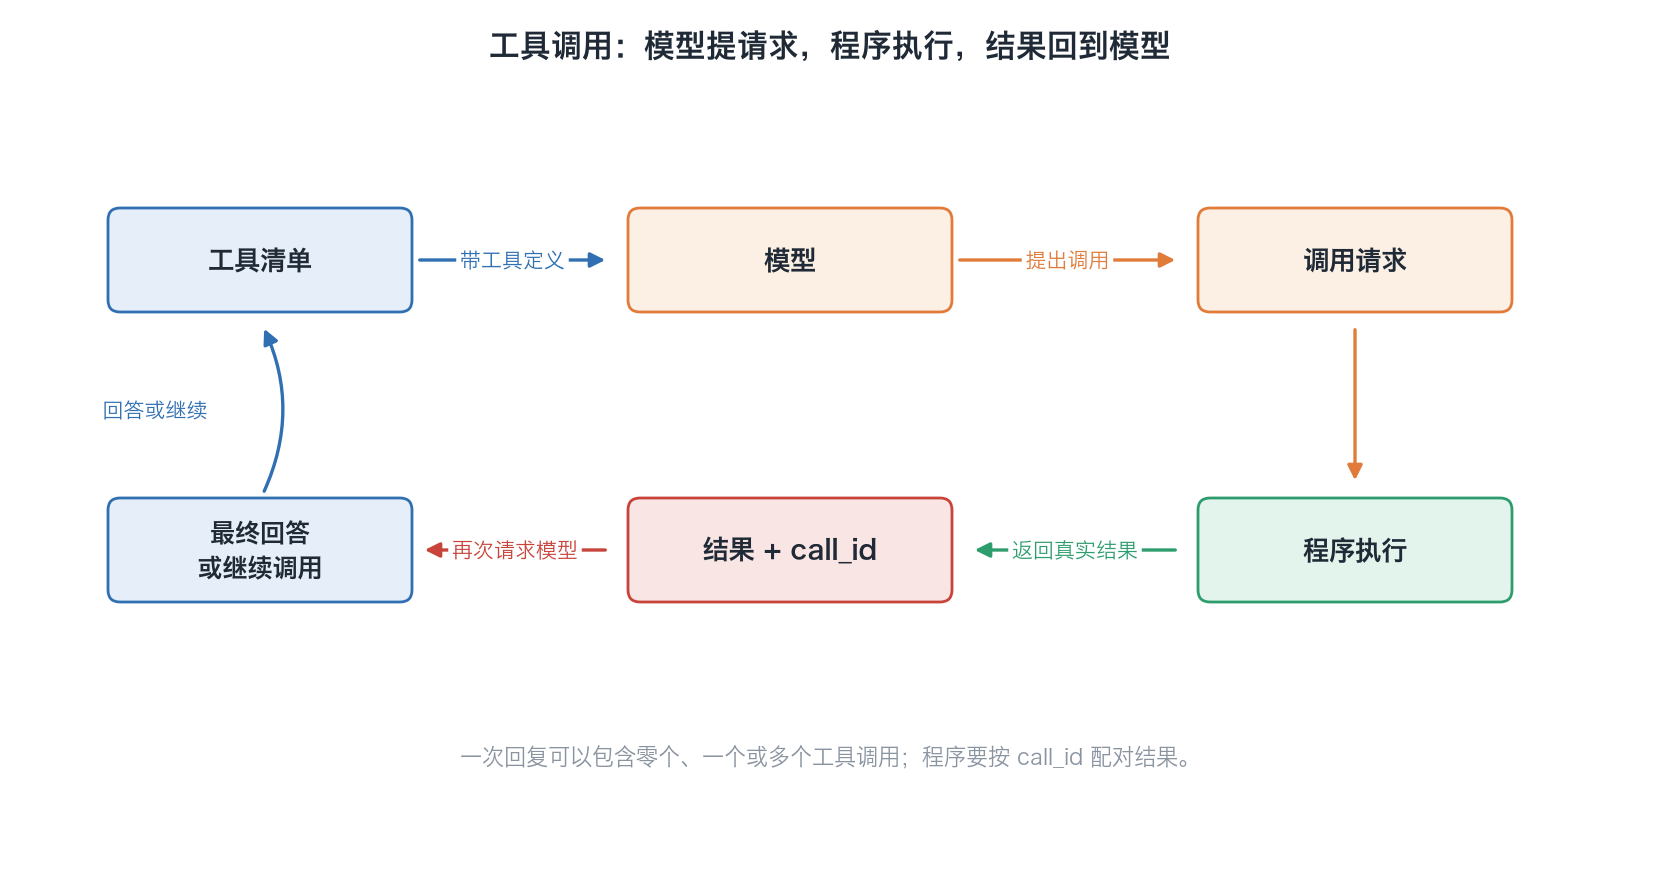
03五步循环
OpenAI 文档把流程写成五步:
- 带上可用工具清单向模型发请求;
- 模型返回一个工具调用(要调哪个、参数是什么);
- 你的程序拿这些参数执行代码;
- 带上工具结果再向模型发一次请求;
- 模型给出最终回答,或者继续发起新的工具调用。
第 5 步的「或者」就是第 28 讲(什么是 Agent)说的循环:只要模型还在要工具,程序就继续执行、回传,直到它给出回答,或者碰到轮数上限。
文档还提醒:一次回复里可能有零个、一个或多个调用,要按「可能有多个」来处理。每个调用都有一个 call_id,回传结果时要带上它,模型才知道哪个结果对应哪个调用。
04工具定义(schema)长什么样
一份函数工具定义有五个字段:type(固定为 function)、name、description、parameters(用 JSON Schema 描述参数,见第 21 讲(结构化输出))、strict(是否严格遵守 schema)。
演示:一次完整的「查基金净值」(示意)
① 程序发给模型的工具定义(照 OpenAI 文档的格式写的示意):
{
  "type": "function",
  "name": "get_fund_nav",
  "description": "查询某只公募基金最近一个交易日的单位净值。用户问净值、涨跌时使用;问基金经理、持仓时不要用。",
  "parameters": {
    "type": "object",
    "properties": {
      "fund_code": {"type": "string", "description": "6 位基金代码,例如 000001"},
      "date": {"type": ["string", "null"], "description": "日期 YYYY-MM-DD;不指定就填 null,表示最近一个交易日"}
    },
    "required": ["fund_code", "date"],
    "additionalProperties": false
  },
  "strict": true
}
用户问:「000001 现在净值多少?」
② 模型返回的不是回答,而是一个调用:
{"type": "function_call", "call_id": "call_abc", "name": "get_fund_nav",
 "arguments": "{\"fund_code\":\"000001\",\"date\":null}"}
③ 程序执行:解析参数,查数据库,得到 {"name":"示例基金","date":"2026-10-30","nav":1.2345}。
④ 程序回传:
{"type": "function_call_output", "call_id": "call_abc",
 "output": "{\"name\":\"示例基金\",\"date\":\"2026-10-30\",\"nav\":1.2345}"}
⑤ 模型回答:「000001(示例基金)在 2026-10-30 的单位净值是 1.2345。」
(基金名、日期、净值为示意。)
严格模式:strict: true 让调用可靠地符合 schema,不是「尽量符合」。它基于第 21 讲(结构化输出)讲的结构化输出,因此有两条要求:每个对象都要设 additionalProperties: false;所有字段都要列进 required。可选字段的写法是在类型里加上 null,就像上面的 date。OpenAI 建议始终打开严格模式。
几个开关:
tool_choice:默认auto,由模型决定调不调、调几个;也可以设成required(必须调用)、指定某个函数,或者none(不调用);parallel_tool_calls: false:每轮最多只调用一个工具。
工具定义也占 token:文档说,函数定义会被放进系统消息,计入上下文长度,也按输入 token 计费。工具越多,越占地方。
05怎样设计好工具
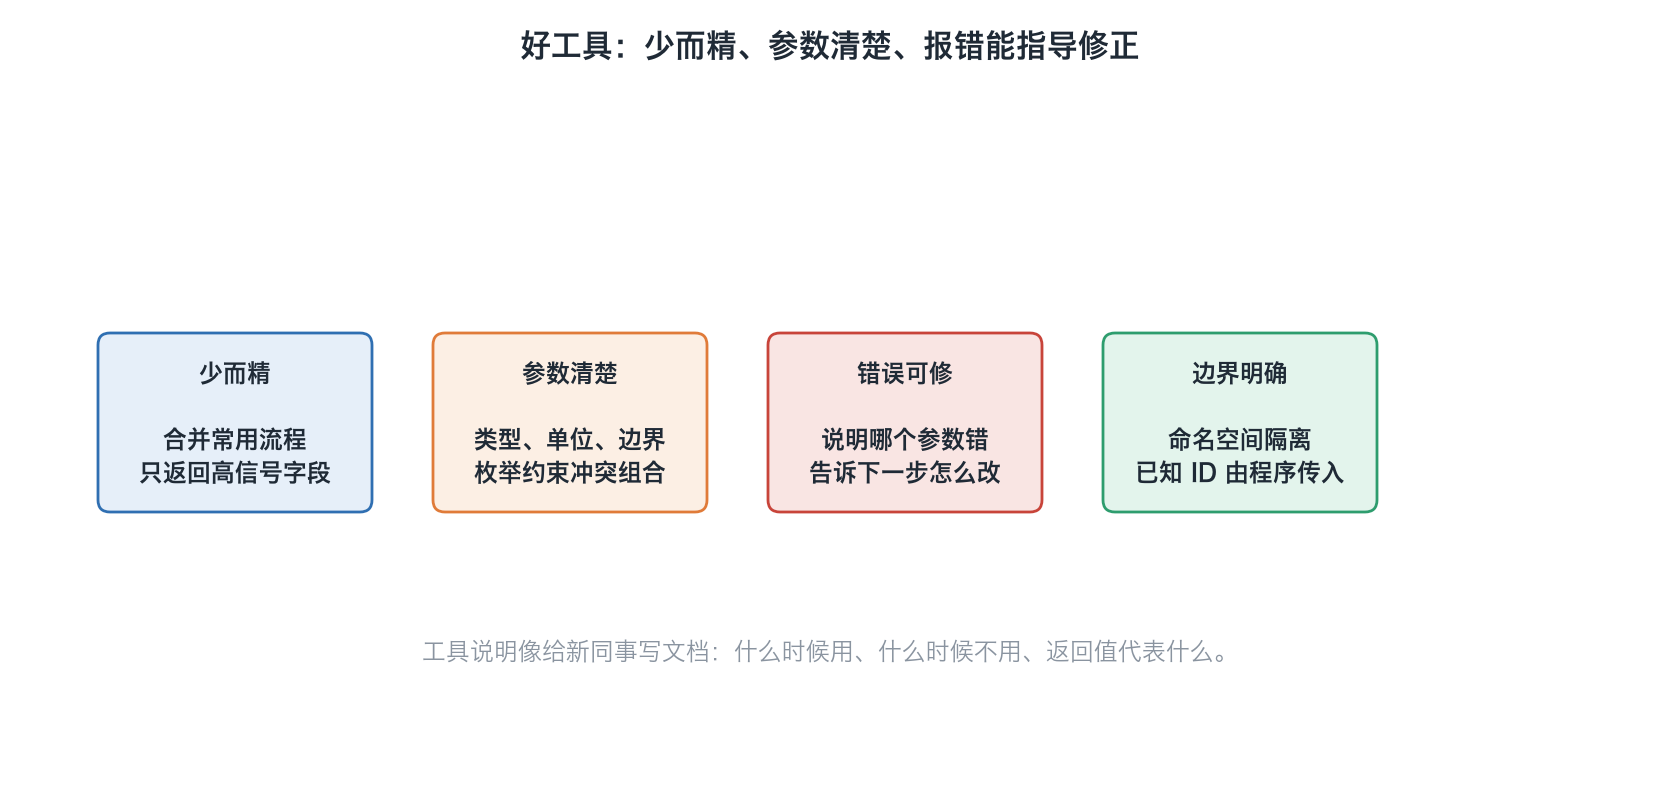
Anthropic 的《Writing effective tools for agents》(2025 年 9 月)开头讲了一个关键观点:传统函数是确定性系统之间的约定,同样的输入每次都得到同样的结果;而工具是确定性系统和不确定的智能体之间的约定。用户问「今天要带伞吗?」,智能体可能调天气工具,也可能凭常识回答,还可能先问你在哪。所以工具要专门为智能体设计,不能照搬给程序员用的 API。
下面把 Anthropic 文章和 OpenAI 文档的建议合在一起:
| 原则 | 说明 | 出处的例子 |
|---|---|---|
| 不要只是把 API 包一层 | 智能体的上下文有限。返回全部数据,它就得一个 token 一个 token 地读 | 不做 list_contacts,做 search_contacts |
| 把常一起做的事合并 | 一个工具在内部完成多步操作 | 用 schedule_event 代替 list_users • list_events • create_event;OpenAI:总是先 query 再 mark 的,就合成一个 |
| 用命名空间分清边界 | 工具多了容易混淆,按服务或资源加前缀 | asana_search、jira_search |
| 只返回有用的信息 | 去掉 uuid、mime_type 这类底层字段;把随机 ID 换成有意义的名字 | 可以加 response_format 参数选 concise 或 detailed:同一个 Slack 线程,详细版 206 token,精简版 72 token,约省 2/3 |
| 控制返回长度 | 分页、过滤、截断,并设合理的默认值 | Claude Code 默认把工具返回限制在 25,000 token |
| 报错要有用 | 告诉模型哪里错了、怎么改,不要只给错误码 | — |
| 参数名不要有歧义 | 写清楚类型和格式 | 参数不叫 user,叫 user_id |
| 像给新同事写说明一样写描述 | 把隐含的背景、术语、格式写明白 | OpenAI 的「实习生测试」:只看你给模型的信息,实习生能用对吗? |
| 让错误状态无法表达 | 用枚举和结构约束参数 | OpenAI:toggle_light(on: bool, off: bool) 允许 on 和 off 同时为真,是坏设计 |
| 已知的参数别让模型填 | 程序已经知道的值,直接在代码里传 | OpenAI:已有 order_id 时,定义无参数的 submit_refund() |
| 一开始的工具少一点 | OpenAI 的软建议是每轮开始时少于 20 个;多了用工具搜索按需加载 | — |
两个真实案例(来自 Anthropic 文章):
- 推出网页搜索工具时,他们发现 Claude 总是没必要地在搜索词后面加「2025」,搜索结果因此有偏差。改进工具描述后解决了;
- 对工具描述做了精确的修改后,Claude Sonnet 3.5 在 SWE-bench Verified 上达到当时最好的成绩。
演示:一条「有用的报错」如何让模型自己纠正(示意)
- 模型调用
get_fund_nav(fund_code="华夏成长"),传的是基金名,不是代码。 - 差的返回:
Error 400。模型不知道错在哪,可能原样重试,陷入循环。 - 好的返回:「fund_code 需要 6 位数字代码,你传的是基金名称。可以先用 search_fund(name=...) 查代码。」
- 模型改为调用
search_fund(name="华夏成长"),拿到代码后再查净值。
06模型是怎么学会用工具的:Toolformer
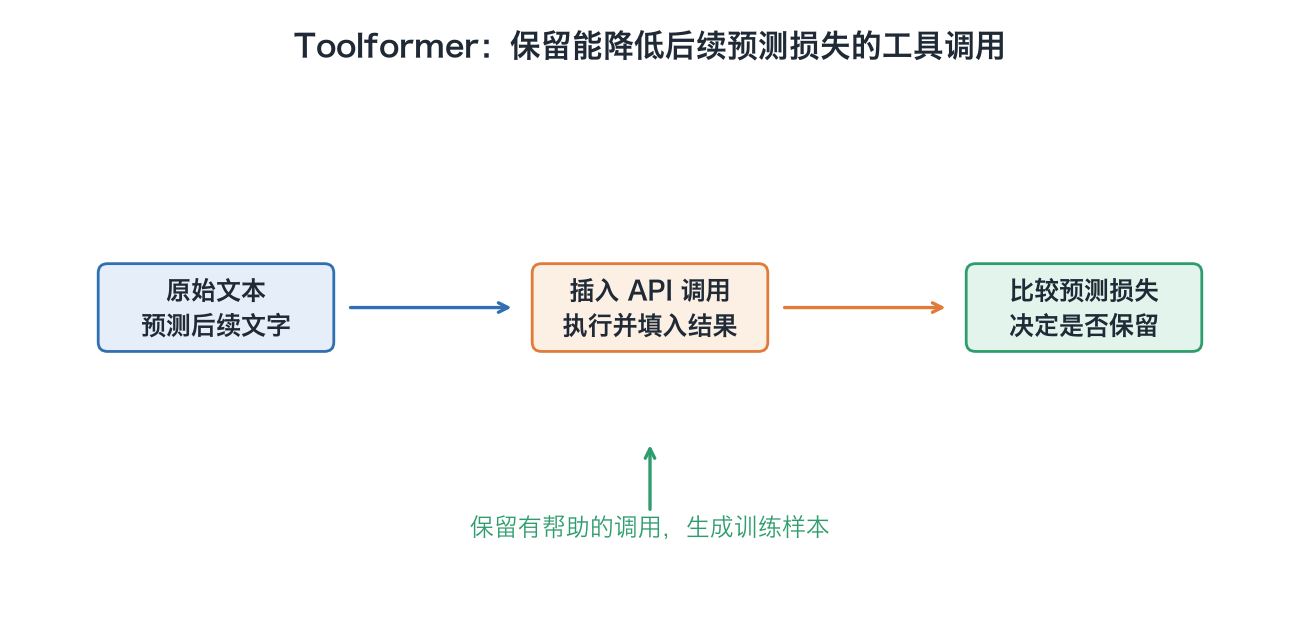
现在的模型通过专门训练学会了工具调用。早期一个有代表性的工作是 Toolformer(Schick 等,2023)。它让模型自己教自己:
- 在普通文本里,让模型试着插入 API 调用,比如论文图 1 里,在「1400 名参与者中有 400 人(即 29%)通过」这句话中插入计算器调用 400 / 1400;
- 真的执行这些调用,拿到结果;
- 只保留那些「把结果插进去之后,后面的文字更容易预测」的调用(损失下降超过一个阈值);
- 用保留下来的数据微调模型。
它基于 67 亿参数的 GPT-J,工具有问答、维基百科搜索、计算器、日历、机器翻译。
在三个数学应用题数据集上,67 亿参数的 Toolformer 远超 1750 亿参数的 GPT-3:ASDiv 40.4 对 14.0,SVAMP 29.4 对 10.0,MAWPS 44.0 对 19.8。论文说在 97.9% 的例子里它都用了计算器。还有一个对照值得看:同一个 Toolformer 如果禁止调用工具,三项只有 14.8、6.3、15.0,比原版 GPT-J(7.5、5.2、9.9)略好,说明微调本身带来一点数学能力,但大头的提升来自真的去调用计算器。规模更小的模型(低于约 7.75 亿参数)学不会有效地用工具。
论文自己列出的局限:不能把多个工具串起来用;不能根据结果交互式地改写查询;推理时每个输入最多调用一次。这些正是后来「工具调用 + 循环」的智能体要解决的问题,也就是第 28 讲(什么是 Agent)和第 30 讲(ReAct:边想边做)的内容。
07延伸阅读
- OpenAI, Function calling 指南:platform.openai.com
- Anthropic, Writing effective tools for agents — with agents, 2025-09-11:anthropic.com
- Schick et al., Toolformer: Language Models Can Teach Themselves to Use Tools, 2023:arxiv.org
08一分钟讲给别人
试着用自己的话讲一遍模型自己不执行任何东西,它只输出一个格式固定的调用请求,由程序执行,再把结果回传。流程是五步:带工具清单请求、模型返回调用、程序执行、带结果再请求、模型回答或继续调用。工具定义包括名字、描述、用 JSON Schema 写的参数和 strict 开关;严格模式要求关闭额外字段、所有字段必填,可选字段用 null 表示。工具要为智能体设计:少而精、合并常用流程、用命名空间、只返回有用信息、控制长度、报错要可操作、描述要写得像给新同事看。Toolformer 用「插入结果后能否让后文更好预测」来自学用工具,67 亿参数在数学题上超过了 GPT-3,但不会串联工具。
6 道自测
先在心里答一遍,再展开对照。能说清理由,比答对数字更重要。
01工具调用时,真正执行函数的是谁?
02回传结果时为什么要带 call_id?
03严格模式下,一个可选参数应该怎么写?
04为什么 `search_contacts` 比 `list_contacts` 更适合智能体?
05请把「Error 400」改写成一条对模型有用的报错,场景是日期格式写错。
06Toolformer 用什么标准决定保留哪些 API 调用?它有什么局限?
已看 0/6 题
练动手练习
为“查询一只基金最近净值”设计一个最小工具:写出名称、用途、参数类型和一个可选参数。再把“Error 400”改成能告诉模型哪里错了、下一步该调用什么的具体报错。
完成这一课
读完讲义、看完自测答案,这一课就算学完了。
- 读完讲义
- 看完全部自测
本课为投资者教育内容,案例数字均为示意,不构成任何投资建议,也不承诺收益。规则和费率会变,实际操作前请以交易所、监管机构和产品的最新公告为准。