01学完你能做到
理解「先检索再生成」。
02为什么需要 RAG
第 15 讲(幻觉)讲过,模型会产生幻觉,而且它的知识停留在训练数据截止那一刻。公司内部的制度、昨天发布的公告、客户的合同,它都不知道。
有两条路可以让模型「知道」这些信息:
- 微调(第 10 讲(指令微调 SFT 与 LoRA)):把知识训练进模型参数里。代价高,更新慢,也难以追溯答案出自哪里;
- RAG(Retrieval-Augmented Generation,检索增强生成):回答前先从资料库里检索相关段落,放进上下文,再让模型基于这些资料生成回答。
RAG 这个名字来自 Lewis 等人 2020 年的论文。论文把两种记忆结合起来:
- 参数记忆:一个预训练的生成模型;
- 非参数记忆:一个维基百科的向量索引。
在三个开放域问答任务上,它取得了当时的最好成绩,生成的内容也比只靠参数的模型更具体、更符合事实。
用 RAG 的好处:
- 资料更新时只需更新资料库;
- 回答可以附上出处;
- 可以按权限控制谁能检索到什么。
- 1准备资料库保存外部知识
- 2检索相关段落回答前查资料
- 3拼入上下文保留出处和权限
- 4生成回答资料不足就说明
03两条流水线
离线:建索引(资料变化时才运行)
- 加载:读入文档,比如 PDF、网页、知识库;
- 切片:把长文档切成小段;
- 向量化:用嵌入模型把每段变成一个向量;
- 入库:把向量和对应文本存进向量数据库。
在线:每次提问时
- 把用户的问题也变成向量;
- 在库里找出和问题向量最「接近」的 k 段;
- 把这 k 段和问题一起拼进提示词,例如:「请只根据以下资料回答,资料里没有就说不知道,并标注出处」;
- 模型生成回答。
- 1加载文档离线准备
- 2切片并向量化形成可检索表示
- 3问题检索 top-k在线取相关段落
- 4拼入上下文生成保留出处
04向量和相似度
第 4 讲(词向量与语言模型)讲过词向量:意思相近的词,向量也相近。嵌入模型(embedding model)把这个思路扩展到整句、整段话:输入一段文字,输出一个几百到几千维的向量。
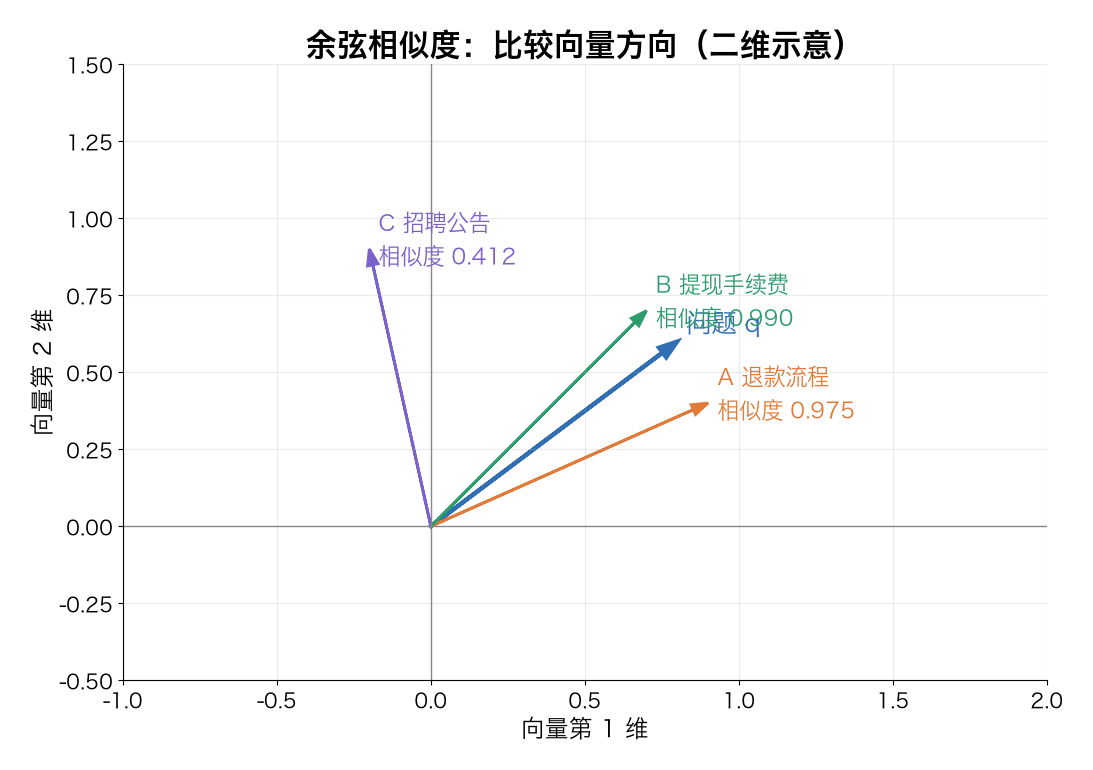
怎么判断两个向量「接近」?最常用的是余弦相似度:比较两个向量的方向是否一致,结果在 -1 到 1 之间,越接近 1 越相似。
余弦相似度 = (a · b) / (|a| × |b|)
其中 a · b 是对应位置相乘再相加,|a| 是向量的长度。
手算演示(为了能画在纸上,用 2 维向量示意。真实向量有几百维,数字为示意)
用户问题「提现要多少手续费?」的向量是 q = (0.8, 0.6),长度是 1。库里有三段:
| 段落 | 向量 | 计算 | 余弦相似度 |
|---|---|---|---|
| A 退款流程 | (0.9, 0.4) | (0.72 + 0.24) / (1 × 0.9849) | 0.975 |
| B 提现手续费说明 | (0.7, 0.7) | (0.56 + 0.42) / (1 × 0.9899) | 0.990 |
| C 招聘公告 | (−0.2, 0.9) | (−0.16 + 0.54) / (1 × 0.9220) | 0.412 |
(|A| = √(0.81 + 0.16) = √0.97 ≈ 0.9849,|B| = √0.98 ≈ 0.9899,|C| = √(0.04 + 0.81) = √0.85 ≈ 0.9220。)
取 top-2:B 和 A。招聘公告离得很远,被排除了。
也要注意,A「退款流程」的分数和 B 很接近。向量检索找的是「意思相近」,不是「一定相关」。这也是第 25 讲(RAG 进阶与常见失败)要讲的检索失败的来源之一。
Karpukhin 等人 2020 年的 DPR 论文表明,训练得好的稠密向量检索,在 top-20 段落准确率上比传统关键词检索 BM25 高 9–19 个百分点。
05切片:块多大、要不要重叠
切片大小要权衡:
- 太大:一块里混着好几个主题,向量变得「模糊」,也占更多上下文;
- 太小:一句话被切断,丢失前后文,比如「该费用」到底指什么费用。
常见做法:
- 按段落、标题等自然边界切;
- 相邻块之间留一点重叠,比如每块 500 字,前后重叠 50 字,避免关键句子正好被切在边界上。
块大小没有通用最优值,要用自己的数据测(第 38 讲(评测)讲评测)。
- 1识别自然边界标题和段落优先
- 2切成多个区块控制主题范围
- 3保留适度重叠减少边界损失
06混合检索与 RRF
向量检索擅长「意思相近」,但对精确词不敏感,比如产品型号「X-200」、错误码「E1043」、人名。关键词检索(如 BM25)恰好相反。所以实践中常把两者结合,叫混合检索。
两路结果怎么合并?常用的方法是 RRF(倒数排名融合):每一路里排第 r 名的文档得 1/(k + r) 分,各路得分相加。k 通常取 60。
手算演示(k = 60):
- 向量检索排名:A、B、C
- 关键词检索排名:B、D、A
| 文档 | 向量路 | 关键词路 | 总分 |
|---|---|---|---|
| B | 1/62 = 0.01613 | 1/61 = 0.01639 | 0.03252 |
| A | 1/61 = 0.01639 | 1/63 = 0.01587 | 0.03227 |
| D | — | 1/62 = 0.01613 | 0.01613 |
| C | 1/63 = 0.01587 | — | 0.01587 |
B 在两路都排得靠前,最终第一。RRF 只用排名、不用原始分数,所以不必担心两种检索的分数尺度不同。
k 为什么是 60? 原论文说,k = 60 是在一次小规模试验里定下的,之后的验证中没有再调整,实验也显示 60 接近最优。k 的作用是「压平」排名差距:k 越大,第 1 名和第 10 名的分数差越小,一路里排第一的文档就不容易单凭这一路压过其他文档。论文的直觉是:排名靠前的文档更重要,但排名靠后的文档重要性不应该像指数衰减那样快速消失。
- 向量检索擅长语义相近
- 关键词检索擅长精确字符串
- RRF 合并按排名融合
07延伸阅读
- Lewis et al., Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, 2020:arxiv.org
- Karpukhin et al., Dense Passage Retrieval for Open-Domain Question Answering, 2020:arxiv.org
- Cormack, Clarke & Büttcher, Reciprocal Rank Fusion outperforms Condorcet and individual rank learning methods, SIGIR 2009 :cormack.uwaterloo.ca
- Datawhale hello-agents,第八章「记忆与检索」:github.com
08一分钟讲给别人
试着用自己的话讲一遍RAG 是先检索再生成:回答前从资料库里取出相关段落放进上下文,以此减少幻觉、更新知识、给出出处。离线流程是加载、切片、向量化、入库;在线流程是把问题向量化,取最相似的 k 段,拼进提示词后生成回答。相似度常用余弦相似度,比较两个向量的方向。切片要大小适中,相邻块留重叠。向量检索和关键词检索各有长处,混合后可以用 RRF 按排名合并。
5 道自测
先在心里答一遍,再展开对照。能说清理由,比答对数字更重要。
01RAG 相对于微调有哪些优点?
02问题向量 q = (1, 0),段落向量 p = (0.6, 0.8),余弦相似度是多少?
03切片太大和太小分别有什么问题?
04为什么查错误码「E1043」时,关键词检索可能比向量检索更好?
05用 RRF(k = 60)合并:某文档在第一路排第 1,第二路没出现;另一文档在两路都排第 3。谁的分数高?
已看 0/5 题
练动手练习
找一份包含几个具体事实的公告或研报,先直接问 AI 一个细节问题,再把相关段落贴进对话并要求“只根据资料回答、标注出处”。比较两次答案,并指出资料库、切片、检索和生成分别可能在哪一步出错。
完成这一课
读完讲义、看完自测答案,这一课就算学完了。
- 读完讲义
- 看完全部自测
本课为投资者教育内容,案例数字均为示意,不构成任何投资建议,也不承诺收益。规则和费率会变,实际操作前请以交易所、监管机构和产品的最新公告为准。