01学完你能做到
理解「会思考」的模型是怎么训练出来的。
02什么是推理模型
普通聊天模型拿到问题就开始输出答案。推理模型(如 OpenAI o1 系列、DeepSeek-R1)会先生成一段很长的思考过程:列步骤、尝试、发现错误、回头检查,然后才给出答案。
对比演示:「一个数的 3 倍加 7 等于 34,这个数是几?」
普通模型(直接答,偶尔会错):
答案是 8。
推理模型(先思考):
<think>设这个数为 x。3x + 7 = 34,所以 3x = 27,x = 9。验证:3×9 + 7 = 34,对。</think>
答案是 9。
关键点不在于「会写步骤」(第 18 讲(思维链 CoT)的思维链提示也能做到),而在于:这种思考习惯是通过强化学习练出来的,模型会自发地检查、回溯、换方法。
03可验证奖励:不需要人打分的 RL
第 11 讲(RLHF:用人类反馈训练模型)的 RLHF 依赖奖励模型,而奖励模型会被「钻空子」。数学题和编程题有个好特点:答案可以自动检查。
- 数学:最终答案和标准答案是否一致;
- 代码:能否通过测试用例。
这叫可验证奖励(RLVR)。规则打分很难被钻空子,于是可以放心地大规模训练。
DeepSeek-R1-Zero 用的奖励就两种(论文中的设定):
- 准确性奖励:答案对不对;
- 格式奖励:思考过程是否放在
<think>和</think>之间。
它完全没有用 SFT 起步,直接对基座模型做强化学习。
04GRPO:组内相对比较
传统的 PPO 需要一个和策略模型差不多大的「价值模型」来估计每个回答的好坏基准,很占显存。DeepSeekMath 提出的 GRPO(组相对策略优化)用一个简单办法代替:
同一道题采样一组回答,用组内平均分当基准。
数值演示
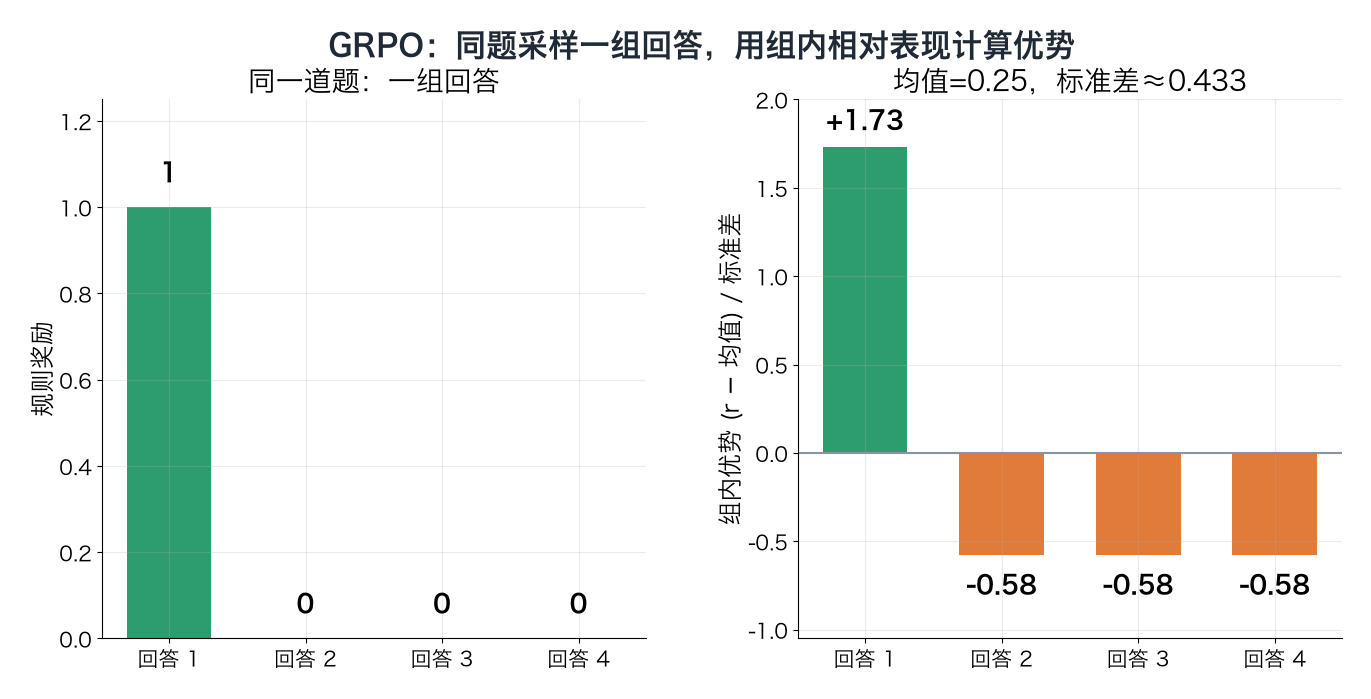
题目:12 × 13 = ?,采样 4 个回答,答对得 1 分。
- 回答 1:156(对)→ 奖励 1
- 回答 2、3、4:146、166、136(错)→ 奖励 0
计算优势(advantage,「比平均水平好多少」):
- 组均值 = (1+0+0+0)/4 = 0.25
- 组标准差 = √[((0.75)² + 3×(0.25)²)/4] = √(0.1875) ≈ 0.433
- 优势 = (奖励 − 均值) / 标准差
- 回答 1:(1 − 0.25)/0.433 ≈ +1.73
- 回答 2–4:(0 − 0.25)/0.433 ≈ −0.58
然后提高优势为正的回答中每个 token 的概率,降低优势为负的回答。和 PPO 一样,GRPO 也会限制每次更新的幅度(裁剪),并加一项 KL 惩罚,让模型别离参考模型太远(第 11 讲(RLHF:用人类反馈训练模型))。省掉的只是那个和策略模型一样大的价值模型。
对比另一种情况:如果 4 个都答对(全是 1),均值 1,优势全是 0,这道题什么也学不到。太简单或太难(全错)的题都没有学习信号,所以训练题目的难度要合适。
- 1同题采样生成一组回答
- 2规则评分得到每个奖励
- 3组内标准化算相对优势
- 4更新策略提高正优势回答
回到第 1 步:换下一道题继续采样
模型学习的是比同组平均好多少,而不是一个绝对分数。
05R1-Zero 的发现
论文报告:
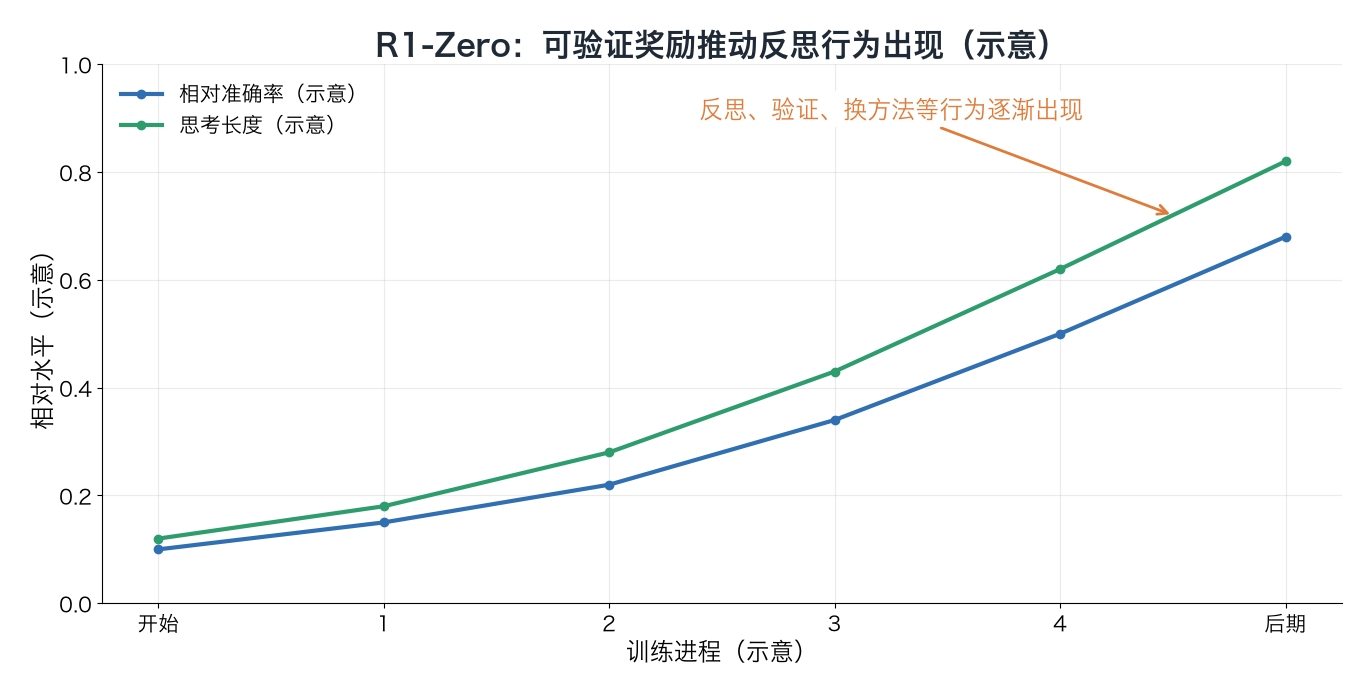
- AIME 2024 数学竞赛的单次答对率从 15.6% 提升到 71.0%;用多数投票后达到 86.7%,与 OpenAI o1-0912 相当(论文另一处表述为超过 o1-0912)。
- 随着训练进行,模型的回答越来越长,自发学会了反思、验证、尝试不同方法。
- 论文记录了一个「aha moment(顿悟时刻)」:模型在思考中途写出「Wait, wait. Wait. That's an aha moment I can flag here.」,然后回头重新检查。这是没人教过的行为。
(图中曲线只有起点和终点是论文数据,中间为示意。)
R1-Zero 的问题:可读性差,中英文混杂。
06DeepSeek-R1 的完整流程
为了解决这些问题,正式的 R1 采用多阶段训练:
- 冷启动 SFT:先用少量高质量、可读的长思维链数据微调;
- 推理强化学习:GRPO + 可验证奖励,并加入「语言一致性奖励」减少语言混杂;
- 拒绝采样 + SFT:用 RL 模型生成大量答案,只保留正确且可读的,再混入通用数据重新微调;
- 全场景 RL:兼顾推理能力和有用性、无害性。
此外,用 R1 生成的数据去微调更小的模型(蒸馏),小模型也能获得不错的推理能力。
07测试时算力:另一条扩展曲线
第 9 讲(预训练与规模定律)的规模定律说的是训练时多花算力。推理模型展示了另一条路:使用时多花算力也能换效果。
两种主要方式:
- 想得更长:更长的思维链(推理模型的方式);
- 想很多次:采样多个答案,多数投票或用验证器挑最好的(第 19 讲(自洽性与思维树)的自洽性)。
多数投票的小例子:同一题采样 5 次,得到 9、9、8、9、6 → 投票选 9。即使单次只有 60% 的概率答对,只要错误答案比较分散,投票后正确率会更高。OpenAI 介绍 o1 时报告:AIME 2024 上每题采样 1 次平均答对 74%,64 次采样取共识 83%,用学到的打分函数从 1000 个样本里重排后达到 93%;并称性能随训练时 RL 算力和测试时思考时间两者都平滑提升。研究(Snell 等,2024)还发现,在一定条件下,把算力花在测试时比把模型做大更划算。代价:更慢、更贵,简单问题也长篇思考会浪费 token(「过度思考」)。
- 1同一个问题保持任务不变
- 2更长思维链多检查几轮
- 3多次采样投票或用验证器筛选
- 4输出答案用更多计算换可能更高准确率
测试时增加计算会提高延迟和费用,简单问题不一定值得这样做。
08延伸阅读
- DeepSeek-AI, DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning, 2025:arxiv.org
- Shao et al., DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models, 2024(提出 GRPO):arxiv.org
- Snell et al., Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters, 2024:arxiv.org
- Wang et al., Self-Consistency Improves Chain of Thought Reasoning in Language Models, 2022:arxiv.org
- OpenAI, Learning to reason with LLMs, 2024:openai.com
09一分钟讲给别人
试着用自己的话讲一遍推理模型会在回答前生成长长的思考过程,这种习惯是通过强化学习练出来的。数学和代码的答案可以自动检查,所以可以用规则奖励来训练,不容易被钻空子。GRPO 对同一道题采样一组回答,用组内均值和标准差计算每个回答的优势,省掉了价值模型。DeepSeek-R1-Zero 只靠这种 RL,AIME 正确率从 15.6% 升到 71.0%,并自发学会反思;正式版 R1 加入冷启动数据和多阶段训练,改善了可读性。推理时多花算力,多想或想多次,也能换来更好的效果。
5 道自测
先在心里答一遍,再展开对照。能说清理由,比答对数字更重要。
01什么是可验证奖励?举两个例子。
02一组 4 个回答的奖励是 [1, 1, 0, 0],每个回答的 GRPO 优势是多少?
03为什么全对或全错的题目对 GRPO 没有帮助?
04R1-Zero 有什么问题?R1 是怎么解决的?
05什么是测试时算力扩展?代价是什么?
已看 0/5 题
练动手练习
在任意 AI 聊天工具里,给出一道需要两三步计算的题,记录它第一次的答案和检查过程。再追问“请换一种方法验证”,比较它是否会发现或排除错误,并标出哪些步骤可以用规则自动检查。
完成这一课
读完讲义、看完自测答案,这一课就算学完了。
- 读完讲义
- 看完全部自测
本课为投资者教育内容,案例数字均为示意,不构成任何投资建议,也不承诺收益。规则和费率会变,实际操作前请以交易所、监管机构和产品的最新公告为准。