01学完你能做到
知道同一个问题为什么每次回答不一样,以及 temperature、top-p 这些参数在调什么。
02模型输出的是「概率表」,不是一个词
第 4 讲(词向量与语言模型)说过,每一步模型输出的是整个词表上的概率分布。从这张表里挑出一个 token 的方法叫解码策略。挑法不同,结果就不同。
本节用一个统一的小例子。输入「我最喜欢吃的水果是」,模型给出 4 个候选的原始分数(logits):
| 候选 | 苹果 | 香蕉 | 西瓜 | 石头 |
|---|---|---|---|---|
| logit | 2.0 | 1.0 | 0.5 | 0.1 |
| softmax 后概率 | 0.575 | 0.211 | 0.128 | 0.086 |
(数字是示意,概率按 softmax 计算。真实词表有十几万项,「石头」代表那些不合理但概率不为零的长尾。)
03确定性解码
贪心解码
每一步都选概率最高的。这里选「苹果」。
- 优点:简单、确定,每次结果一样。
- 缺点:眼前最优不等于整体最优;长文本里容易陷入重复循环(「我很好。我很好。我很好……」)。
束搜索(beam search)
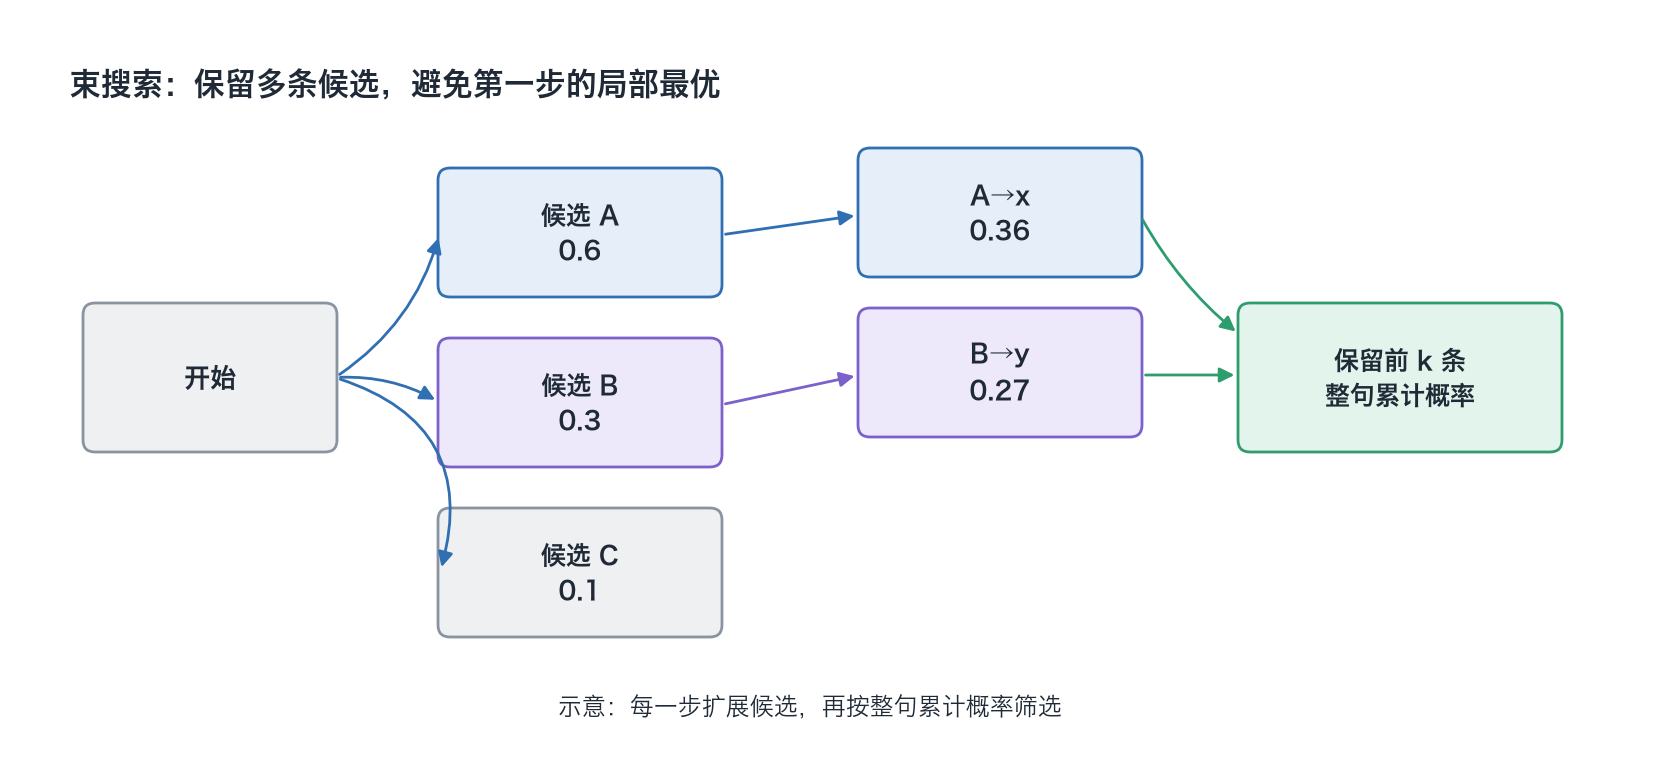
同时保留 k 条概率最高的「候选句子」(k 叫束宽),每步扩展后再保留最好的 k 条。
走读演示(束宽 2,句子开头「我」):
- 第 1 步:「今天」0.5,「刚才」0.4。贪心只留「今天」;束搜索两条都留。
- 第 2 步:
- 今天 → 很忙 0.4:整句 0.5 × 0.4 = 0.20
- 今天 → 吃饭 0.3:0.5 × 0.3 = 0.15
- 刚才 → 到家 0.9:0.4 × 0.9 = 0.36
- 刚才 → 说了 0.1:0.4 × 0.1 = 0.04
- 贪心得到「我今天很忙」(0.20);束搜索找到「我刚才到家」(0.36),整句概率更高。
束搜索在翻译、摘要这种「答案比较确定」的任务上好用;但在开放式写作、对话中,它倾向于生成平淡、重复、过于常见的文本。
04文本退化:为什么不能总选「最可能」
Holtzman 等人(2019)的论文《The Curious Case of Neural Text Degeneration》发现:用贪心或束搜索做开放式生成,文本会变得乏味、重复;而人类写的文本,每个词往往并不是模型眼中概率最高的那个。人类语言本身就有「意外」。所以开放式生成需要随机采样:按概率抽签。
05随机采样与 temperature
纯采样:按概率抽签。苹果 57.5% 的机会,石头也有 8.6% 的机会。问题是:长尾里不合理的词加起来概率不小,每一步都有可能抽到怪词,一错就会跑偏。
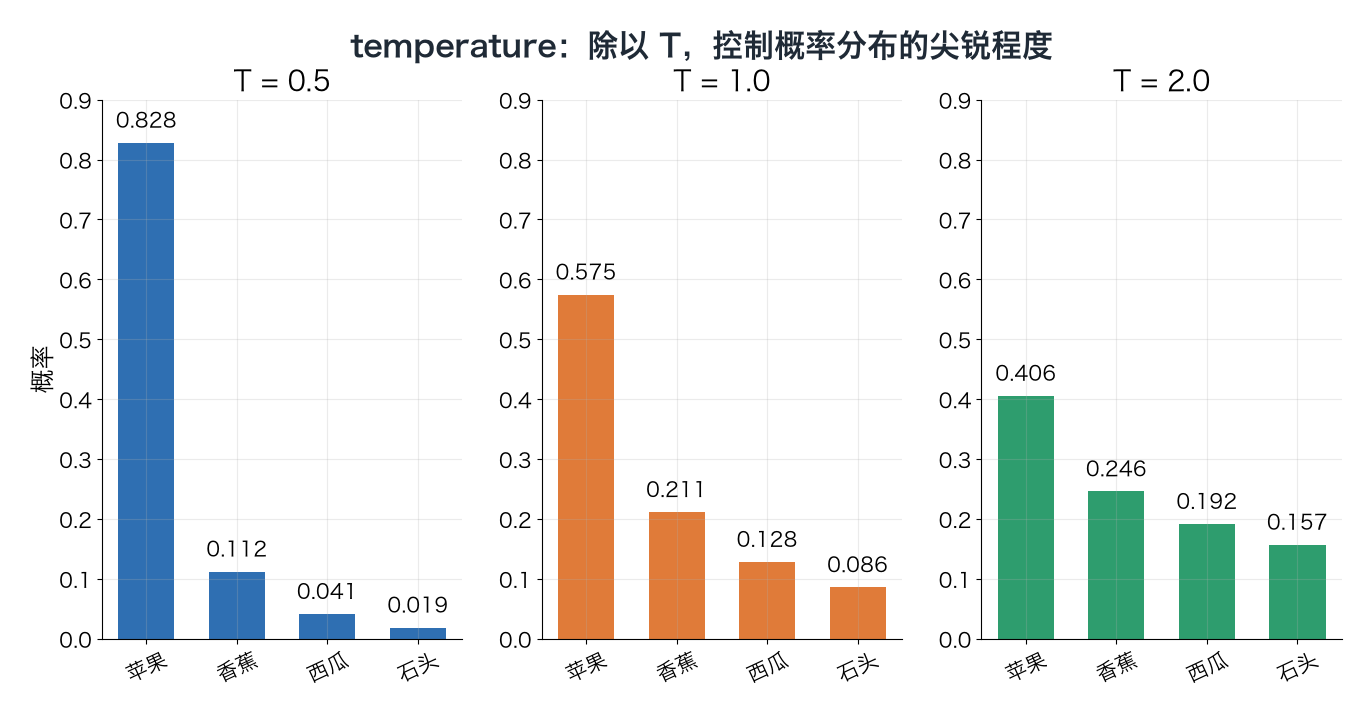
temperature(温度):在 softmax 之前把 logit 除以 T,用来调节分布的「尖锐」程度。
数值演示:
- T = 0.5:logit 变成 [4, 2, 1, 0.2] → 概率 [0.828, 0.112, 0.041, 0.019]。苹果占绝对优势,输出稳定。
- T = 1:不变,[0.575, 0.211, 0.128, 0.086]。
- T = 2:logit 变成 [1, 0.5, 0.25, 0.05] → [0.406, 0.246, 0.192, 0.157]。分布变平,「石头」的机会翻了快一倍,更有创意但也更容易胡说。
- T → 0:等价于贪心。
经验:写代码、提取信息、回答事实题用低温(0–0.3);写创意文案、头脑风暴用较高温度(0.7–1.0)。
06top-k 与 top-p:先砍掉长尾,再抽签
top-k
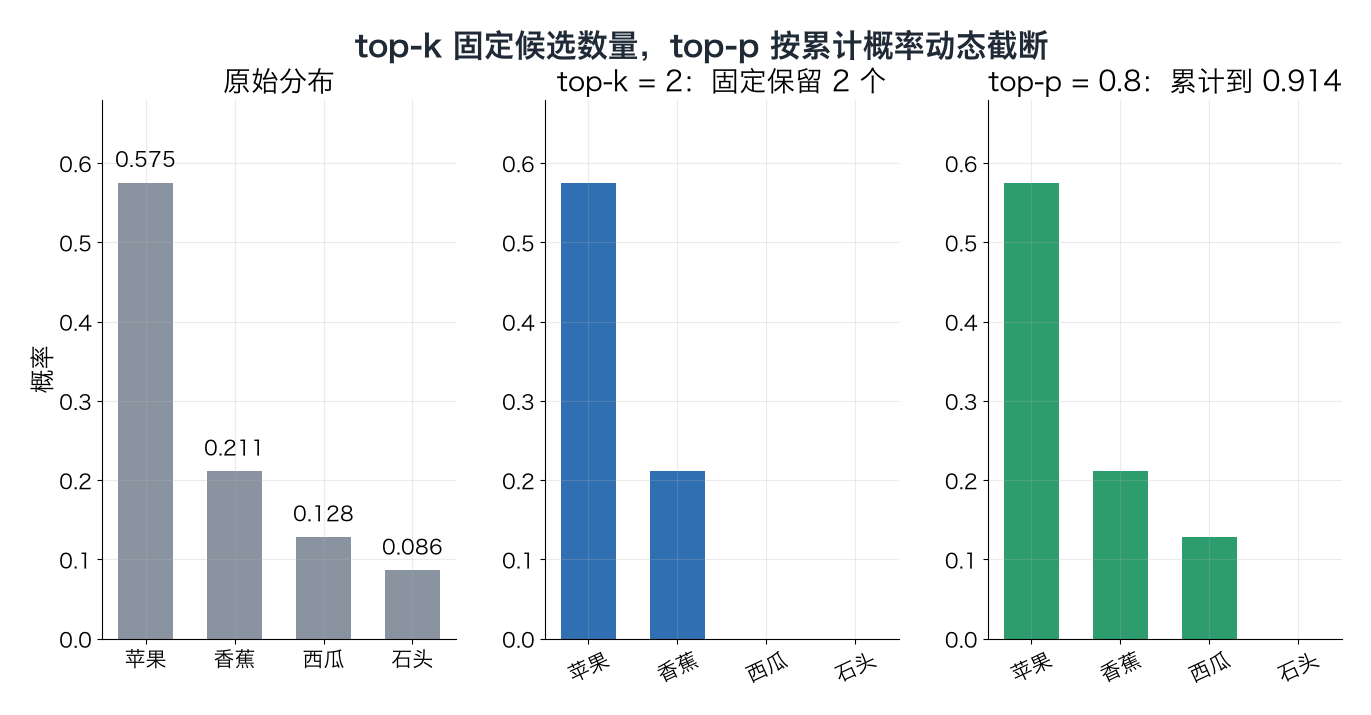
只保留概率最高的 k 个,重新归一化后再抽。演示(k = 2):保留苹果 0.575、香蕉 0.211,总和 0.786。重新归一化:苹果 0.575/0.786 ≈ 0.73,香蕉 ≈ 0.27。「石头」被彻底排除。缺点:k 是固定的。模型非常确定时(第一名占 99%),k=50 仍然放进了 49 个垃圾;模型很不确定时(几百个词都合理),k=50 又太少。
top-p(核采样,nucleus sampling)
按概率从高到低累加,累计概率刚达到 p 时停止,只在这些词里抽。演示(p = 0.8):
- 苹果:累计 0.575 \< 0.8,继续;
- 香蕉:累计 0.786 \< 0.8,继续;
- 西瓜:累计 0.914 ≥ 0.8,停止。
- 候选集 = \{苹果、香蕉、西瓜\},归一化后再抽。「石头」被排除。
好处:候选数量自动适应模型的确定程度。确定时只剩一两个,不确定时保留更多。这是 Holtzman 论文提出的方法,也是今天最常用的。
重复惩罚(repetition penalty)
很多推理框架还提供「重复惩罚」:已经出现过的 token,把它的 logit 打个折再算概率。演示:惩罚系数 1.2,「苹果」前文出现过,logit 2.0 → 2.0/1.2 ≈ 1.67,概率从 0.575 降到约 0.49。这样能减少「我很好。我很好。」式的循环,但设太大会让模型连该重复的专有名词都不敢重复。
常见组合
实际中常是:temperature 先调整分布 → top-k / top-p 截断 → 抽样。很多 API 建议只调 temperature 或 top_p 中的一个,不要两个一起大幅改动。
- 1得到 logits模型输出分数
- 2调整温度改变分布尖锐度
- 3截断长尾top-k 或 top-p
- 4随机抽样选出下一个 token
实际接口可能组合这些步骤,参数含义要以具体实现为准。
07回到开头的问题
同一个问题为什么每次回答不一样? 因为默认用的是随机采样(temperature > 0)。第一个词抽得不同,后面的上下文就不同,答案会越走越远。即使 temperature = 0,在实际服务中也可能有微小差异(批处理、浮点运算顺序等工程原因)。这种随机性也有用处:第 13、19 讲的「采样多次再投票」正是靠它产生不同的解题路径。
08延伸阅读
- Holtzman et al., The Curious Case of Neural Text Degeneration, 2019(提出 top-p 核采样):arxiv.org
- Hugging Face 博客 How to generate text: using different decoding methods for language generation with Transformers:huggingface.co
09一分钟讲给别人
试着用自己的话讲一遍模型每一步输出整个词表的概率,解码策略决定从中挑哪个词。贪心每次选最大的,束搜索同时保留几条候选句,适合翻译摘要,但开放式写作会乏味、重复,所以要随机采样。temperature 把分数除以 T:低温更确定,高温更多样也更容易胡说。top-k 只在前 k 个里抽,top-p 在累计概率达到 p 的最小集合里抽,候选数量能自动适应。默认在采样,所以同一个问题每次回答不同。
5 道自测
先在心里答一遍,再展开对照。能说清理由,比答对数字更重要。
01在本节例子中,贪心解码选哪个词?
02temperature 从 1 调到 0.5,分布变尖还是变平?
03概率 [0.5, 0.3, 0.15, 0.05],top-p = 0.9 时候选集有几个词?
04top-k = 1 等价于什么?
05写一个从合同中抽取金额的程序,temperature 应该设高还是低?为什么?
已看 0/5 题
练动手练习
在任意 AI 聊天工具里,连续三次提交同一个不涉及隐私的问题,记录回答的相同点和不同点。若工具提供 temperature、top-k 或 top-p,先只调一个参数再重复三次;没有这些选项,就用“更确定”或“更多样”的文字要求做对照。
完成这一课
读完讲义、看完自测答案,这一课就算学完了。
- 读完讲义
- 看完全部自测
本课为投资者教育内容,案例数字均为示意,不构成任何投资建议,也不承诺收益。规则和费率会变,实际操作前请以交易所、监管机构和产品的最新公告为准。