01学完你能做到
明白「大」为什么有用、有多大用,以及钱该花在模型上还是数据上。
02预训练在做什么
预训练就是第 4 讲(词向量与语言模型)的「预测下一个 token」,只不过规模巨大:
- 数据:网页、书籍、百科、代码、论文……经过去重、过滤低质量和有害内容、平衡语言和领域,通常有数万亿 token。
- 模型:第 8 讲(Transformer 整体结构)的 Transformer,参数从几十亿到上万亿。
- 算力:几千到上万块 GPU 连续训练数周到数月。
产出的叫基座模型(base model):它很会「续写」,但还不会好好「回答问题」。你问它「法国首都是哪?」,它可能接着写出「德国首都是哪?意大利首都是哪?」,因为网上的考卷常长这样。把它变成助手是下一节的事。
算力怎么估:C ≈ 6 × N × D
一个常用的粗略公式:训练总计算量(浮点运算次数)≈ 6 × 参数量 N × 训练 token 数 D。(直觉:每个 token 前向约 2N 次运算,反向约 4N 次。)
数值演示:
- Gopher:6 × 2800 亿 × 3000 亿 ≈ 5.0 × 10²³
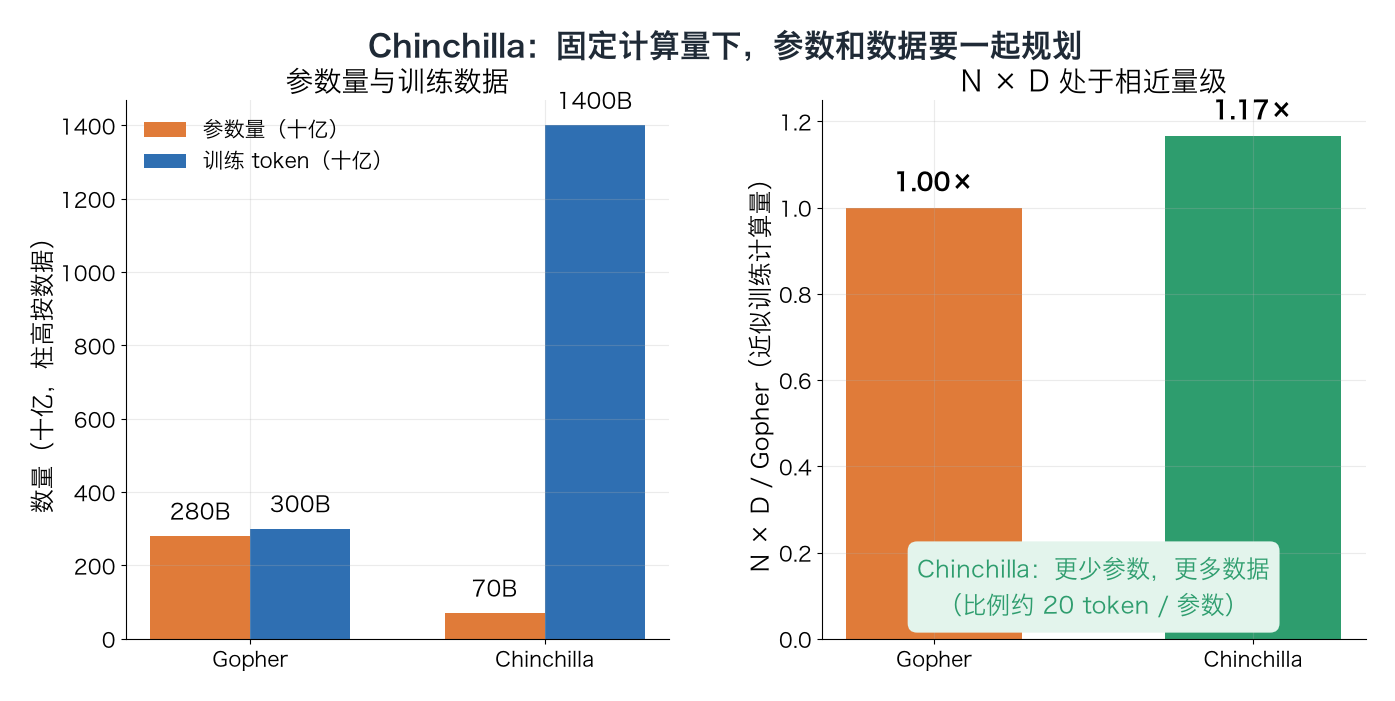
- Chinchilla:6 × 700 亿 × 1.4 万亿 ≈ 5.9 × 10²³
两者算力预算差不多,但分配方式完全不同(见第 3 部分)。
03规模定律(Scaling Laws)
2020 年 OpenAI 的 Kaplan 等人做了大量实验,发现:测试损失随模型参数量、数据量、算力的增加,呈非常规律的幂律下降,跨越好几个数量级都成立。
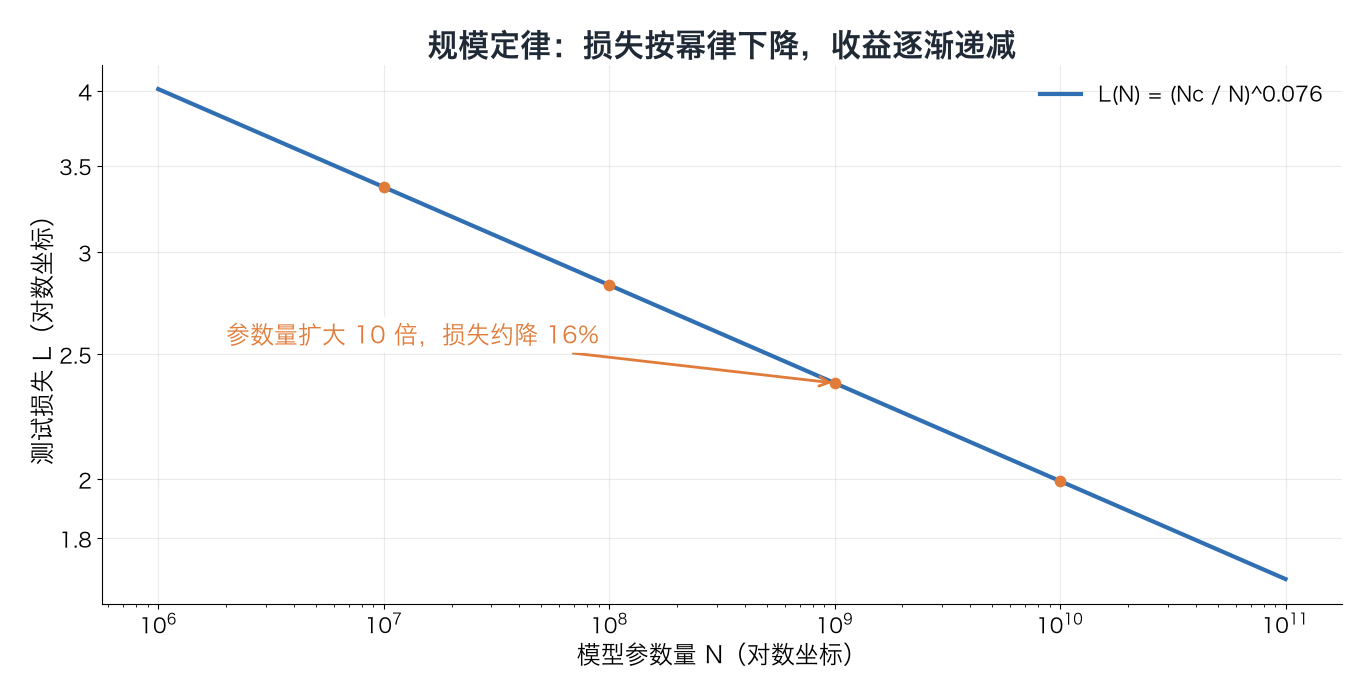
论文中参数量的拟合形式是 L(N) = (N_c / N)\^α,其中 α ≈ 0.076,N_c ≈ 8.8 × 10¹³(不含嵌入层的参数)。(这两个数来自论文中的拟合结果。)
数值演示:放大 10 倍能换来多少?
- N = 10 亿:L = (8.8×10¹³ / 10⁹)\^0.076 = (88000)\^0.076 ≈ 2.38
- N = 100 亿:L = (8800)\^0.076 ≈ 1.99
- 每放大 10 倍,损失乘以 10\^(−0.076) ≈ 0.84,即下降约 16%。
这说明两件事:
- 可预测:用小模型做实验,就能比较准地预测大模型的效果,这让公司敢投巨资训练大模型。
- 收益递减:每降低同样比例的损失,成本要再翻 10 倍。
在对数坐标下是一条直线,在普通坐标下则是一条越来越平的曲线。
04Chinchilla:模型和数据要一起长
Kaplan 的结论被当时的业界解读为「优先把模型做大」,于是出现了很多参数巨大、但数据相对少的模型。2022 年 DeepMind 的 Chinchilla 论文重新做了实验:训练了 400 多个模型(7000 万到 160 多亿参数,50 亿到 5000 亿 token),结论是:
在固定算力下,参数量和训练 token 数应该等比例增长:模型大一倍,数据也要多一倍。大致的经验法则是每个参数约 20 个 token。
对比演示(同样的算力预算):
| 模型 | 参数 | 训练 token | 每参数 token |
|---|---|---|---|
| Gopher | 2800 亿 | 3000 亿 | ≈1.1 |
| Chinchilla | 700 亿 | 1.4 万亿 | ≈20 |
结果:Chinchilla 小了 4 倍,却全面超过 Gopher(280B)、GPT-3(175B)、Megatron-Turing NLG(530B)等更大的模型,MMLU 平均准确率达 67.5%,比 Gopher 高 7 个百分点以上。而且模型小,推理(使用)时也便宜得多。
今天的延伸:模型训练一次,却要被调用亿万次。所以很多公司故意把小模型训练远超 20 token/参数(比如几百甚至上千),多花训练钱,换取更便宜的推理。「Chinchilla 最优」是训练算力最优,不是总成本最优。
05涌现与 few-shot
上下文学习(In-context learning)
GPT-3 论文(2020,1750 亿参数)的标题就是「语言模型是少样本学习者」。它发现:不用改任何参数,只要在提示里给几个例子,模型就能照着做新任务。
- Zero-shot:只给任务描述;
- One-shot:给 1 个例子;
- Few-shot:给几个例子。
GPT-3 论文观察到:模型越大,从例子里「现学」的能力越强,小模型多给例子几乎没用。(第 17 讲(Zero-shot 与 Few-shot)会专门讲怎么写 few-shot 提示。)
- Zero-shot只给任务说明
- One-shot给一个示例
- Few-shot给几个示例
涌现能力
Wei 等人(2022)把这类现象称为涌现:某些能力(如多位数加法、多步推理)在小模型上接近随机,过了某个规模突然明显变好。
但要谨慎:Schaeffer 等人(2023)指出,很多「突然涌现」是评测方式造成的。比如用「完全答对才得分」的指标,模型能力其实在平滑提高(每一位数字都越来越准),但只有全部数位都对才计分,曲线看起来就像突然跳起。换成平滑的指标,跳跃往往消失。结论:「大了会出现新能力」大体是对的,但「突然」和「不可预测」可能被夸大了。
06规模之外
- 数据质量比单纯数量更重要:去重、过滤、配比(代码、数学数据对推理帮助大)。
- 数据快用完了:高质量公开文本是有限的,于是出现了合成数据、多轮训练等方向。
- 规模不是唯一的路:第 13 讲(推理模型)会讲「推理时多花算力」,这是另一条扩展曲线。
07延伸阅读
- Kaplan et al., Scaling Laws for Neural Language Models, 2020:arxiv.org
- Hoffmann et al., Training Compute-Optimal Large Language Models(Chinchilla), 2022:arxiv.org
- Brown et al., Language Models are Few-Shot Learners(GPT-3), 2020:arxiv.org
- Wei et al., Emergent Abilities of Large Language Models, 2022:arxiv.org
- Schaeffer, Miranda & Koyejo, Are Emergent Abilities of Large Language Models a Mirage?, 2023:arxiv.org
08一分钟讲给别人
试着用自己的话讲一遍预训练就是在海量文本上做「预测下一个 token」,产出一个会续写但还不会当助手的基座模型,训练算力约等于 6 乘参数乘 token 数。规模定律发现损失随参数、数据、算力按幂律平滑下降,参数每放大 10 倍损失约降 16%,既可预测又收益递减。Chinchilla 指出模型和数据应等比例增长,约每参数 20 个 token,70B 的 Chinchilla 打败了 280B 的 Gopher。大模型还会通过提示里的几个例子现学新任务,即 few-shot;所谓涌现,部分是评测指标造成的错觉。
5 道自测
先在心里答一遍,再展开对照。能说清理由,比答对数字更重要。
01基座模型和聊天助手的区别是什么?
02用 C ≈ 6ND 估算:70 亿参数、2 万亿 token 的训练量是多少?
03按 Kaplan 的拟合,参数放大 100 倍,损失变为原来的多少?(10\^(−0.152) ≈ 0.70)
04按 Chinchilla 经验,100 亿参数的模型大约该训练多少 token?
05为什么有人认为「涌现」可能是错觉?
已看 0/5 题
练动手练习
让 AI 用同一个任务分别做 zero-shot、one-shot 和 few-shot 三次:第一次只给任务说明,第二次给一个例子,第三次给三个例子。记录三次答案的变化,并思考“例子真的教会了模型什么”,还是只是帮助它识别了输出格式。
完成这一课
读完讲义、看完自测答案,这一课就算学完了。
- 读完讲义
- 看完全部自测
本课为投资者教育内容,案例数字均为示意,不构成任何投资建议,也不承诺收益。规则和费率会变,实际操作前请以交易所、监管机构和产品的最新公告为准。